我如何逃离 AI 自动驾驶
原文:How I Escaped AI Autopilot
作者:Katie Parrott | 2026-11-03
备注:本文为 Every 重发的 Katie Parrott 四月文章。
在我设想 AI 可能改变我职业生涯的各种方式里,“忘记自己已经做过这项任务”并不在清单上。
我已经把一篇关于南美招聘最佳实践的文章完成稿发给了客户,然后碰巧又读了一遍需求简报。一个熟悉的说法让我意识到,我之前读过这份简报。接着是那个我相当确定自己已经核查过的统计数据。我往回翻查文件,果然找到了:同一个客户、同一个主题、同一份交付物,日期是四周前。它已经完成、归档,并被忘得如此彻底,以至于当一次文书错误把同一份简报又发到我收件箱时,我坐下来把整件事从头做了一遍。
我的第一个念头是,这大概是某种早发性疾病的征兆,我该给医生打电话。第二个更理性的念头是:我没有失去理智——但我把它外包出去了。我一直走得太快,把太多工作交给 AI,以至于我的大脑甚至懒得储存“完成过这项任务”的记忆。
最让我害怕的,是想到那些更小的时刻——那些我没能察觉自己的时刻。
这种外包并不新鲜。很多人都承认,在没有手机可依赖的情况下,在一个陌生城市里会感到迷失;而我这个人,能记住自己的电话号码就算走运,更别说别人的了。但 AI 不只是替你分担工作;它会介入那些你过去亲自做出的判断。
我最不可能去责备别人使用 AI。我已经把 AI 融入我工作的几乎每个部分,它帮助我写得更严谨、研究得更彻底,也让我承接了远超我过去所谓能力范围的项目。但当你无意中卸载了错误的部分——比如像我这次一样,完全理解文章的目的和意图——你就有可能让对自己最重要的技能萎缩。你甚至可能把自己的名字放在一份工作上,却没有意识到自己并不真正认同它,直到别人开始提问。如果你把 AI 用于任何类型的定性工作,比如写作策略、市场营销、传播,我敢打赌你也在以某种形式做同样的事。理解它为什么会发生,是决定你想把哪些工作收回来的第一步。
当信任工具变成一件坏事
有一群人立刻就能理解这种事:航空公司飞行员。
20 世纪 90 年代,研究自动化驾驶舱的研究人员开始注意到一个奇怪模式。拥有数千飞行小时、肩负乘客生命的飞行员,有时会遵循错误的自动化建议,即便眼前的仪表显示有些不对劲。自动化系统正确的时候足够多,以至于他们的大脑不再用同样挑剔的眼光去交叉核对它。
2010 年一篇回顾数十年自动化研究的综述描述了一个更大的模式:自动化系统越可靠,人类就越可能让它未经检查地通过。当一个系统通常是对的,你的注意力就会开始把它当作会一直对下去。
AI 是我们大多数人一天中接触到的最流畅的自动化系统。而流畅本身也有自己的把戏。1999 年,两位心理学家向人们展示了内容完全相同的陈述,只是字体有的易读、有的难读。易读的陈述被评为更真实。同样的词、同样的主张,但读起来更顺畅的版本被判断为更准确。你的大脑会把“这处理起来很容易”错误归档为“这一定正确”。
AI 的输出读起来非常顺畅。它语法打磨得漂亮,语气自信,整洁的格式暗示着这东西已经被人编辑过。这种抛光感让你的眼神发直、不再细看。
每一次模型升级都会让“正确”的错觉更严重。输出更干净,格式更好,推理看起来更可信。工具犯的明显错误更少,这意味着剩下的错误更难看见。你正在读的东西看起来已经完成,而你的大脑——早在 AI 出现之前,它就一直把“看起来完成了”归档为“是正确的”——会顺从地接受这一点。
为什么“我会审查的”不是一个计划
在重复劳动那次乌龙之前,我会告诉你,我在发出任何东西之前都会审查一切。文件从我的视野里经过,我改了一个措辞,抓住一个奇怪的句子,然后感到一阵编辑美德带来的暖意。我的大脑把它归档为“已审查”。
制造“已经审查过”的感觉很容易。真正审查这个动作要难得多。你必须在模型给出观点之前形成自己的观点,核查各项主张,并注意到草稿在哪些地方做出了你并不认同的假设。你必须问自己:如果六个月后有人把这句话截图发回给我,我还会觉得它成立吗?
我们经常谈论更好的提示词、更好的模型、更好的工作流和更好的智能体。我们较少谈论那些应该慢下来的时刻——因为那让人不舒服,也很难做到。2021 年,研究人员测试了减少对 AI 过度依赖的方法。效果最好的干预措施是“认知强制函数”(cognitive forcing functions),也就是一些设计要求人们在看到或接受 AI 的答案之前先形成自己的判断。
同样的干预措施也得到了用户最差的评价。人们不喜欢被迫先思考。他们当然不喜欢。自动化的全部吸引力就在于它减少了努力。一个说“在我帮你之前,请先自己把难的部分做一分钟”的工具,感觉就像减速带。但减速带正是自动驾驶的解决方案。
我在尝试什么
我对自动驾驶的解决办法,不是放弃 AI,回到某个想象中的黄金时代,在那里我高贵地在一份空白的 Google Doc 里受苦。但我确实在改变自己处理和最终完成工作的方式,以遏制“先交付、后思考”的倾向。
改变 1:先想,再看
在让 AI 给我草稿之前,我会试着写下自己粗略的立场。它不是打磨过的版本,也不是完整论证。有时只是五条要点——某种组合,包括我认为什么、我知道什么、我不确定什么、我拒绝说什么,以及什么会让这篇文章有用。然后,当模型给我输出时,我就有了除“感觉”之外的东西可以用来对照。
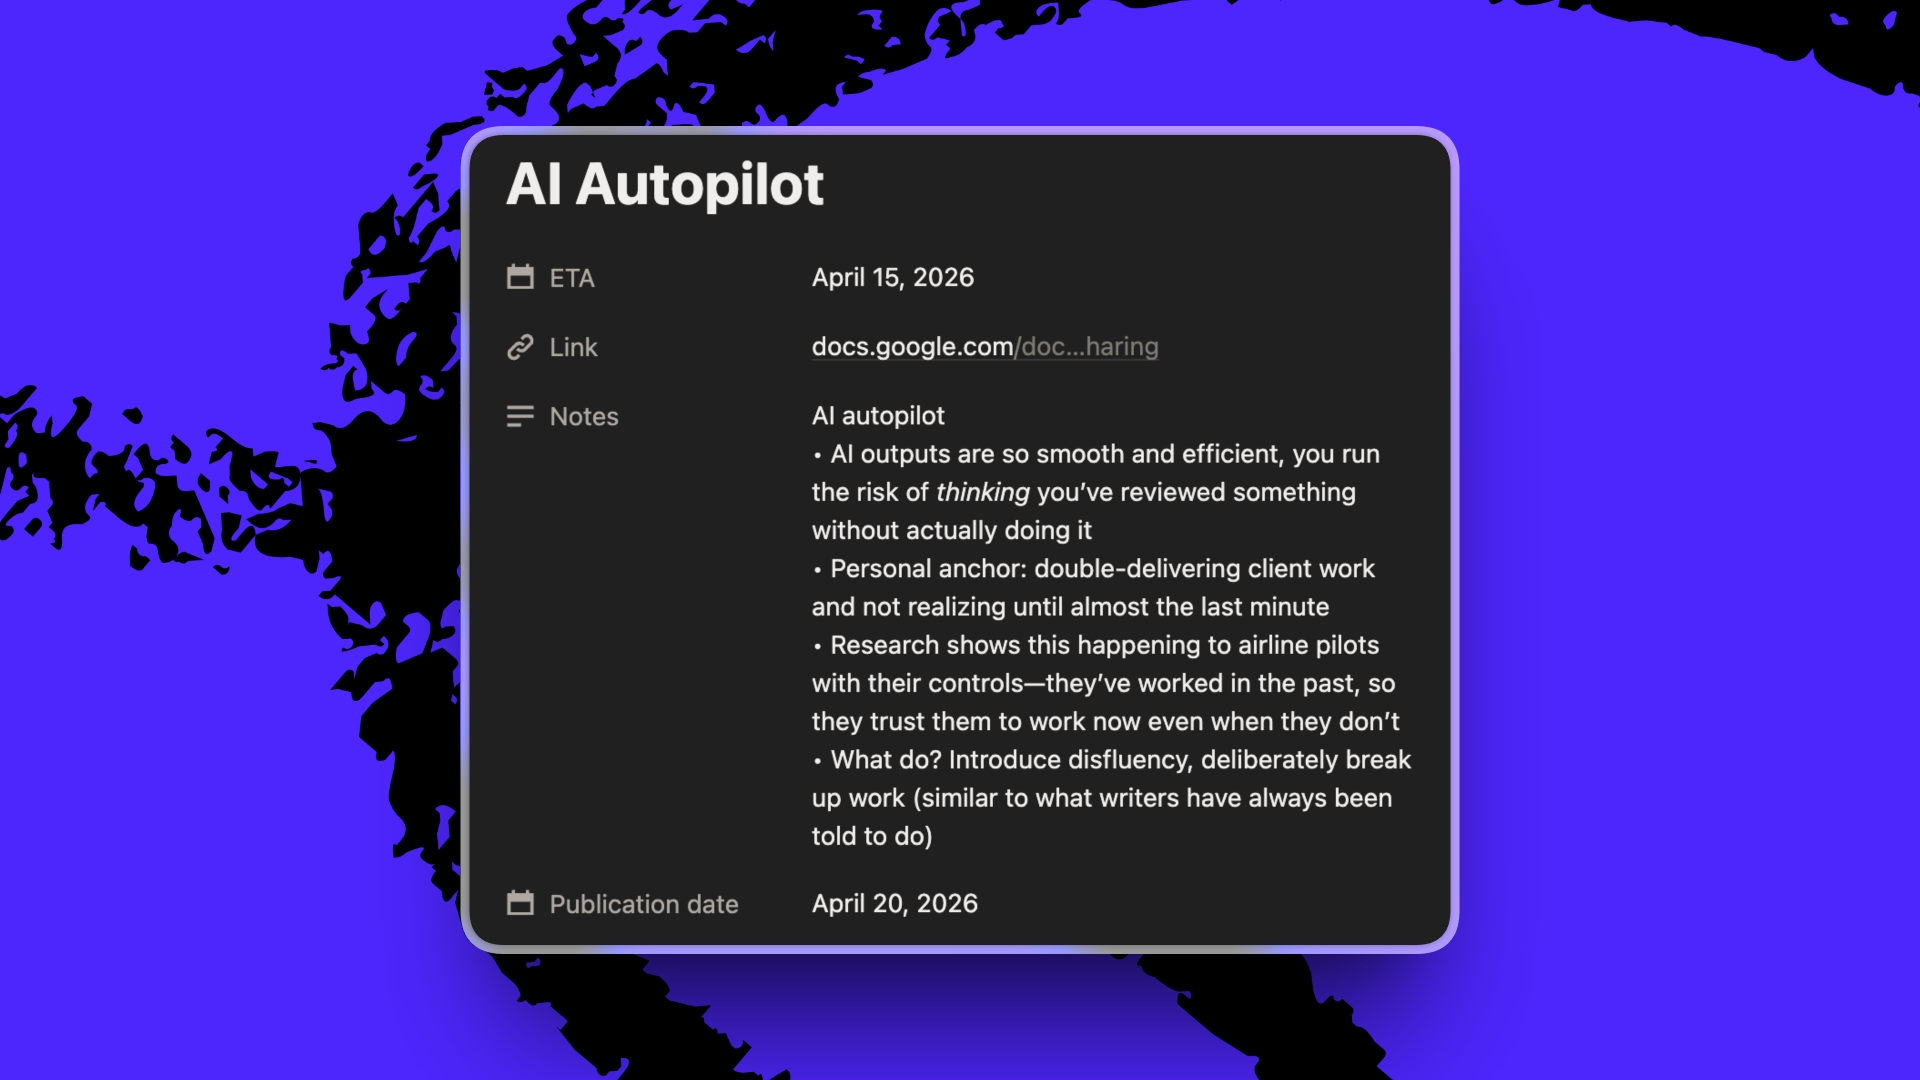
我在 Notion 待办清单里为这篇文章做的卡片,上面是我在与 AI 进行访谈式会话前快速写下的笔记。(图片由 Katie Parrott 提供。)
这很烦人。但它也有效。如果我先提出了自己的主张,我就会以不同的方式阅读 AI 的主张。我能感觉到它在哪些地方抹平了我很在意的区别。我能看出它在哪些地方借用了尚未获得的权威。草稿变成了一个可以与之争辩的对象,而不是一股可以随波逐流的洋流。
改变 2:制造一段间隔
如果注意力维持得越久就衰减得越厉害,那么是时候把注意力当作它本就稀缺的资源来对待,不再认为自己可以连续审查五份 AI 输出而毫无后果。答案是刻意引入摩擦——在生成和审查之间制造距离,让你的注意力有机会重置。周三起草,周四审查。早上写,下午再回来。把模型的输出发送到不同的界面——例如,从聊天界面转到文档,或从手机转到桌面——在你已经习惯的聊天窗口之外阅读它。
顺便说一句,这些建议很多归根结底都是写作老师推荐了几十年的最佳实践。不同的一天会给你一个不同的大脑,而不是那个因 AI 的生成过剩而兴奋的大脑。
改变 3:强迫自己解释为什么接受它
一项 2026 年关于 AI 辅助写作的研究发现,让用户在接受 AI 输出之前解释自己的推理,可以把错误接受大约减少一半。你没法对自己写下来的理由胡说八道。
所以我也开始这样做了。在我接受一个建议、一个框架,或模型起草的一段话之前,我会强迫自己写一句话回答一个具体问题:为什么这对这个客户、这个论证、这个读者来说是对的?如果我能给出的最好答案是“听起来不错”,我就回去再看一遍。我必须能够在编辑面前为每一句话辩护。
你仍然拥有输出
这些做法有帮助。但它们也只是对“让输出感觉毫不费力”的工具的一种脆弱防御,而且我不认为长期答案是指望每个人在早餐前咬紧牙关、硬闯过六种认知偏差。
这同时也是一个设计问题。工具本身应该把摩擦重新构建进来——让来源可见,把生成与批准分开,把人类判断当作一个工作流阶段,而不是最后那个仪式性的点击。这正是 Proof 让我兴奋的部分原因;Proof 是 Every 的文档编辑器,用于 AI 与人类协作,它会追踪哪些词是你的、哪些来自机器。研究人员发现那些能阻止我们的大脑向自动驾驶投降的认知强制函数,是应该被嵌入产品设计中的设计模式。
知道机制并不能让你豁免于机制。这个故事里的每一种偏差都比 AI 早了几十年。我们一直太快地信任流畅的东西,在似乎没有出问题时注意力变得更差,并且偏爱省力的路径。
那次重复的任务仍然让我难堪,尽管它最终让我付出的代价,只是和客户来回发了几封尴尬的邮件,确认自己没疯。我也感激它,就像你感激一个在真正损害发生之前到来的警告。它教会了我一件被研究进一步锐化的事:AI 辅助工作的核心风险,不是机器替你思考,而是机器让你感觉仿佛你已经思考过了。
我正在努力更好地注意到这种区别。对大多数文章,我会一天起草、另一天审查,在问模型怎么想之前先写下我怎么想,并希望这些摩擦足以让我留在工作里,而不是漂浮在它上面。
核心启示:AI 辅助工作的核心风险,不是机器替你思考,而是机器让你误以为自己已经思考过。
《How I Escaped AI Autopilot》的发芽报告
材料核心
Katie Parrott 从一次“重复完成同一份客户 brief”的荒诞经历出发,指出 AI 协作的真正风险不是机器替她思考,而是机器流畅的输出让她误以为自己已经思考、已经审阅。她借助航空自动化、认知流畅性与“认知强制函数”研究,提出三项减速实践,并强调:个人习惯之外,产品设计也必须把摩擦重新放回工作流。
发芽 01:自动化依赖不是“懒”,而是“监控技能”的慢性萎缩
种子
文章把问题定位为“autopilot”:越可靠的系统,越容易让人停止交叉检查。这里可以再往前推一步——自动化不仅接管任务,还会重塑人的技能结构。
Lisanne Bainbridge 在 1983 年的经典论文《Ironies of Automation》里提出过一个悖论:自动化越先进,操作员日常练习手动判断的机会越少;但系统一旦出现异常,又恰恰要求操作员具备更高的判断能力。航空自动化研究也呈现类似模式:当自动系统通常正确时,飞行员会降低对仪表的主动监控。文章中的作者并非“忘记了自己会写”,而是把“理解 brief 的意图”这一判断环节外包了出去。重复完成同一份 assignment,正是这种技能萎缩的滑稽显影:任务完成了,但完成任务的认知路径没有被记住。
这与文章的核心判断直接相连:危险不是“机器替你思考”,而是“机器让你感觉你已经思考”。Bainbridge 的解释让这句话更冷一层:感觉之所以能替代思考,是因为判断环节长期没有被练习。
Aha 瞬间
“自动化最隐蔽的代价,不是它替你做完了工作,而是它让你失去了在异常出现前练习判断的机会。”
发芽 02:从“记忆外包”到“判断外包”:重复 brief 是认知卸载的极端样本
种子
文章最有力的轶事,是作者完全忘记自己四周前已经完成过同一份工作。这个细节可以放进“认知卸载”的研究脉络里看。
Betsy Sparrow 等人 2011 年发表在《Science》上的“Google effects on memory”发现:当人们预期未来还能查到某条信息时,会更少记住信息本身,而更多记住“去哪里找”。Risko 与 Gilbert 2016 年对 cognitive offloading 的综述也指出,人会主动把认知负担转移到外部工具上。作者的经历是这一机制的加强版:她不是记住了“文件在哪里”,而是根本没有存储“我已经做过”这一行动记忆。
更关键的是,AI 把认知卸载从信息层推到了判断层。你不再需要记住论据、形成立场、追踪推理,因为模型总在附近生成一个看起来完整的版本。文章说 AI “steps into the judgment calls you used to make yourself”,这句话正好解释了为什么“我审过了”的感觉如此容易产生:你看到的是 polished output,而不是自己的推理轨迹。
Aha 瞬间
“当工具替你记住路径,你丢的是地图;当工具替你形成判断,你丢的是方向感。”
发芽 03:把“摩擦”设计进流程:认知强制函数为何有效却讨人厌
种子
文章提出三项做法:先写自己的立场再看 AI 草案、在生成与审阅之间制造时间差、接受输出前强迫自己写一句理由。这些不是简单的“自律建议”,而是认知强制函数的个人版。
Zana Buçinca 等人 2021 年的研究“To Trust or to Think”发现:让用户在看到 AI 建议前先形成自己的判断,能显著降低对 AI 的过度依赖;但同一批干预也获得了最差的用户评分——人们不喜欢被要求先思考。文章引用的 2026 年 AI 辅助写作研究也指向同一机制:要求用户解释接受理由,能把错误接受率砍掉大约一半。Robert Bjork 提出的“desirable difficulties”同样说明,适度的困难不是效率敌人,而是学习与判断得以稳固的条件。
Atul Gawande 在《The Checklist Manifesto》中记录的医疗清单也是同类设计:它不让手术更“顺手”,却强迫团队在关键节点暂停、确认、发声。文章最后说“This is also a design problem”,这正是关键——真正保护判断力的摩擦,不能只靠个人意志力硬撑,而要像清单一样被嵌入流程。Proof 试图追踪“哪些词是你的、哪些来自机器”,就是把 provenance 变成可见的摩擦。
Aha 瞬间
“真正保护判断力的摩擦,不能只靠个人意志力硬撑;它必须像手术清单一样,被设计成流程里非走不可的一步。”
你的思考空间
- 你最近一次“感觉审阅过”但说不清自己到底改了什么的工作是什么?如果必须写一句“我为什么接受它”,你会卡在哪里?
- 在你的工作流里,哪些环节属于“生成”,哪些属于“判断”?你是否习惯把两者放在同一个聊天窗口里连续完成?
- 如果团队要设计一个“认知强制函数”,你愿意接受哪种摩擦:先写立场、隔夜审阅、接受理由签名,还是把生成与审批拆到不同界面?哪种最容易被绕过?
- AI 让你更快完成的任务中,哪些技能是你未来仍想保留并刻意练习的?你能否为它们设计一个“低频但高强度”的练习场景?
- 当工具越来越流畅,你如何区分“正确”与“顺畅”?有没有一个可操作的反向信号,能提醒你“这只是读起来很顺”?