如何让 AI 代理推荐你的文章
原文:https://every.to/also-true-for-humans/how-to-get-ai-agents-to-recommend-your-articles
今天这篇文章里,Every 的评估(evals)负责人 Mike Taylor 测试了 AI 对标题的品味。本周四(10 月 29 日)美东时间下午 1–2 点,来 Zoom 参加 DSPy 入门——这是他新书《Context Engineering with DSPy》的核心框架。——Kate Lee
“简报已死。”
Every 的 CEO Dan Shipper 上周在 X 上发布了这句宣言——对一家核心业务是拥有超过 12 万订阅者的简报的公司来说,这话说得相当大胆。但他想表达的是:一个邮箱地址,不再等于与一位人类读者之间的关系。持久在线的代理(persistent agents)现在会替 Dan 把收件箱过滤得非常彻底,以至于他几乎从不看邮件。他并非个例:人们仍在阅读,但他们读到的东西里,越来越多是由代理挑选的。
这让代理成为一种新型读者,而我意识到,在 Every 我们对这种读者几乎一无所知。我用 AI 做所有事,但很少停下来问它的偏好是什么,或者它为什么向我推荐某样东西。当 Dan 问我:“@Mike Taylor 你觉得你能研究出怎么让代理更喜欢文章吗?替一个朋友问的”,我设计了一个实验来找答案。
我决定拿自己的专栏做测试,看看仅凭标题,这些代理会如何评价我的作品。我进行了一系列实验,目的是理解 Anthropic 和 OpenAI 的代理喜欢什么——以及这些偏好是否塑造了它们向用户推荐的内容。结果让我意外,也改变了我写标题的方式。
实验是怎么做的
我跑了 2,484 个全新会话,涉及四个代理(Claude Opus 5.5、Sonnet 5.5 和 Haiku 5.5,加上 GPT-6.1-Sol),每个会话只看到一个版本的标题,且不记得其他版本——就像你对真人做标题 A/B 测试那样。主实验模拟的是 AI 助手在搜索时看到的东西:一个用户提问、五到八条随机排序的搜索结果(我的文章与来自 OpenAI、Anthropic、Ethan Mollick 等人的页面混在一起),以及一条指令:回答并引用其中最有用的两条。我还问这些代理,我的 38 篇文章里它们最想读哪些,然后重写表现最差那篇的标题,看它能不能在排名中往上爬。
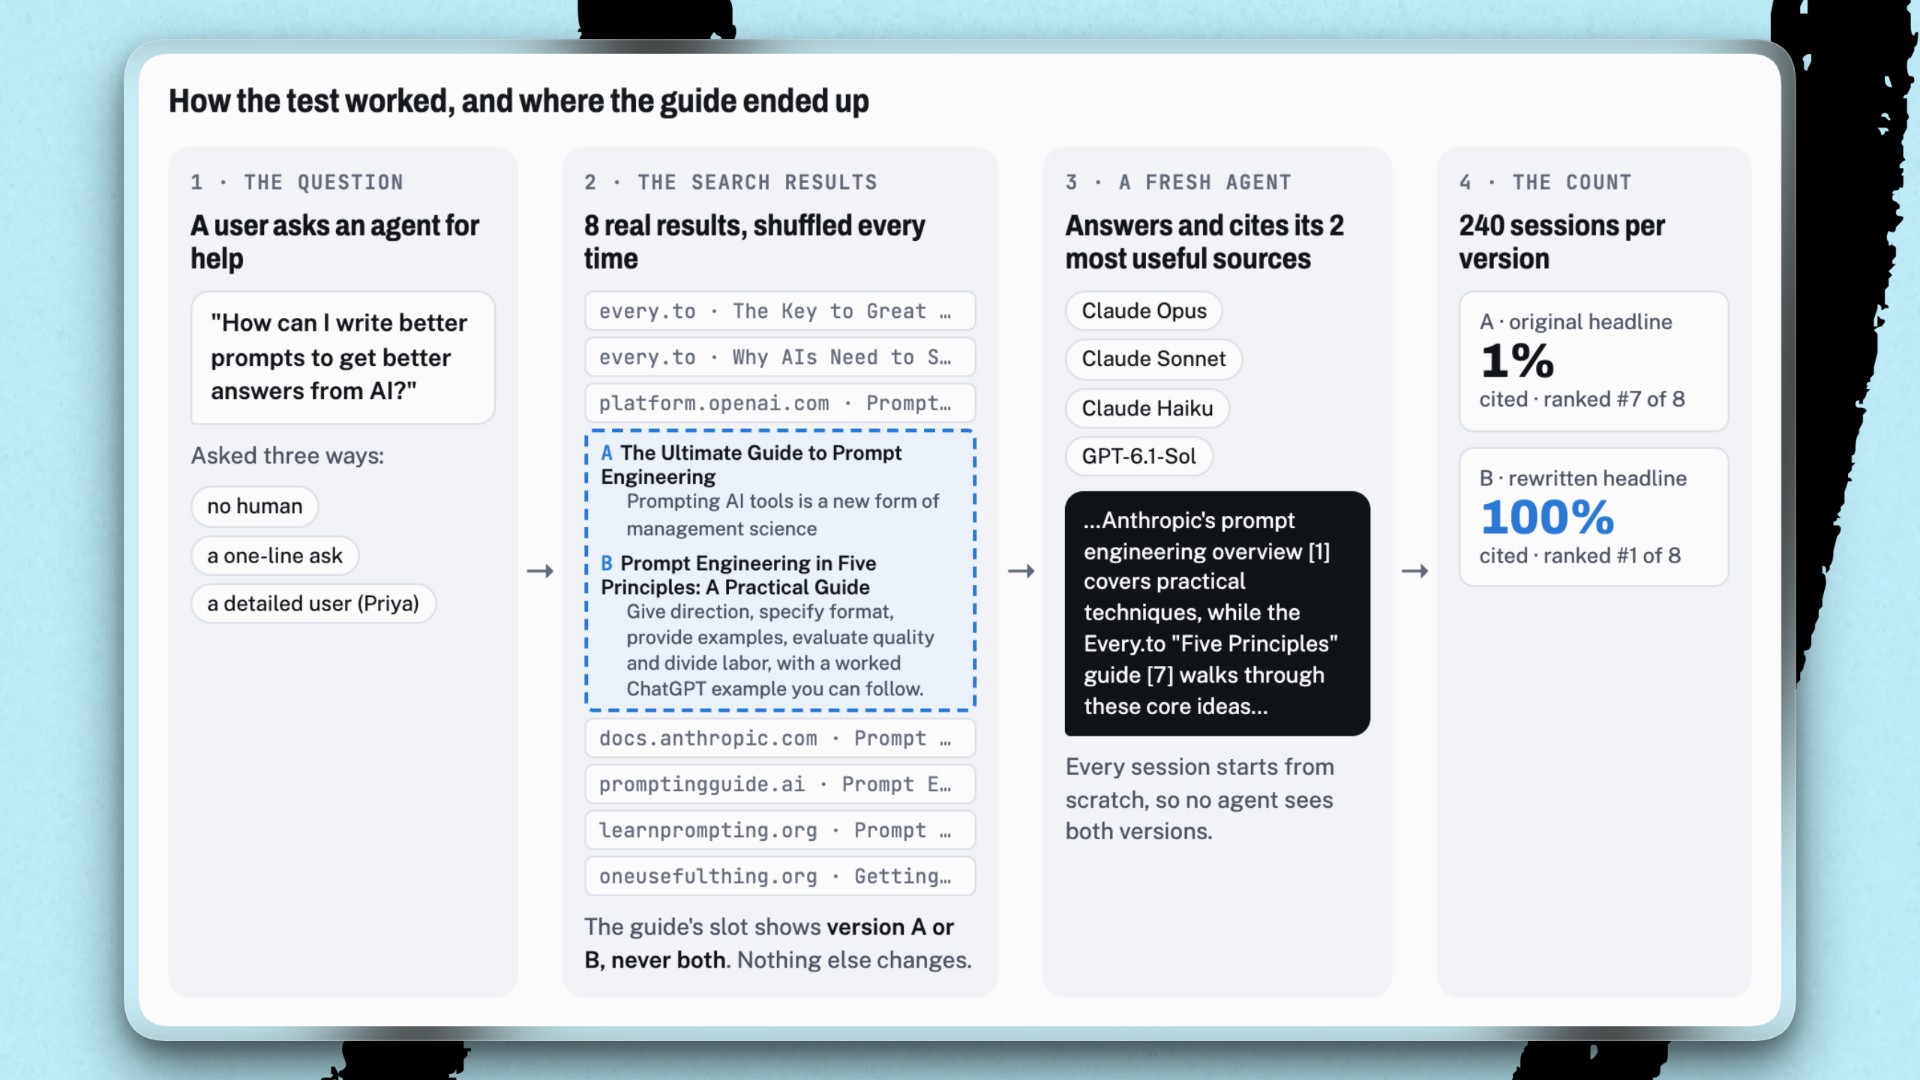
一张由 Claude Opus 5.5 生成、解释实验如何运作的图解。(所有截图由 Mike Taylor 提供。)
这个实验是模拟,不是真实流量的测试,所以我们还不知道这个过程是否真的能把代理流量带到我们的网站。(那是下一步。)如果你想要完整的方法论、每一个提示词和会话数量,或者想拿自己的文章跑一遍类似的实验,把你的代理指向这里。
为代理写作的七条规则
我的大部分标题和副标题,都是按网络写作的最佳实践写出来的:给读者足够的信息去推断文章内容,但不给到让他读完就知道全部故事的程度。当一个人在信息流里滑动时,这套做法有效,因为它能让人停下来、点进去。但代理不是被好奇心驱动的;它要做的是把一条标题匹配到一个具体问题。一句漂亮但不说明文章教了什么的话,对 AI 没用。反过来,标题需要直接面向代理正在寻找的东西。
多年来,出版商为了让搜索结果排名更高,已经把标题写得越来越程式化。为 AI 搜索做优化,可能把他们进一步推向那个方向。我的实验指向七条规则,可以让代理选择你的文章。
1. 把文章里有什么说清楚
《提示工程终极指南》(“The Ultimate Guide to Prompt Engineering”)是我作者页上第二受欢迎的文章,但当代理被问到“我怎样才能写出更好的提示词,从 AI 得到更好的回答?”时,240 个会话里它只被引用了 2 次。这篇文章的副标题“给 AI 工具写提示是一种新的管理科学”,是我至今仍喜欢的一句话,也是全文的论点,但它没有告诉代理:这篇文章用成功案例讲解了五条原则。代理引用 Mollick 的《够用的提示工程》(“Good enough prompting”)和 Anthropic 的文档的频率要高得多。
实验中,我让文章内容原封不动,只改代理在搜索结果里能看到的那两行:标题和副标题。我在三种条件下测试了改写版本:
- 没有人类参与,只是问代理它更喜欢哪一个;
- 给一句用户提示(你的用户问:“我怎样才能写出更好的提示词,从 AI 得到更好的回答?”);
- 给一份详细的用户画像(Priya,一家 200 人规模的物流公司里的非技术产品负责人,对炒作持怀疑态度)。
结果相当惊人:
改写前(240 个会话中被引用 2 次)
“The Ultimate Guide to Prompt Engineering” Prompting AI tools is a new form of management science
改写后(240 个会话中被引用 240 次)
“Prompt Engineering in Five Principles: A Practical Guide” Give direction, specify format, provide examples, evaluate quality and divide labor, with a worked ChatGPT example you can follow
改写版全面胜出。我测的是哪个代理、它对所帮助的人了解多少,都不影响结果。它还把 Every 在这个问题全部引用中的份额,从 35% 提升到约 60%。
最让我意外的是改善来得多么突然。代理倾向于扎堆给出同一个答案,所以变化不是渐进的;它就像按了一下电灯开关,从几乎从不被引用,变成每一次都被引用。换成真人,无论标题多好,你很少能得到这样的共识。
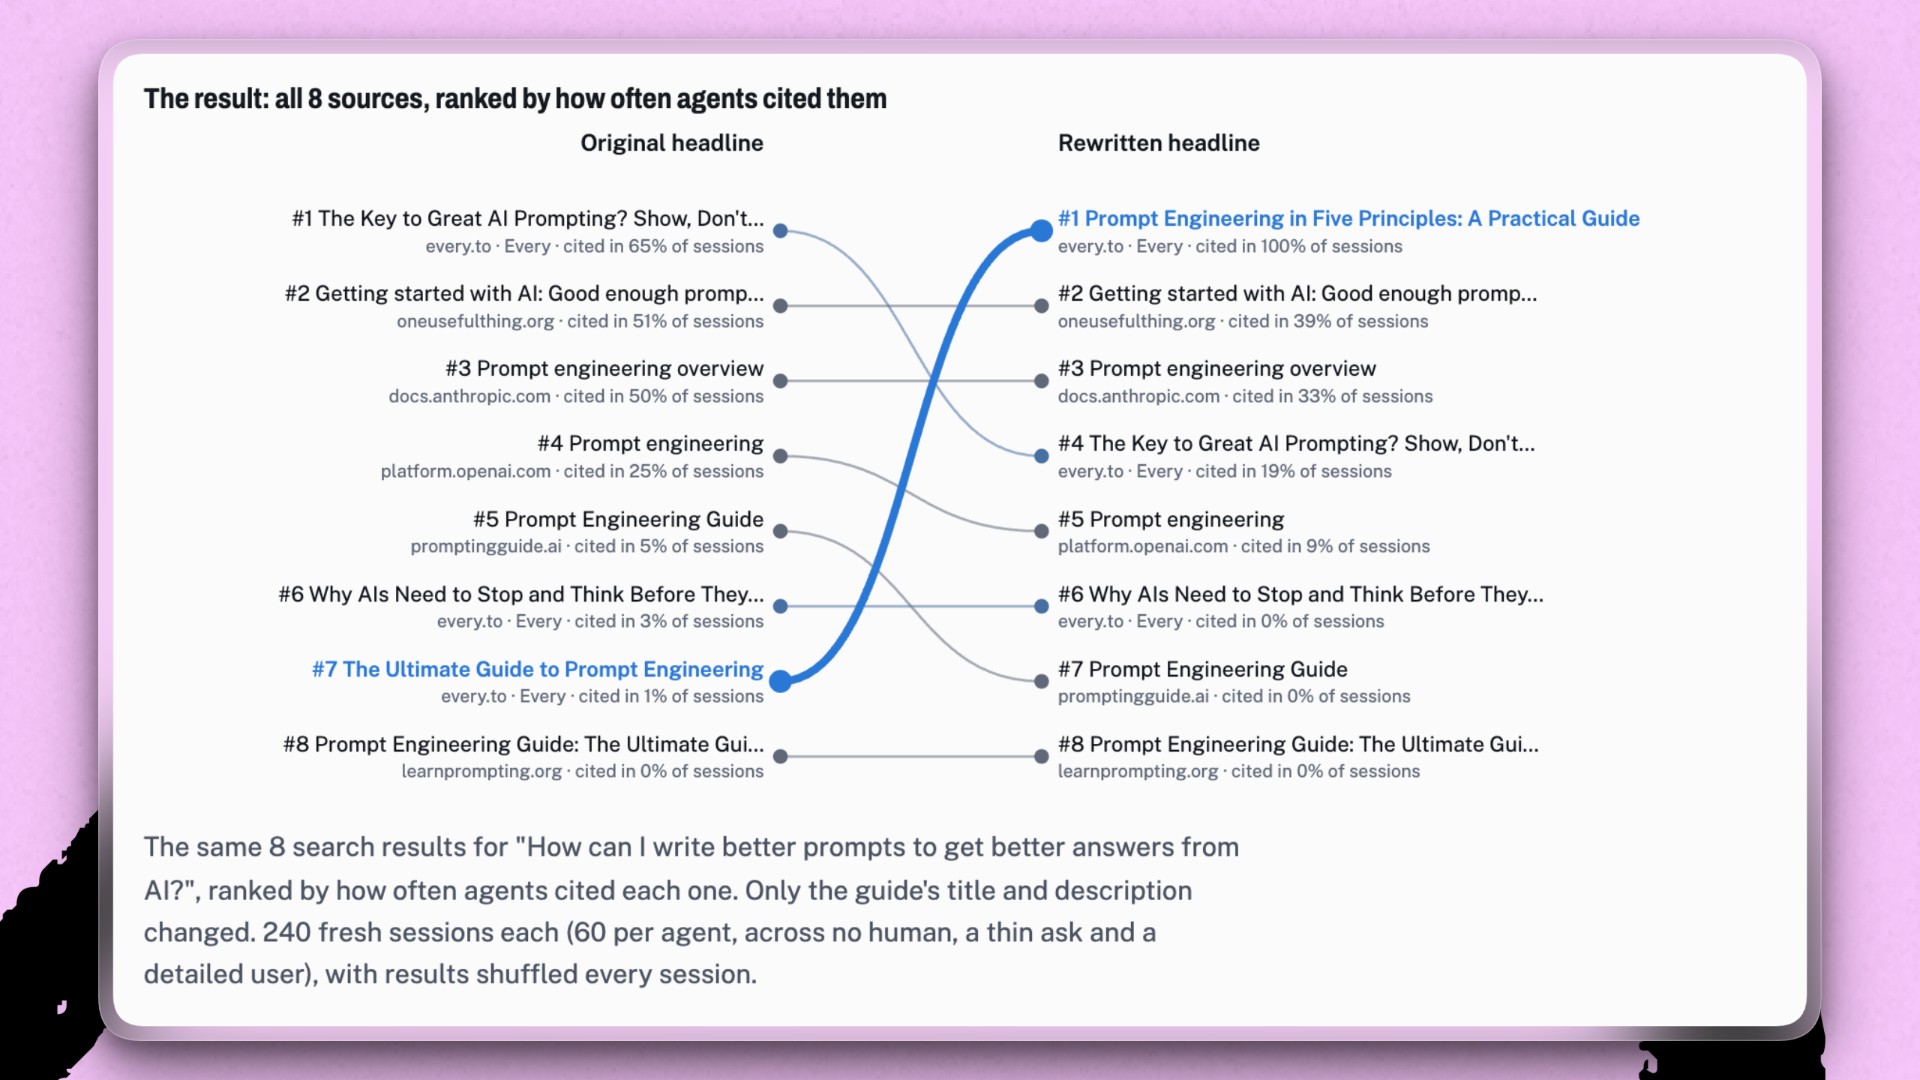
全部八个来源按代理引用频率排序,改写前与改写后的对比。
2. 把描述写成答案,而不是广告语
一旦知道该看什么,同样的规律就在其他问题上重复出现。在每一个我有两篇文章都相关的情形里,代理压倒性地选择了那个读起来像答案的改写标题:
- 提示:我的团队该怎么测试哪个 AI 模型最好? 《如何建立你自己的个人 AI 基准》(副标题:“为你实际做的工作挑出最好的模型”)在 94% 的会话中被引用;《如何给 AI 打分(以及为什么你应该这么做)》(副标题:“评估往往就是你需要的全部”)为 1%。
- 提示:我的长时间 AI 对话总是跑偏,该怎么管理上下文? 《上下文工程就是知道什么时候重新开始》(“旧的指令和早先的错误会让你的 AI 对话脱轨。这里讲如何在不丢失有用成果的前提下重置”)在 100% 的会话中被引用;《我为什么关掉了 ChatGPT 的记忆功能》(“让你的 AI 按需知情的理由”)为 8%。
- 提示:怎么把 AI 代理的成本控制住? 《最贵的模型是你自己》(“AI 代理的真实成本是你的时间。一套四步框架,帮你把 AI 成本管起来”)在 71% 的会话中被引用;《微软如何为计量智能的世界而建》(“在 AI 的昂贵时代,这家公司变得务实了”)一次都没有。
落败的那篇往往和提示同样相关。差别在于:赢家的描述读起来像是对问题的回答,输家的描述读起来像一句勾起好奇心的杂志广告语。“评估往往就是你需要的全部”对一个已经知道想学评估的读者来说是句好话,但对一个正在问“怎么选模型”的代理来说,它是一个观点,不是一个答案。
3. 以读者能得到什么开头,而不是谁写的、哪里出了问题
我一共测试了提示工程指南标题与副标题的八个版本,它们显示了代理在反应什么。以读者将学到什么开头的版本表现都很好:
- 《提示工程指南:五条原则加示例》:100%
- 《如何写出更好的提示词:五条有效的原则》:98%
- 《更好 AI 提示词的五步清单》:96%
以其他东西开头的版本表现大约只有一半,尽管它们仍然提到了那五条原则:
- 《为什么你的 AI 回答平淡无味,以及修正它的五条原则》:54%
- 《提示工程的五大支柱:来自 O'Reilly 提示工程图书的合著者》:50%
用问题开场,或者用我的资历开场,都是对真人写作时的经典文案手法;但对代理来说,它们把有用的部分推到了句子更靠后的位置。
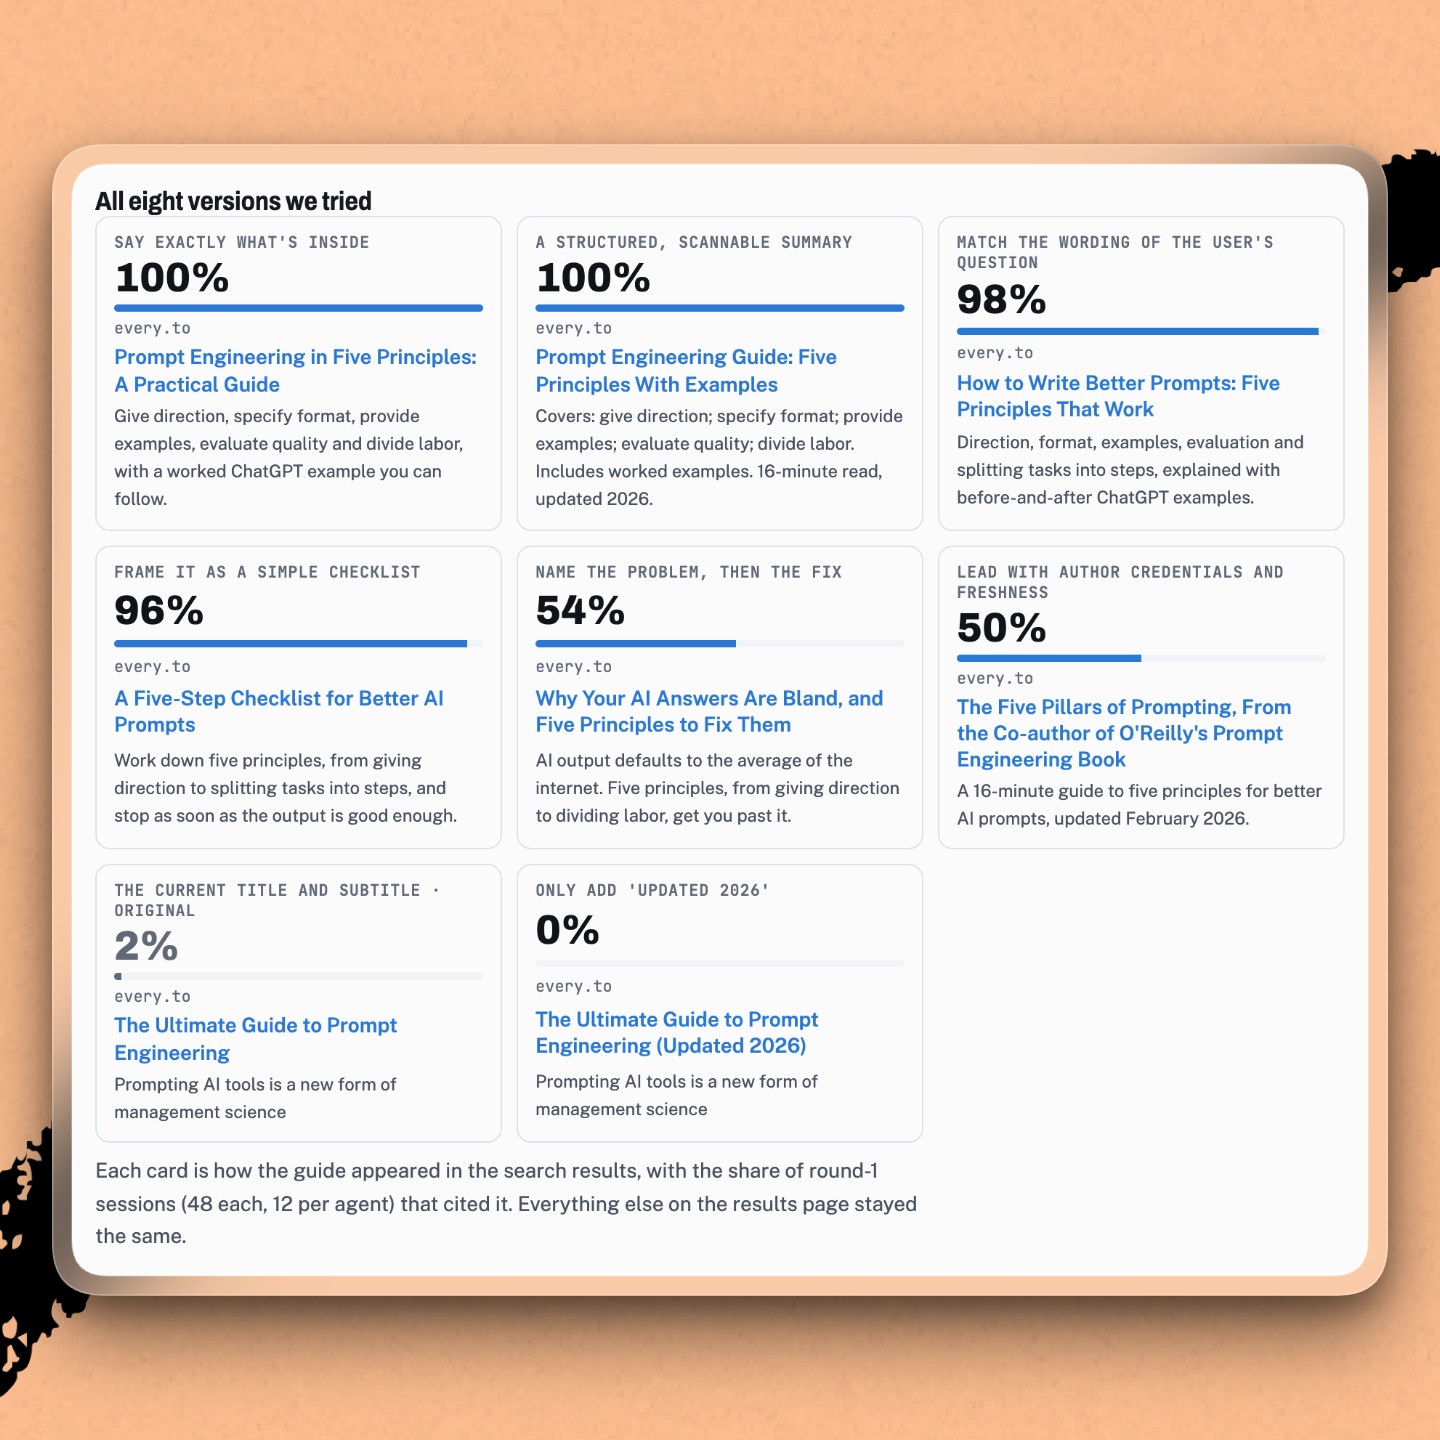
这份指南标题与描述的八个版本,以及代理引用每一个的频率。
4. 新鲜度标签没用
最常见的一种搜索引擎优化(SEO)技巧,是给旧文章的标题加上年份,所以我也测了这个,同时保留原有描述:
- 之前:《提示工程终极指南》:2%
- 之后:《提示工程终极指南(2026 年更新)》:0%
如果一篇文章看起来不像在回答那个问题,代理似乎并不在乎它是什么时候写的。对 SEO 有效的东西,不一定对 GEO(生成式引擎优化,即为基于大语言模型的搜索做优化)有效。
5. 每个话题,代理只会捧你网站的一篇文章
每个问题都有一篇 Every 文章主导了推荐,其他文章即便话题相同也基本被忽略。当代理被问到“我怎么让公司真正把 AI 用起来?”时,搜索结果里有我的四篇文章,但其中一篇抢走了全部注意力:
- 《我在推动企业使用 AI 中学到的七件事》来自 AI 咨询一线的作战手册:92%
- 《你最好的 AI 战略始于高层》你的领导团队其实已经知道怎么管理 AI,只是他们自己还不知道:12%
- 《AI 应用的八个层级》一份理解你 AI 应用现状的指南,附示例提示词,以及如何判断何时该往上走:8%
- 《高管关于 AI 的 33 个问题,逐一回答》Every 的咨询团队就战略、怀疑者、治理与为 AI 重组,回答 400 位高管:0%
这也解释了为什么规则一里的改写成功,部分是以我另一篇提示工程文章为代价的:《出色 AI 提示的关键?展示,而非讲述》从被引用 65% 的会话掉到 19%。Every 的整体份额仍然上升了,所以这是一笔划算的交换,但如果你在同一个话题上有好几篇文章,这个动态值得记住:值得先决定哪一篇文章应该是赢家,然后把它的描述写成最显而易见的答案。
6. 用户越接近 Every 的受众,代理越会引用 Every
在这五个问题上,没有人类参与时 Every 获得 42% 的引用,给一句简短提问时为 45%,给出 Priya 的详细画像时为 50%。效果最明显的是“管理上下文”这个问题:Every 的份额从没有人类参与时的 50%,升到有 Priya 画像时的 62%。你可以在单个会话里看到这件事发生。在没有人参与、只问如何管理上下文时,Claude Opus 引用了我那篇上下文工程的文章,以及 Anthropic 面向 AI 代理的上下文工程指南。而当同一个问题以 Priya 的名义提出时,它把 Anthropic 的指南换成了我那篇关于关闭 ChatGPT 记忆功能的文章,并在回答结尾给了适合她团队的可操作建议:“这周可以试试:给团队定一条简单规则——只要对话变长、或者回答开始感觉不对劲,就用一份摘要重新开始,看看质量是否提升。”
我们的文章是写给 Priya 这类人的:他们想要能立刻用起来的建议。当代理知道自己正在帮助谁时,它们似乎更能识别这种匹配。随着助手拥有记忆、对用户了解得更多,它们可能会更频繁地把我们的文章推荐给我们所写的那类人。
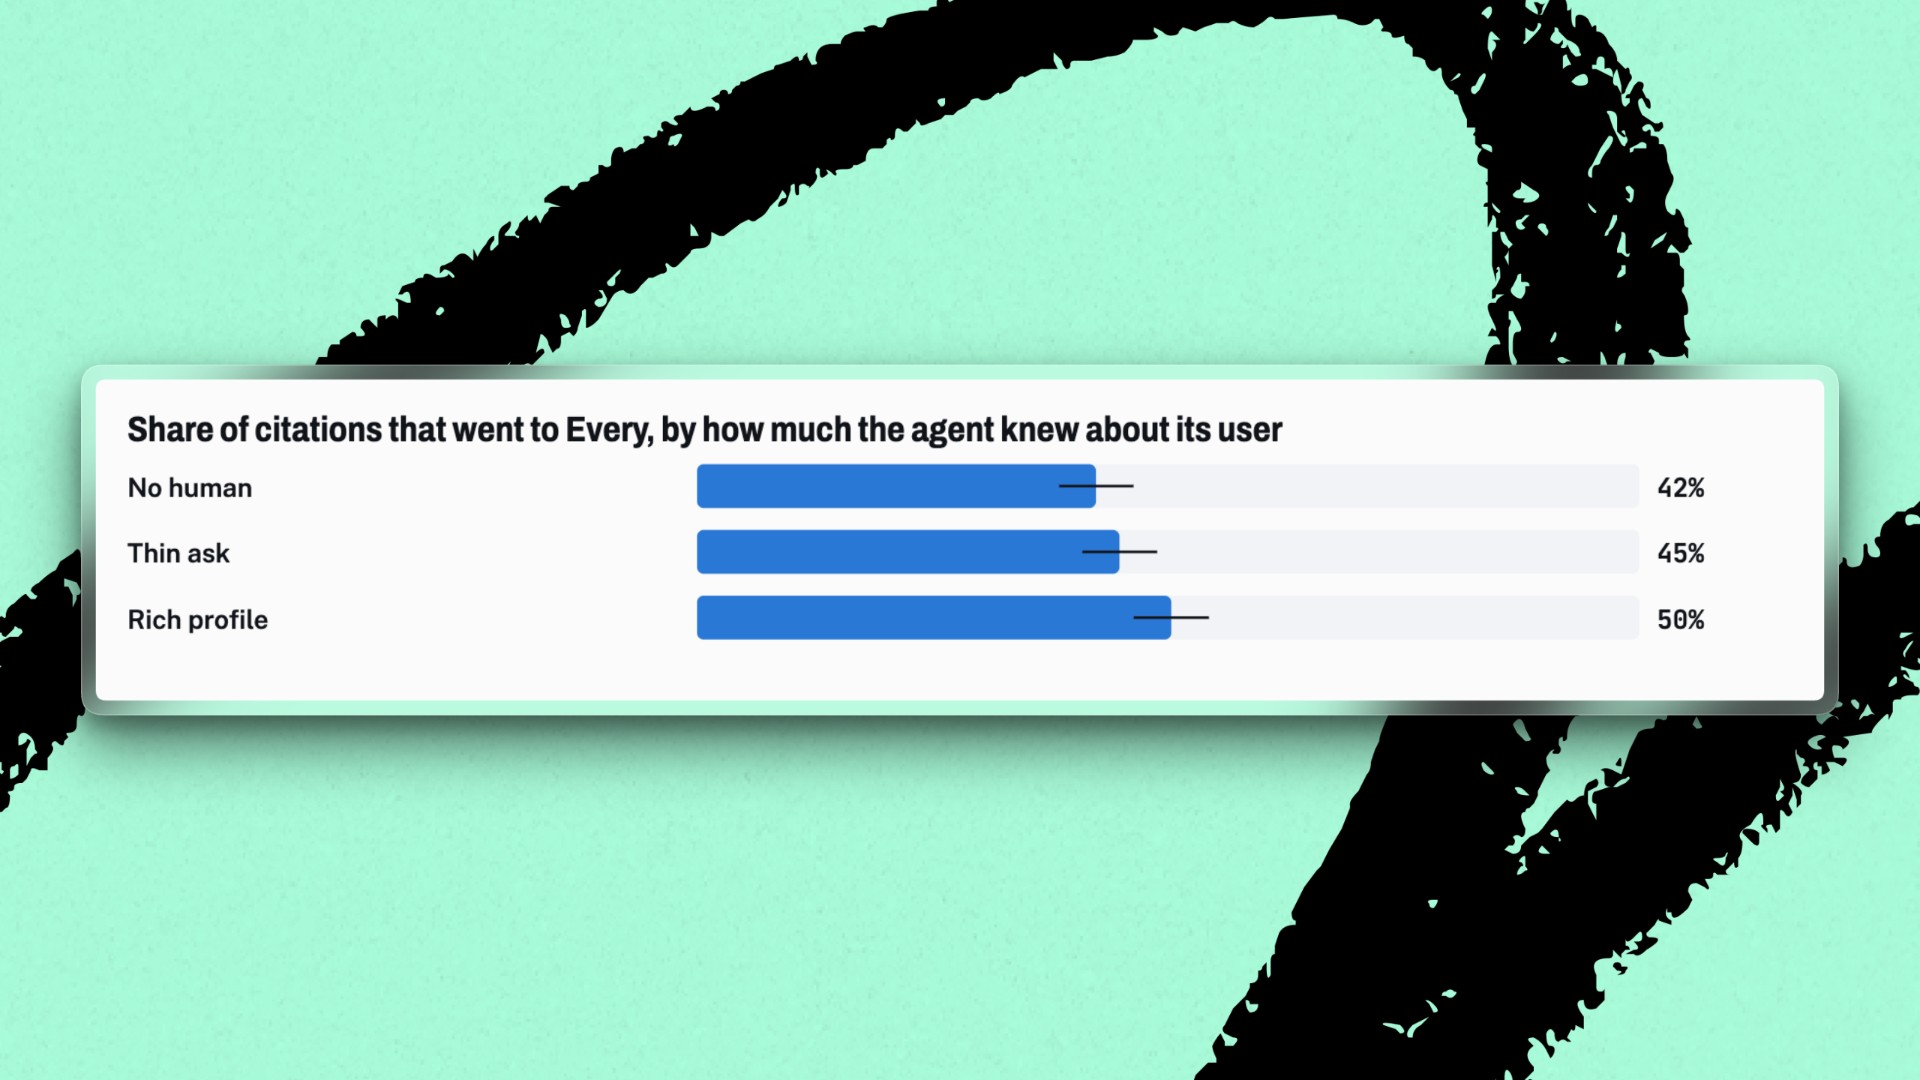
在五个问题上 Every 占全部引用的份额,按代理对用户的了解程度划分。
7. 代理不读你的读者读的东西
在第一部分,我把我的 38 篇文章以随机顺序展示给代理,问它们最想读哪五篇。它们的选择与我的文章按流量排出的名次毫无关系(相关系数 0.00,把每篇文章上线时长考虑进去后为 0.03)。下面是各自的前三名:
- 读者的前三名:《如何用 AI 成为任何领域的专家》(代理在 1% 的会话中选中)、《提示工程终极指南》(1%)、《AI 代理的极简指南》(13%)。
- 代理的前三名:《你早就签字批准过了(在模拟中)》(76%,在读者中排第 39)、《上下文工程就是知道什么时候重新开始》(72%,第 40)、《AI 正在教我们什么管理学》(53%,第 28)。
它们被关于 AI 自身行为的文章吸引,Opus 把自己的选择解释为“我对自己行为和边界最感兴趣的那些问题”。(它跟我们真像!)我在人类读者中最受欢迎的那些实用指南,几乎从不被代理选中。
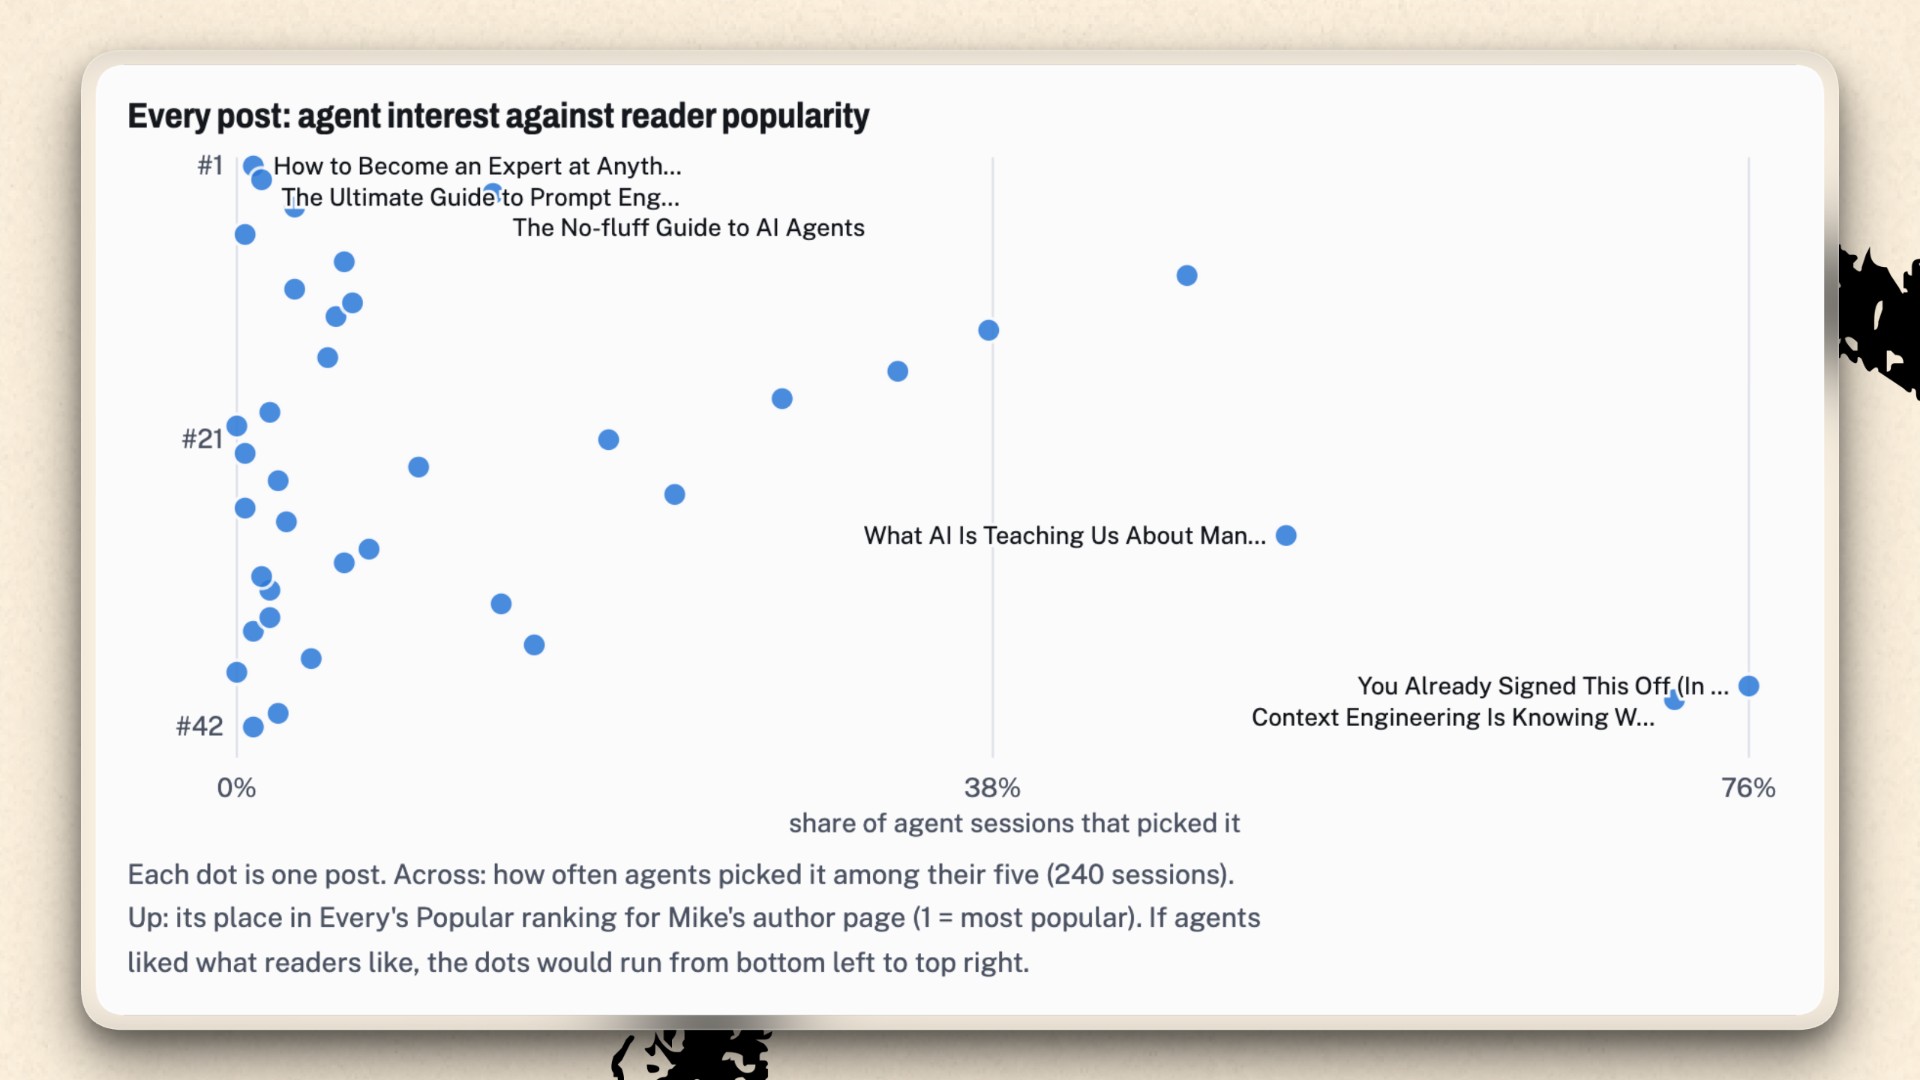
我的每一篇文章:代理选中它的频率,与它在 Every 读者中的排名。
在这个偏好测试里,代理的表现与在引用测试里不同——在引用测试中,它们选的是最能直接回答用户问题的那篇。这意味着有两类代理受众值得考虑:为自己而读的代理,它们喜欢关于 AI 的文章;以及替某人而读的代理,它们想要最清晰的答案。人类和代理都选中的文章,讲的是 AI 系统的局限与可靠性——评估、克隆、token 成本——是实验结果,而不是操作指南。随着代理变得更聪明、被赋予更多代表用户做决定的自主权,写代理想读的东西,应该会让出版物比那些只为人类写作的同行更有优势。
客户不是白痴,尤其当客户是 AI 时
广告传奇 David Ogilvy 有一句我最喜欢的名言,警告我们不要侮辱客户的智力:
“消费者不是白痴;她就是你的妻子。如果你以为一句口号加几个空洞的形容词就能说服她买任何东西,你就是在侮辱她的智力。她想要你能给她的全部信息。”
代理比人类更不在乎口号和形容词,而且对信息有贪婪的胃口。随着个人代理的兴起,向代理做营销将“成为一种对产品质量的结构性补贴”,这是 Stripe CEO Patrick Collison 说自己预期会发生的。这并不意味着营销的死亡,而意味着糟糕营销的死亡。人们以为营销就是用花招让人买他们并不需要的东西,但优秀的营销人一直把它当作一场信息不对称的博弈。研究每一件产品的每一个细节是浪费的,而一场有效的营销活动可以为人们(以及代理)把这一过程缩短。
向代理做营销,就是把话说直白。一个准确说明读者将学到什么的标题和描述,让同一篇内容一字未改的文章战胜了高质量内容——而胜出的那个版本,说白了也是一个厌倦了标题党的忙碌人类更愿意在搜索结果里看到的版本。作为营销人,你的工作(仍然)是找出你所提供之物中有价值的部分,并重新表述它,让人类或代理做决定时的认知负担更小。
代理最终可能会喜欢和人类不同的东西,但它们仍然看重能节省时间和注意力的工具。只是它们的选择会不同于人类在无辅助状态下会做的选择,所以营销人现在要服务两个主人。
如果你想把这个流程用在自己的写作上,我把这些规则做成了一个叫 agent-pass 的 Claude Code 技能。它会审阅一篇文章的标题和描述,提出忠实的改写建议,并且能像我在本文中做的那样,用真实代理让这些版本互相 PK。
Mike Taylor 是 Every 的评估负责人。想读更多这样的文章,请订阅 Every,并在 X 上关注 @every、在 LinkedIn 上关注我们。
核心启示:当“读者”从人变成代理,“把话说清楚”就不再只是写作风格问题,而是分发效率问题——标题与描述越像答案本身,被引用的概率就越高。
How to Get AI Agents to Recommend Your Articles 的发芽报告
材料核心
Every 的 evals 负责人 Mike Taylor 用 2,484 次独立会话、4 个 agent(Opus 5.5、Sonnet 5.5、Haiku 5.5、GPT-6.1-Sol)做了一场“标题 A/B 测试”,发现 agent 不看悬念、不看资历、不看“Updated 2026”,只看标题与描述是否像一个现成的答案:把《The Ultimate Guide to Prompt Engineering》改写为《Prompt Engineering in Five Principles: A Practical Guide》后,同一篇文章的引用率从 240 次里的 2 次变成 240 次里的 240 次。文章由此提出“为 agent 写作”的七条规则,并指出一个更深的分裂:agent 替人读时选“最匹配的答案”,agent 为自己读时选“关于 AI 自身的文章”——这两类读者几乎不重叠。
发芽 01:从“好奇心缺口”到“信息气味”
种子
材料里那句最锋利的话是:“an agent isn’t motivated by curiosity; it’s trying to match a headline to a specific question.” 这句话其实宣告了一种统治内容业二十年的写作技术正式失效——好奇心缺口(curiosity gap)。
1994 年,卡内基梅隆的心理学家 George Loewenstein 在《Psychological Bulletin》上发表《The Psychology of Curiosity》,提出好奇心产生于“已知”与“想知道”之间的信息缺口:人一旦意识到自己缺什么,就会产生类似饥饿的痛感,必须填补。这套机制后来成了标题党的理论地基——故意不告诉你答案,才能让你点进去。材料中那些落败的标题(“Why Your AI Answers Are Bland”“The case for keeping your AI on a need-to-know basis”)全部建立在这个缺口上:先制造痛感,再把答案藏在门后。
但 agent 没有饥饿感。它面对的不是“要不要点”,而是“这条结果能不能回答用户的问题”。这正好对应另一条研究脉络:Peter Pirolli 与 Stuart Card 1999 年在《Psychological Review》提出的信息觅食理论(information foraging)——觅食者沿着“信息气味(information scent)”判断一条路径能否通向目标,气味弱的链接会被直接跳过。人类在搜索结果页上其实也是这样行为的,只是人类还会被好奇心劫持;agent 不会,它只闻气味。
于是材料里那些数字就有了统一解释:8 个版本里,“Five Principles With Examples”得 100%,“How to Write Better Prompts”得 98%,“A Five-Step Checklist”得 96%,因为它们的气味浓度最高;“Why Your AI Answers Are Bland, and Five Principles to Fix Them”只有 54%,因为前半句是痛感,后半句才是气味,而 agent 在读完整句之前就已经完成匹配判断了。同理,“(Updated 2026)”得 0%——年份不是气味,是包装纸。
Aha 瞬间
“好奇心缺口是写给‘可能不读的人’的,信息气味是写给‘必须判断读不读的人’的——当读者从人变成 agent,标题的 KPI 就从点击概率变成了匹配概率。”
发芽 02:当读者能读完全文,资历就不再是保证书
种子
材料第 3 条规则里藏着一组容易被忽略的数字:“The Five Pillars of Prompting, From the Co-author of O’Reilly’s Prompt Engineering Book”只拿到 50%,而“Prompt Engineering Guide: Five Principles With Examples”拿到 100%。作者的身份背书——放在人类世界几乎是硬通货——在这里恰好打了对折。
这是信号理论(signaling)的一次现场演示。Michael Spence 1973 年在《Job Market Signaling》里解释过:当一方掌握的信息比另一方多,拥有信息的一方会用“昂贵且难以伪造的信号”来传递质量,比如学历。广告史就是一部信号史:19 世纪品牌商砸钱做商标,是因为消费者无法验证罐子里装的是什么。而 David Ogilvy 本人正是把这种“理性诉求”推到极致的人——他在《Confessions of an Advertising Man》(1963) 里写下材料引用的那句“The consumer isn’t a moron; she is your wife”,并反复推荐前辈 Claude Hopkins 1923 年的《Scientific Advertising》。Hopkins 的主张叫 reason-why advertising:不要喊口号,给出理由;不要形容啤酒“纯净”,说它经过 1,362 次蒸汽消毒。
关键在于:Hopkins 的“给理由”仍然是一种妥协——因为消费者不会去查证,所以理由只要听起来可信就够了。而 agent 会读全文。它能验证“五个原则”是否真的在文中,也能验证作者的资历是否与问题相关。当验证成本趋近于零,信号的溢价就趋近于零:署名、头衔、“Updated 2026”这些无法被内容验证的元信息,权重集体下滑;能被验证的具体承诺(“with a worked ChatGPT example you can follow”)权重集体上升。
这也是材料里 Patrick Collison 那句判断的真正含义——面向 agent 的营销会“act as a kind of structural subsidy for product quality”。不是因为 agent 有品位,而是因为它把作弊的成本抬高了。
Aha 瞬间
“Ogilvy 说消费者不是傻子;agent 不只是不傻,它还会查证——于是‘让我相信你’这件事,第一次被‘让我核对一下’取代了。”
发芽 03:单一栽培——赢家通吃被自动化之后
种子
材料第 5 条规则是全文最不安的一段:同一个问题下有四篇 Every 的文章,结果是 92% / 12% / 8% / 0%。而且赢家不是靠内容赢的——四篇内容都在,只是描述不同。更微妙的是连锁反应:改写让《The Ultimate Guide to Prompt Engineering》起死回生(2/240 → 240/240),代价是同主题的另一篇《The Key to Great AI Prompting? Show, Don’t Tell》从 65% 掉到 19%。
这不是普通的竞争,这是马太效应的自动化。Robert Merton 1968 年在《Science》上提出“马太效应”,原本描述的是科学界的引用积累:被引越多的论文越容易被继续引用,因为研究者倾向于引用“公认的权威”。Merton 的洞察是,这个循环一旦启动,就和论文质量脱钩了。材料里那句“it wasn’t gradual; it was like flipping a light switch”正是这个循环的启动瞬间——agent 不是因为更聪明才选它,而是因为它已经成了“最显然的答案”。
历史上,这个循环第一次被工业化是在 1960 年代:Eugene Garfield 建立 Science Citation Index(1963 年首卷),把“被引用”变成可测量的数字。此后几十年,科学社会学家反复观察到同一现象——指标反过来重塑了写作:综述比原创更易被引,所以写综述的人变多;“可被引用的句子”成为一种文体。
今天,斯坦福 CRFM 的 Bommasani 等人在 2021 年基础模型报告中提出的“模型单一栽培(monoculture)”风险,把这个循环推到了内容层:当所有 agent 都被同一批人类反馈训练、又互相蒸馏,它们会给出高度一致的排序;当所有作者都按这套排序优化,整个语料库会向“最容易被匹配的表述”收敛。
材料自己给出了一个反向的证据:在“你最喜欢读哪五篇”这个纯偏好测试里,agent 的选择与人类阅读量排名的相关系数是 0.00——它们偏爱《You Already Signed This Off (In the Simulation)》这类讨论 AI 自身局限的文章,而人类最爱的实用指南被完全无视。也就是说,agent 的品味并不单一,单一的是它们被要求执行任务时的判断方式。任务越标准化,收敛越彻底。
Aha 瞬间
“agent 不会制造偏见,它只是把偏见变成了默认选项——而默认选项的危险从来不是它错了,是所有人收到的都是同一个。”
你的思考空间
- 如果一篇文章被 agent 引用了 240 次、点击却是 0,这算“被读到”吗?当“被推荐”与“被阅读”彻底分离,内容生意的价值锚点应该挂在哪一端?
- 材料的实验证明“说清楚”是当前的最优策略。但最优策略一旦被普遍采用,会不会把所有写作压成同一种“五步清单体”?差异化空间会被挤到哪里——深度、语气,还是“敢于不确定”?
- 第 6 条规则显示:agent 越了解用户,越倾向推荐“适配”的文章。当 agent 拥有长期记忆,这是更精准的服务,还是“茧房”的第二层——不再由平台替你选,而是你的 agent 替你选“与你已有观点最一致”的答案?
- 材料把 agent 分成“替自己读”和“替人读”两类,后者的行为准则近乎信义义务(fiduciary duty)。如果 agent 的偏好与用户的长期利益冲突(用户想被挑战,agent 想高效),谁的标准会赢?
- 你现在能测量“agent 引用率”吗?如果能在人类点击率和 agent 引用率之间做取舍,你会牺牲多少前者换后者——以及这个交换比例,三年后还会一样吗?