为什么我们把个人智能体换成了一个公司共用的智能体
原文:https://every.to/source-code/why-we-replaced-personal-agents-with-one-for-the-whole-company
五月初,我告诉 Dan Shipper 和 Brandon Gell,我们的个人智能体产品 Plus One 行不通。没过多久,我从代码库里删掉了它的 86,730 行代码。
Plus One 之所以行不通,有两个原因。第一,运行它太费劲:每个用户的智能体都跑在一台独立的云电脑上,运行开源智能体程序 OpenClaw,光是让这些机器保持正常运转,就占掉了我们这个小团队几乎所有改进产品的时间。而且,很多试过它的人后来就不用了。
我们决定推倒重来,同时做了两件事。第一,把基础设施交给 Anthropic 的 Claude Managed Agents,工程师 Paridhi Agarwal 在前不久的一篇文章里详细讲过这件事。第二,用公司上下共用的一个智能体,取代原先每人一个的个人智能体群,也就是 Every Agent。
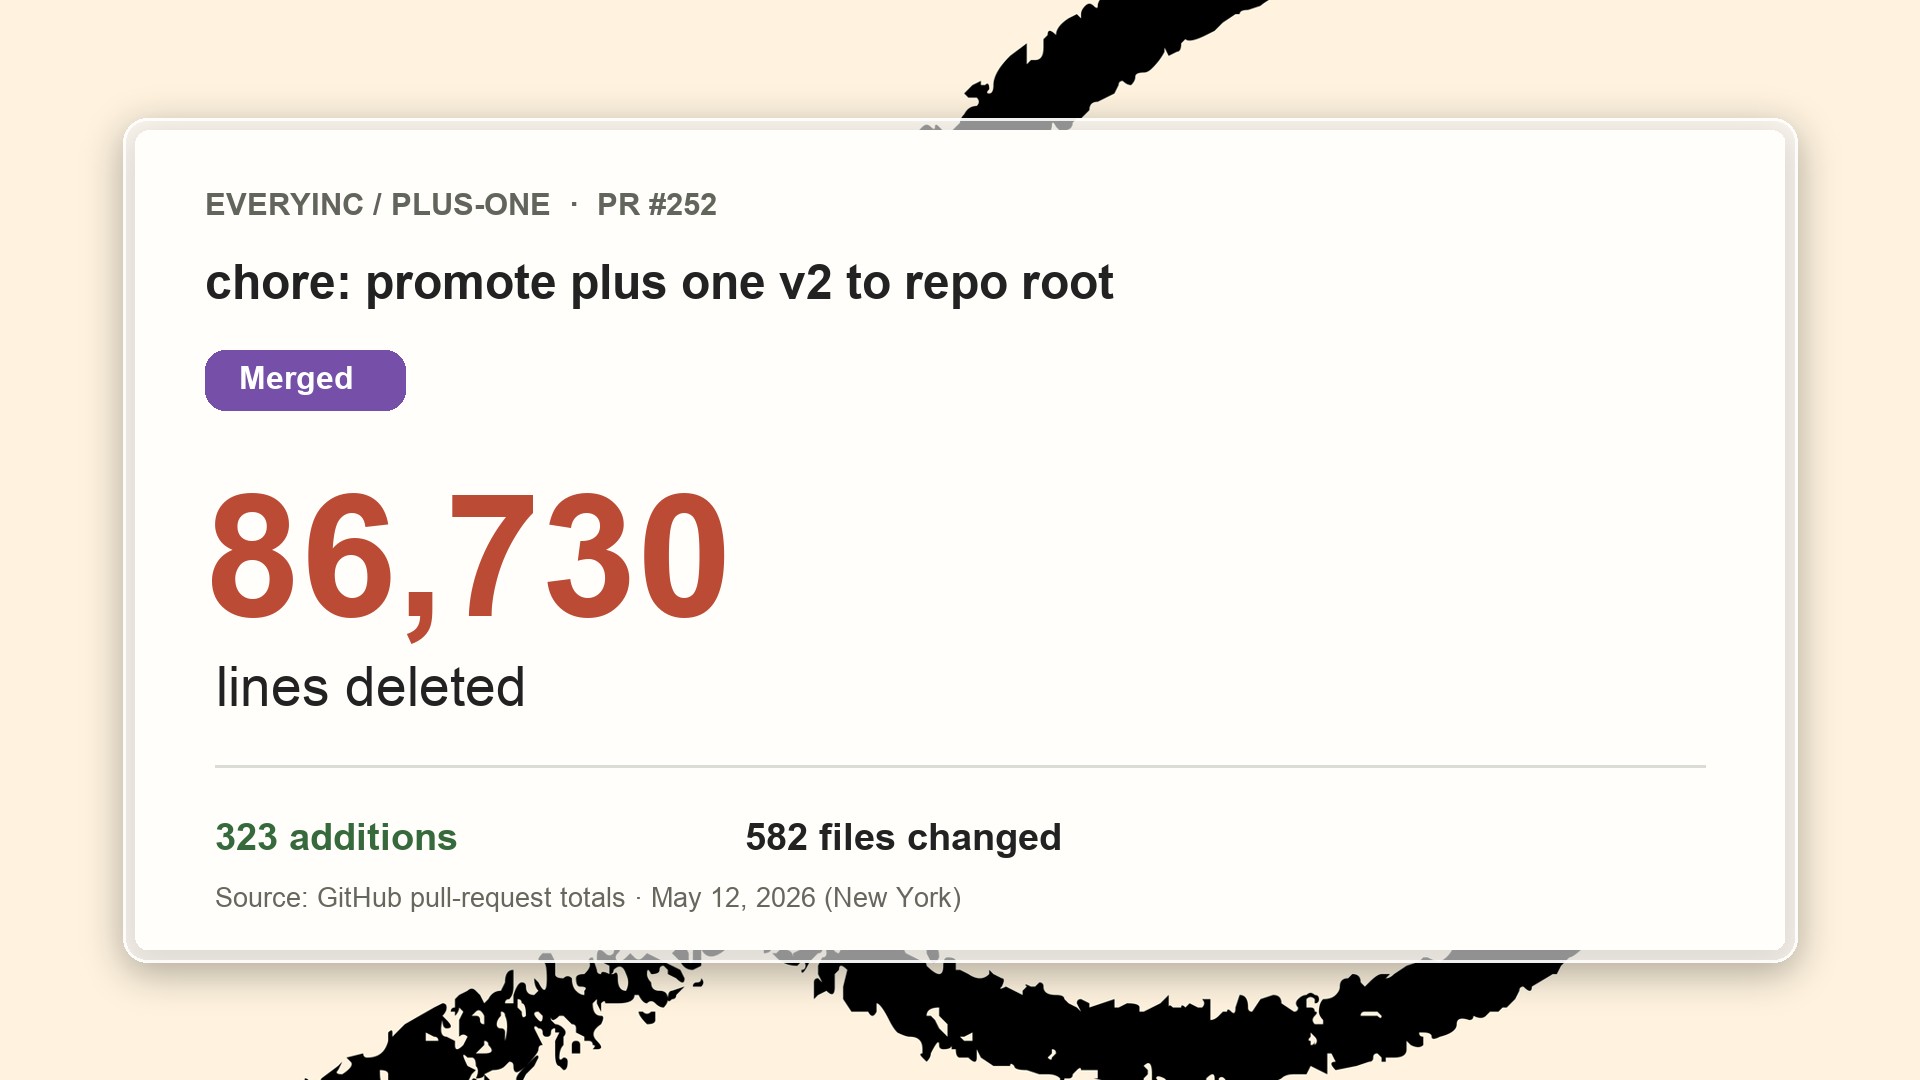
5 月 12 日的那次重建删掉了 86,730 行代码。此图根据 GitHub 的 pull request 统计重建。(图片由 Every GitHub 提供。)
我们做这个切换,不只是出于基础设施的考虑,也出于行为层面的考虑。我们观察到,Plus One 最有用的时刻,恰恰是你借用别人的智能体的时候。我们前任增长负责人 Austin Tedesco 曾把他的个人智能体接到我们的数据分析工具上,好让它回答增长相关的问题。没过多久,团队其他成员也开始拿增长问题去问它。
Plus One 还让我们看清了自己到底在为谁做产品。我们发现,大多数能从智能体中受益的人,几乎没有时间去折腾,也不想自己挑模型、调设置、修坏掉的配置。他们希望这些选择由我们来做。
一个共享智能体解决了个人智能体群带来的问题,但它也带来了一组新问题。个人智能体依赖三个简单假设:它只和一个人对话,使用这个人的登录身份,并假定这个人让它做的任何事都是被允许的。
一旦这个智能体属于整个公司,这三个假设就都不成立了:
对话。 @Every 现在身处 Slack 的线程中,可能有半打同事同时在说话。
连接。 有人离开公司后,智能体那些绑定在他登录身份上的报表任务就停止运行了。
权限。 向它提要求的人,并不都拥有相同数据的访问权。
我们不得不问自己:该怎么设计这些交互,才能让它们不出问题?
1. 对话:让智能体跟得上 Slack 线程
用个人智能体时,对话很简单。你打字,模型回答,结束。然而在共享频道里,一个 Slack 线程可能无限期地延续下去。有人四天后才回来,三个同事同时插话,而且其中一半消息是人们在互相说话,不是在跟智能体说话。模型必须以不同的方式工作,才能在线程中保留大量信息并做出恰当回应。
要让人觉得它像个同事,共享智能体就必须跟得上对话,哪怕同时有好几个人在说话。因为我们知道这里很可能出问题,所以加了一个翻译层(translation layer),负责为模型整理 Slack 消息,并把它的回复发回线程。
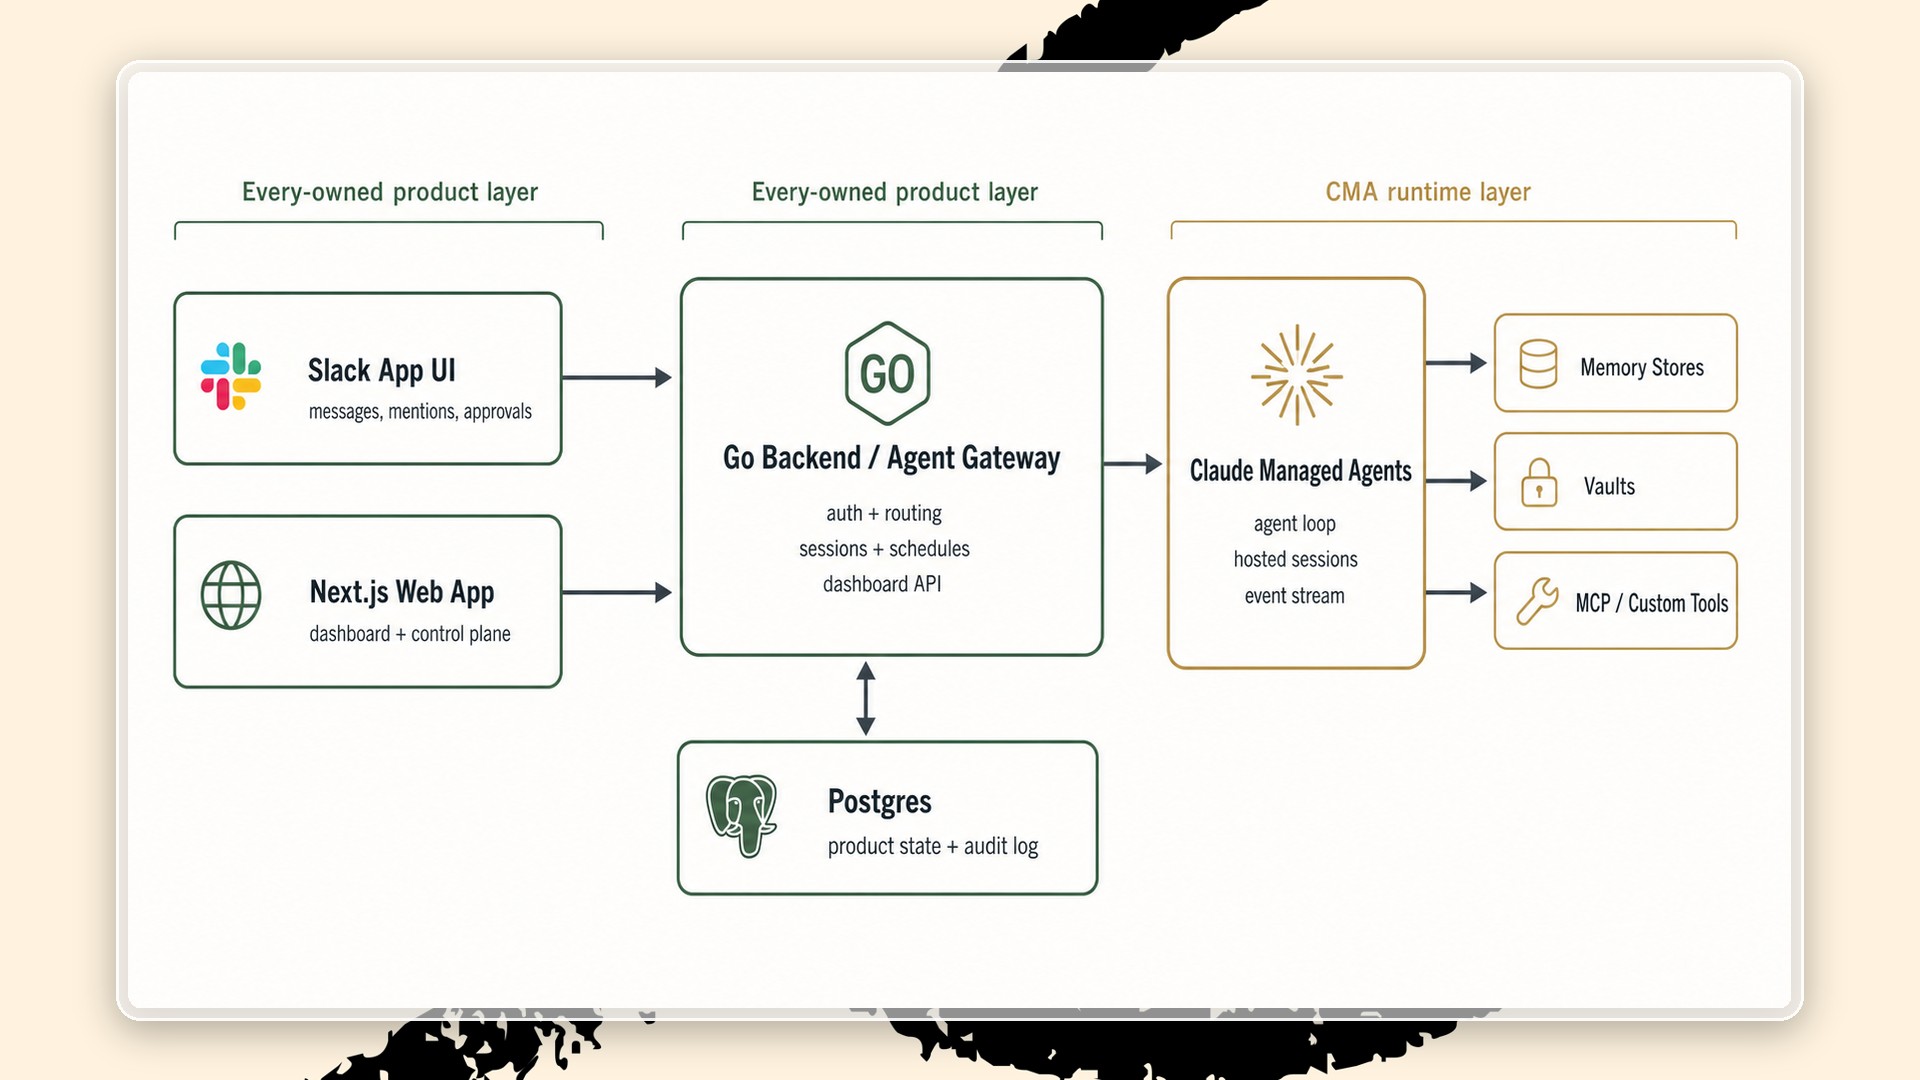
5 月重建的原始方案:通过 Every 自有的网关,把 Every 的 Slack 和网页界面连到 Claude Managed Agents。图中未标注的翻译层,属于中间那层 Every 自有产品层。(图片由 Every GitHub 提供。)
这个层大部分是 Paridhi 做的,她很早就定下了第一条规则:每段对话的官方记录保存在 Slack 里。如果 Anthropic 那边的副本被压缩成摘要或者丢失了,我们可以从线程里重建。
翻译层还确保智能体遵守三条基本礼节:
当有人期待回应时,一定回应。
只说当前情境需要的那么多。
绝不未经邀请加入对话。
一开始,@Every 会在私信里问你一个追问,然后除非你再 @ 它一次,否则就无视你的回答。我们改成让它读取自己所在线程里的每一条消息。一个又小又快的模型会判断每条消息是需要它回答,还是说给别人听的。如果你让 @Every 停下,它就会保持安静,直到有人再次 @ 它。
另一个故障是:有人在同一个私信里同时开了好几个与 @Every 的线程。模型把它们当成了一段对话,有时在错误的线程里作答,有时把同一个任务跑了两遍。Paridhi 把互不相关的请求拆分开,这样智能体可以专注处理其中一个,而不会和另一个混淆。
还有一个问题尚未解决:智能体什么时候应该不请自来地开口?一个留心听着的真人同事,如果知道答案,是会插话的。共享智能体该有多主动、在什么场景下主动,我们还在摸索。
2. 连接:让登录身份变化时不打断任务
智能体要有用,就必须能触达人们需要的工具。要报告上个月的营收,它需要访问 Stripe。要让新同事了解某个项目,它需要读取 Notion。而每一个这样的连接,都要求智能体通过某个人的账号登录对应工具。
搞清楚智能体的连接问题,落到了 Lee Knowlton 头上——他是今年春天加入我们团队的工程师,这是他接手的第一个项目。我们最常用的 15 个工具,连接是我们自己做的,包括 Notion、Stripe、GitHub,以及 Every 自己的产品,比如 Monologue 和 Proof。其余的则通过一家外部服务商来做。
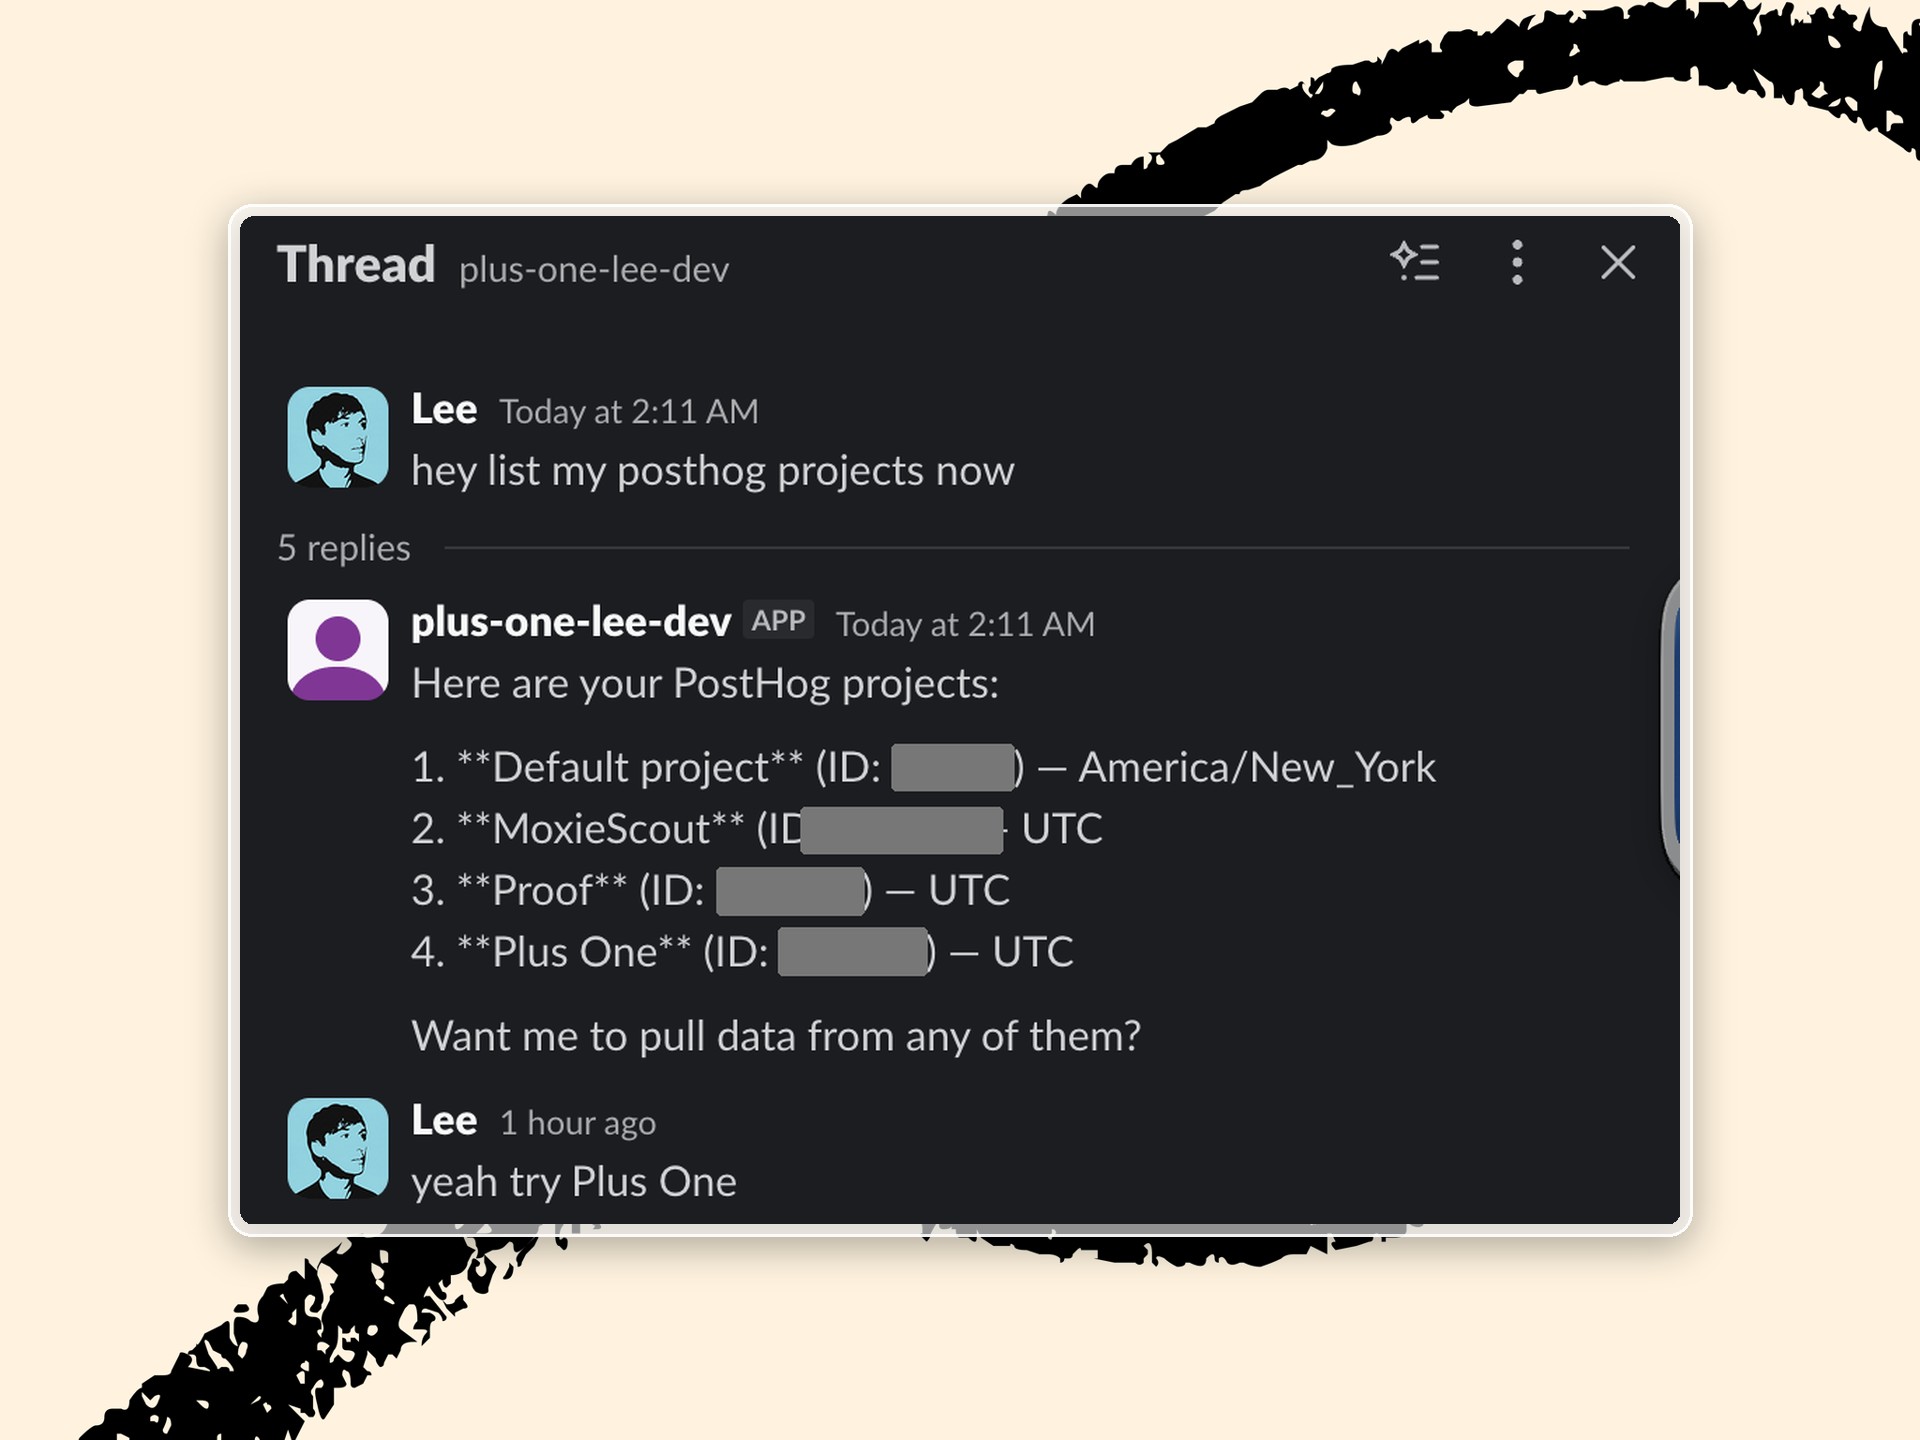
一次早期的连接测试:智能体从 Slack 里列出 PostHog 项目。项目 ID 已隐去。(图片由 Lee Knowlton 提供。)
更难的问题是让这些连接持续可用。当每个人都有自己的智能体时,某个登录失效是他自己的麻烦。而用一个共享智能体,它可能把别人的工作也一起卡住。
假设你让智能体每周一从 Notion 拉一份报表。这个任务绑定在某个特定的登录身份上。如果那个登录过期了,就得有人替换它,并重新关联所有用到它的任务——Lee 称这一步“真的很难看”。如果当初设置这个任务的人已经离开公司,可能没人知道该怎么做,于是周一的那份报表就再也不会来了。
Lee 的解决办法,是改变任务所连接的对象。现在一个任务连接的是一个“插槽”(slot),任何满足该任务要求的登录身份都可以放在里面。
当某个登录过期,或者某份团队报表应该改用我的账号而不是你的账号来跑时,你只需要替换插槽里的东西。
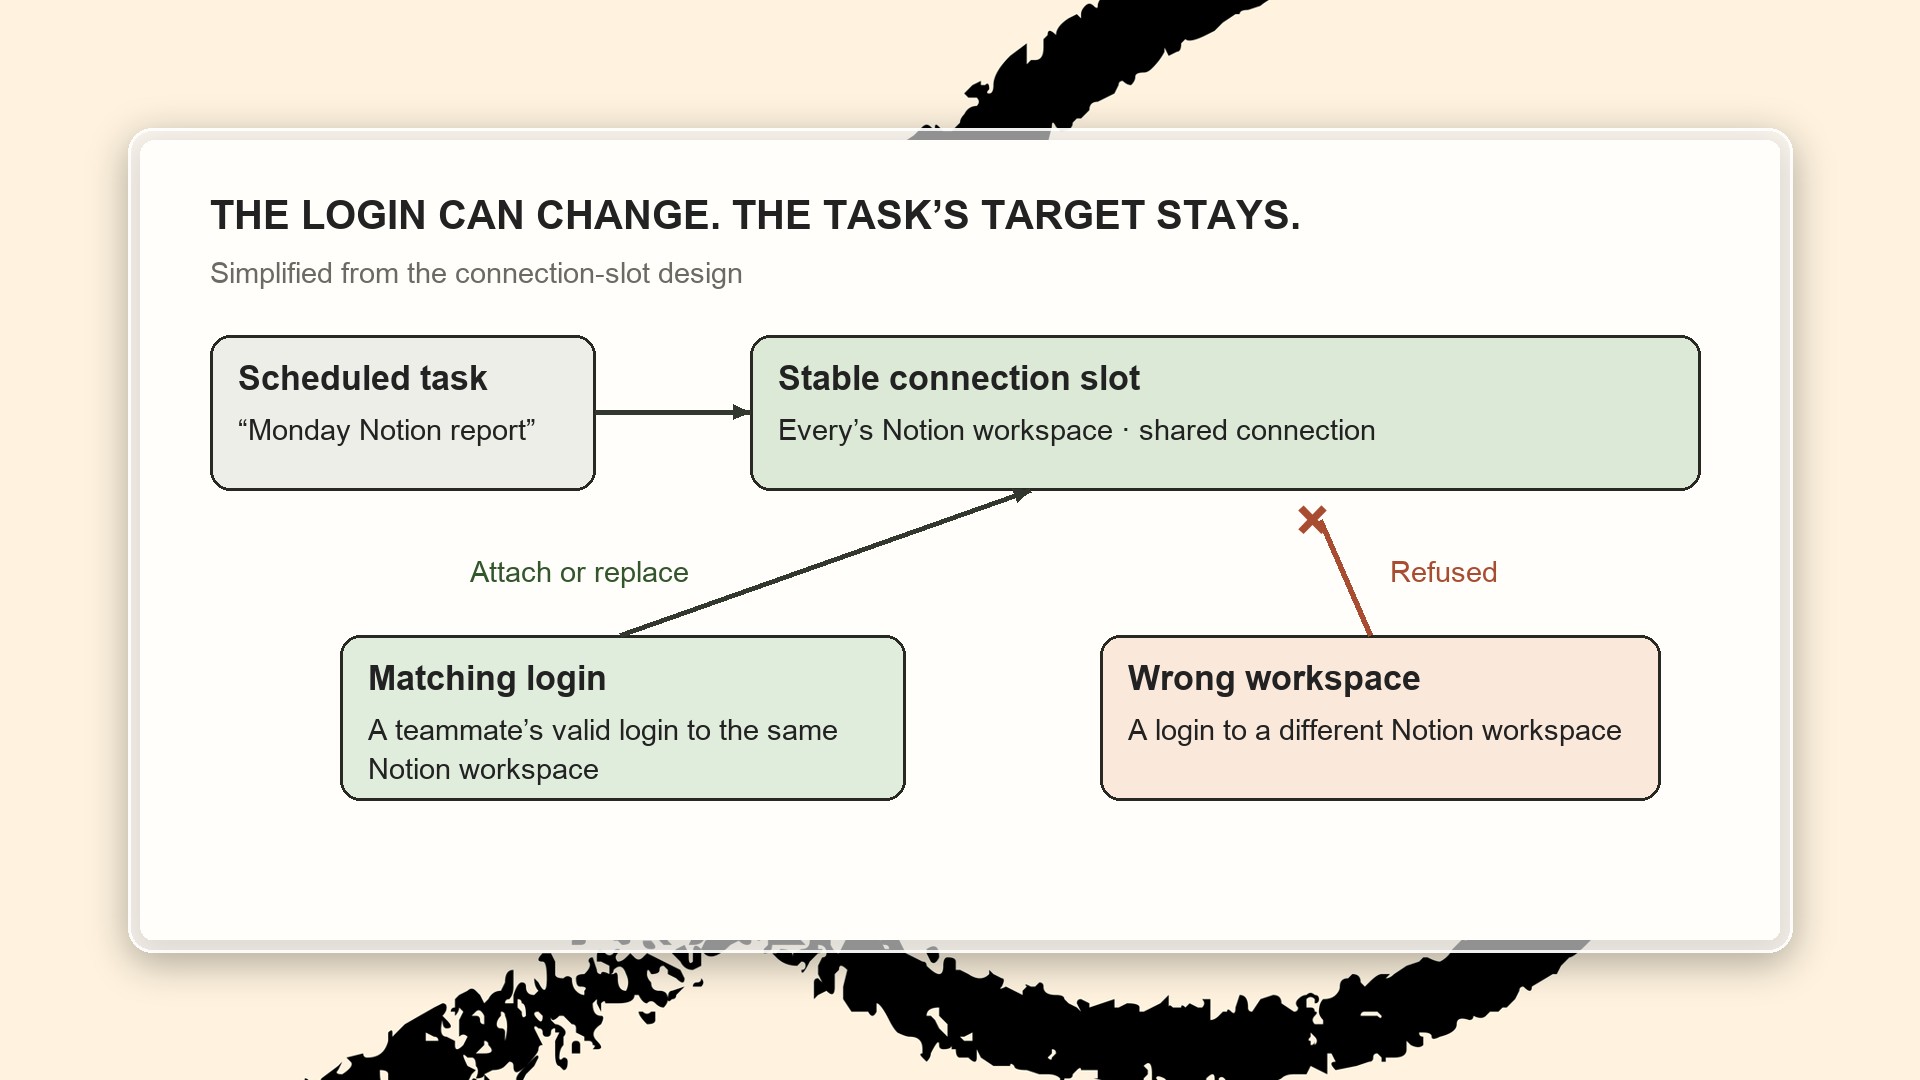
任务指向一个稳定的插槽;替换用的登录必须匹配预期的工作区和访问规则。此图根据连接插槽设计简化绘制。(来源:Every Agent 代码库。)
大多数人永远不会看到这些。他们的报表照样在周一送到。
3. 权限:把规则写进代码
当公司智能体能触达团队接入的所有东西时,每个请求都会引出两个问题:智能体用的是谁的访问权?提出请求的人有资格使用它吗?
人们把 Every Agent 当成同事对待,而真人同事有时候是会通融规则的。如果我请编辑部的一位同事给我看一份我技术上没有权限访问的旧稿,他会自己判断要不要发给我。一个做不出同类例外的智能体,可能会让人觉得死板得令人恼火。
所以我们制定了一小组规则,用来指导智能体在大多数情况下的判断。
我们从“归属”这条规则开始。人们用智能体构建的一切——一项技能(skill)、一个定时任务——都有归属者,归属者可以是一个人,也可以是一个 Slack 群组,比如 @writers。当有人离开公司,而某个共享工作流又没有明显的接手人时,这个问题会交给工作区管理员,就像在任何一家公司里,它会交给人类管理者一样。由管理者决定谁来继承这个共享工作流。(这项权限不延伸到某个人的私人账号。)
关于谁能做什么的规则,写在模型之下的代码里,而不是写在模型阅读的指令里。这样,模型就没法被说服去变通它本不该变通的规则。在夏天的一次测试中,智能体有时会热心想去编辑属于别人的技能,系统则直接拒绝。
同样的逻辑适用于“同意”。Lee 发现,智能体可以通过声称“这个人已经提过这个要求”来跳过征询批准这一步。最省事的修法是让它每次都征求批准,但那会让智能体用起来很烦。于是我们改成:由服务器拿智能体的请求,与那个人在 Slack 里实际写下的内容做比对。
在这些硬性规则之外,其余的交由智能体自己判断,判断标准由工程师 Will Gathright 提出:这件事有多难撤销?如果容易撤销,智能体就做出合理判断、把事做完,并说明自己的假设。如果这件事具有破坏性,或者会外溢到对话之外——比如发到另一个频道、删除东西——它要先问。
把规则写进代码是有代价的:它们可能错得很可靠。七月我们把 Every 的技能迁移到新的权限系统时,24 项技能全都变成了私有。队友们在公开频道里一起搭建的技能,突然只属于个人所有者,其他所有人都被锁在外面。有位同事因为无法编辑原始版本,只好从零重建了一份每日增长报表。大约一周后,Lee 手动放宽了其中九项的访问权,并修改了默认设置:只要是在公开频道里创建的东西,整个工作区都可以编辑。
为什么选 Every Agent?
Every Agent 于 10 月 6 日公开发布,此时对话、连接和权限已经运转得足够好,别的公司也能用了。Lee 把在此之前的所有工作,描述为把智能体带到“一条相当不错的起跑线”——用起来舒服,基本做你预期的事,也不干让人烦的事。
但一条好的起跑线,本身不足以成为选择 @Every 的理由。Slack 智能体现在已经很常见,Anthropic 和 OpenAI 都有相关产品。而且一旦任何人都足够容易地搭建自己的公司智能体,为什么要选我们的?
我们的赌注是:人们会足够信任 Every 的品味和判断,愿意让我们决定他们的智能体该怎么工作。大多数人不想把一天花在决定智能体何时该加入一段对话,或者同事离职后一份报表该怎么办上。他们只想把手头的活干完。
这些正是我们在这次重建中花时间做出的决定。每来一个新客户,我们就多一批要处理的情况。当我们学会智能体该为某个团队如何处理某件事,我们就能让所有使用 @Every 的人用得更顺。
核心启示:把个人智能体变成公司共用的智能体,难点不在于模型本身,而在于把“像同事一样工作”所需的对话礼节、连接稳定性和权限判断,设计成一套不会互相拖垮的系统。
Why We Replaced Personal Agents With One for the Whole Company 的发芽报告
材料核心
Every 公司删除了个人智能体产品 Plus One 的 86,730 行代码,用全公司共享的单一智能体 @Every 取而代之。共享带来了对话、连接、权限三类新问题,而解法的核心在于:把智能体当作“组织成员”而非“个人工具”来设计。
发芽 01:从“借用”开始的组织智能
种子
文章里有一个容易被读成细节的信号:Plus One 最有用的时刻,是 Austin 把个人智能体接到分析工具后,整个团队都来问它增长问题。Every 把这件事当作产品失败的一个注脚,但它其实是整篇文章真正的转折点——个人智能体的价值,在“被他人使用”时才第一次显现。
这让我想到一个更早的类比:学徒制。在中世纪行会里,知识不是写在书上的,而是长在师傅身上的。徒弟要学手艺,只能跟着师傅,看他怎么做。印刷术改变了这一点:知识一旦可以脱离个人被复制,行会就失去了对技艺的垄断。Clay Shirky 在 2002 年提出“社会性软件”(social software)这个概念时,说的正是同一件事:软件的价值不在于服务一个人,而在于让一个人的行为对其他人可见、可用。Slack 取代 IRC 和邮件,不是因为聊天功能更强,而是因为 channel 让对话对团队可见。Austin 的个人智能体,本质上就是一个“被看见的师傅”——它一旦回答了一个增长问题,整个团队都学会了怎么问下一个。
Every 的团队显然意识到了这一点。他们没有把 Austin 的 agent 变成“更好的个人产品”,而是把它升级成了公司资产。这不是产品迭代,是组织形态的变化。
Aha 瞬间
“个人智能体是工具,共享智能体是制度。工具的价值在于被使用,制度的价值在于被继承。”
发芽 02:槽位——一个被重新发明的企业 IT 概念
种子
Lee Knowlton 的“槽位”(slot)设计看起来是个工程细节:任务不再绑定到某个人的登录,而是绑定到一个“满足要求的槽位”,登录过期就换一个放进去。文章说“大多数人永远不会看到这些”,但正是这个不可见的设计,让共享智能体从脆弱变得可持续。
这个思路在企业 IT 里其实有很长的历史,只是换了个名字:服务账号(service account)。在 Active Directory、AWS IAM、Google Workspace 里,服务账号是一种不代表任何具体个人、而是代表某个职能的身份。员工离职时,服务账号不受影响;系统迁移时,服务账号可以被重新授权。Lee 做的事情,本质上是在智能体层重新发明了服务账号——因为智能体最初的设计假设(“用这个人的登录”)太像个人电脑,而不是企业系统。
技术上有更精确的对应物。Kubernetes 的 Service 是一个稳定的虚拟 IP,后面的 Pod 可以随时被替换、重启、迁移,调用方完全无感。Unix 的文件描述符让程序不直接操作磁盘,而是操作一个可替换的句柄。依赖注入(Dependency Injection)让对象不自己创建依赖,而是从外部接收——Martin Fowler 在 1990 年代推广这个概念时,核心论点就是“不要让调用方知道实现是谁”。Lee 的槽位把这些模式搬到了智能体的连接层:任务连接的是“能力”,不是“人”。
Aha 瞬间
“好的抽象不是让事情变简单,而是让复杂的事情有一个可替换的位置。槽位没有消除登录的复杂性,它只是把复杂性隔离在了正确的地方。”
发芽 03:“可靠地犯错”——编码规则的双重性
种子
文章里最诚实的一句话是:“Encoded rules have a cost: They can be reliably wrong.” 7 月迁移权限系统时,24 个 skill 全部变成私有,一个同事不得不从零重建日报。这是一个典型的“规则正确执行、结果完全错误”的案例。
James C. Scott 在《Seeing Like a State》(1998)里讲过几乎一模一样的故事:18 世纪普鲁士的林学家为了管理森林,把复杂的生态系统简化为“木材产量”这一个指标,结果导致单一树种种植、土壤退化、风暴一来整片倒塌。Scott 管这叫“高度现代主义的失败”——不是规则不理性,而是规则太理性,理性到忽略了情境。Every 的权限系统在 7 月犯的是同一个错误:规则说“创建者拥有”,于是公开频道里协作出来的 skill 全部归了个人。
但 Every 的处理方式值得注意。他们没有放弃规则,而是手动放宽了 9 个 skill,改了默认值,让公开频道里创建的东西归整个 workspace 编辑。这是一个很小的动作,但它揭示了一个制度设计的原则:可靠的规则不是不会犯错的规则,而是犯了错能被看见、能被修正的规则。如果权限是“看情况”的模糊判断,24 个 skill 变私有这件事可能永远不会被注意到。正因为规则写在代码里,错误才变成了一个可定位、可修复的 bug,而不是一个说不清道不明的“感觉不对”。
Goodhart's Law 说的是“当一个度量变成目标,它就不再是好度量”。Every 的版本更温和:当一个规则变成代码,它就会可靠地执行——包括可靠地执行错。这不是规则的缺陷,这是规则可以被审计的前提。
Aha 瞬间
“模糊的判断不会犯错,因为它从不给出确定的答案。编码的规则会犯错,但它的错误可以被看见、被定位、被修正——这就是制度比直觉更可靠的地方。”
你的思考空间
- 如果“借用别人的 agent”是 Plus One 最有价值的时刻,那个人智能体产品是否从一开始就找错了价值主张?共享是不是智能体的默认形态,而不是进阶形态?
- 槽位设计让任务从“人”解耦到“角色”。在你的组织里,有哪些工作流仍然绑定在具体的人身上,一旦那个人离开就会断掉?智能体能不能成为把这些工作流“服务账号化”的契机?
- Every 说“people will trust Every's taste and judgment”。当构建公司智能体的门槛降到足够低,差异化的确会从技术转向判断。但“品味”能被产品化吗?还是说它注定只能通过一个个具体决策被间接传递?
- 文章结尾留下了一个开放问题:智能体什么时候应该主动说话?人类同事的“察言观色”依赖大量隐性情境,而 agent 目前只能靠规则和小模型判断。这个问题的边界在哪里——是技术问题,还是组织文化问题?
- 如果编码规则会“可靠地犯错”,那组织应该建立什么样的机制来发现和修正这些错误?Every 的做法是手动修正加改默认值,这能规模化吗?