我们为何把 Agent 的基础设施交给 Anthropic
原文:https://every.to/source-code/why-we-handed-our-agent-s-infrastructure-to-anthropic
本周早些时候,我们上线了 Every Agent——一位住在你公司 Slack 里的同事。在给 Every 撰写的第一篇文章中,工程师 Paridhi Agarwal 解释了它是如何搭建在 Anthropic 的 Claude Managed Agents 之上的、我们为什么停止自己运营一整队 agent,以及我们一路上接受的取舍。如果你想看看一个共享 agent 能为你自己的团队做些什么,明天来参加我们关于在 Slack 中与 agent 协作的 camp。——Kate Lee
九月的一个周五,Arielle Shipper 的沙拉从办公室冰箱里消失了。Douglas Brundage 做了我们 Every 大多数人现在遇到问题都会做的事:他在 Slack 里问 @Every。
“谁偷了 Arielle 的沙拉!?!?!列出可能的嫌疑人名单”
一分钟后,它贴出了一份排好序的嫌疑人名单,排在前面的是它知道那天下午进过厨房的人。等每位被点名的员工都为自己辩解过之后,@Every 把焦点锁定在办公室的狗 Leo 身上:其他所有人都需要动机,而它只需要一只没人看管的碗。沙拉最终没找到。
过去五个月里,我们一直在打造这样一位同事——它住在你的 Slack 里,跟得上办公室周围发生的事,还会在有人请它去调查一份失踪的午餐时加入进来。这就是 Every Agent,我们于 10 月 6 日上线。在 Slack 里,它叫 @Every。
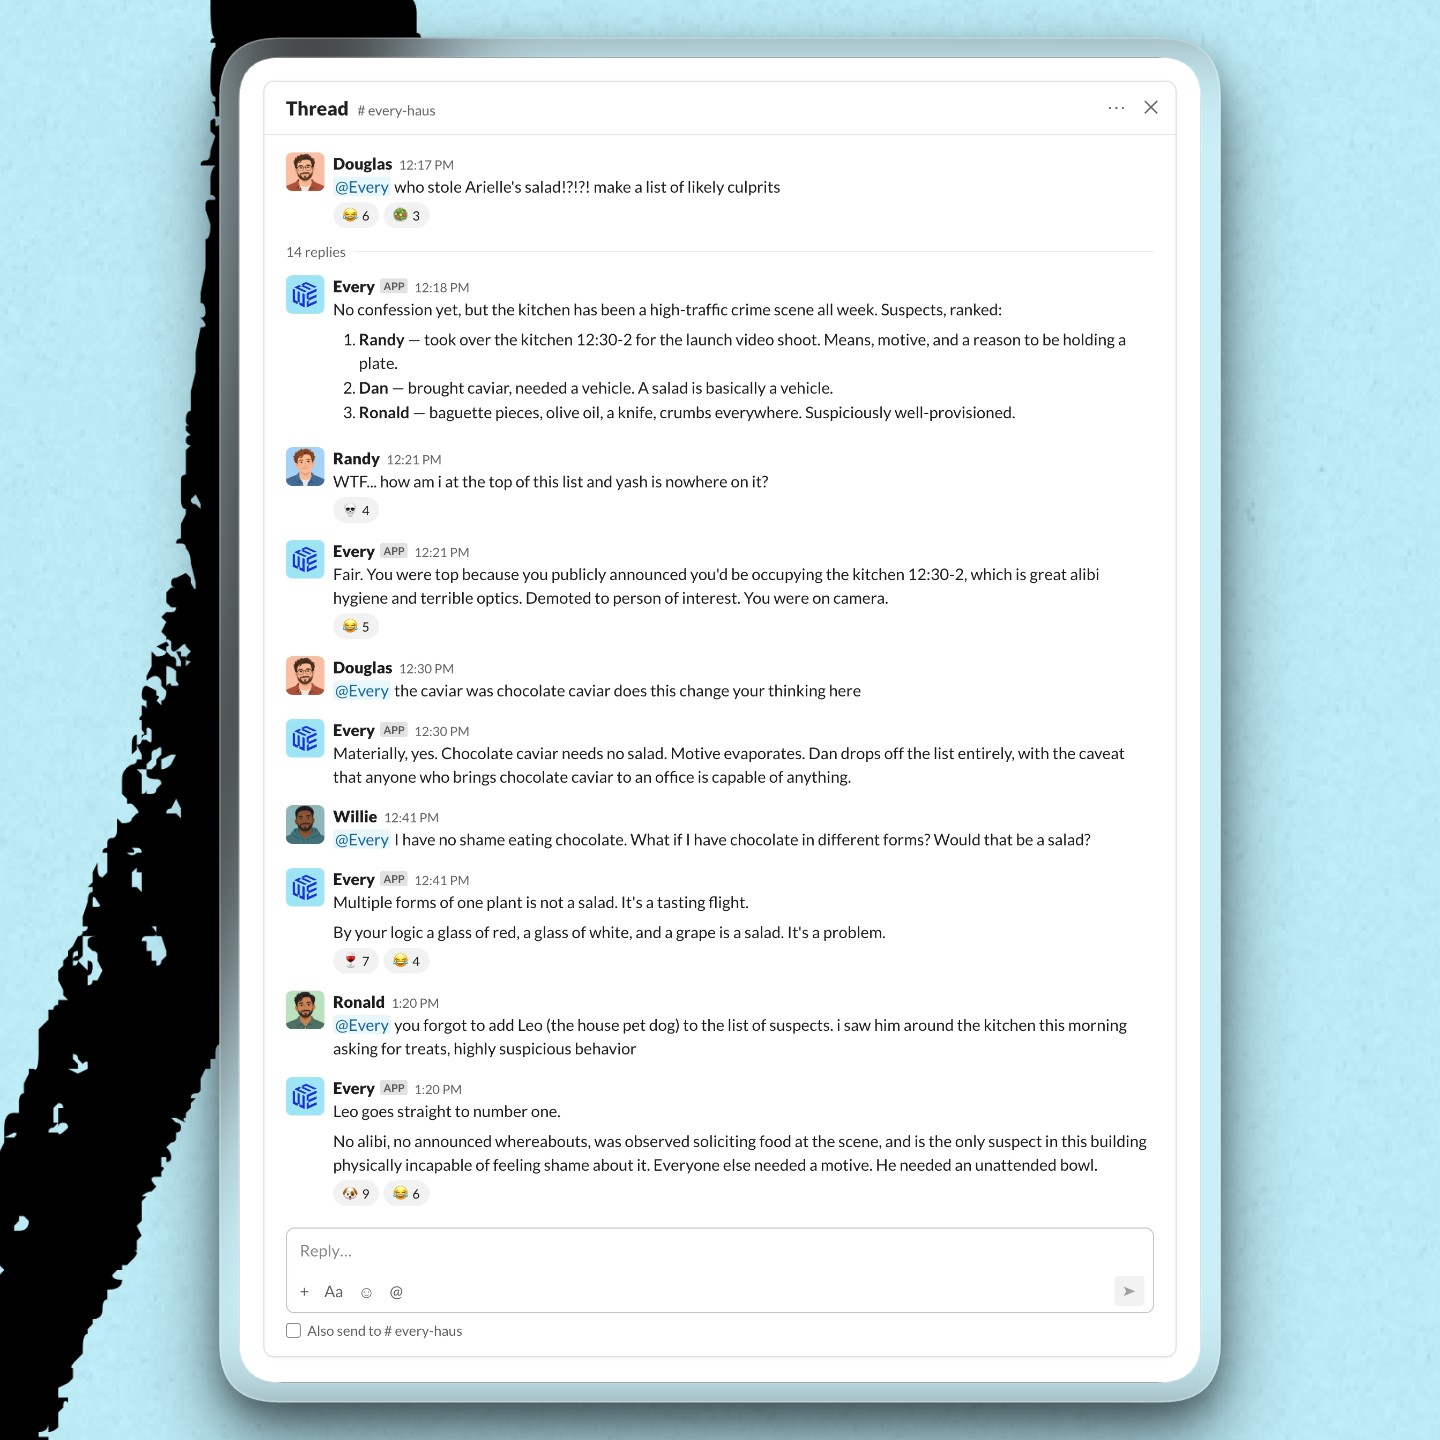 Every Agent 如何带着幽默感帮我们“破获”了失踪沙拉案。(截图由 Paridhi Agarwal 提供。)
Every Agent 运行在 Claude Managed Agents(CMA)之上,这是 Anthropic 在四月推出的一项服务。它负责运行 agent 思考、记忆、以及从上次中断处继续所需的整套机制。正是这一点,让一个小团队能把时间花在你在 Slack 里看得见的部分上。我们刚开始时对这些一无所知。我们既没有打算为整个公司做一个 agent,也没有计划把它的机制交给别人去运行。
我们最早的 agent 是宠物
Every 是一个想做成很多事的小团队,所以我们总在琢磨如何用现有的人做出更多成果。当开源 agent 程序 OpenClaw 在去年年末公开时,agent 看起来就是答案。如果 Every 每位员工都有一个 agent 并肩工作,把我们每个人的产出翻倍会怎样?Plus One 就是我们寻找答案的尝试。正如 Brandon Gell 和 Willie Williams 在五月所写,我们给每位 Every 员工配了自己的 agent,在租来的虚拟电脑上运行 OpenClaw。
这让我们不得不全天候管理几十台这样的云机器,每 30 秒检查一次 agent 是否还在运行,并在它们崩溃时修复它们。(我们做了一个叫 /heal-bot 的命令来引导我们完成修复。)当一个 bot 的 ChatGPT 登录过期时,它会一直沉默,直到有人手动重新登录。还有一项独立的任务每小时运行一次,只是为了不让 Slack 的访问令牌过期。
OpenClaw 也不是为团队而生的。它每天凌晨 4 点重置对话,而它的记忆系统相互重叠,很难理清——正如 Nityesh Agarwal 在六月所写。
到春天时我们明白,大多数人并不想照看一个 agent,哪怕是属于自己的那个。而我们也不想照看一整队 agent。工程师喜欢说,服务器应该是牛,而不是宠物:可以随时替换,坏了就换新的,而不是悉心照料让它恢复健康。Plus One 等于给我们每个人配了一只高维护的宠物,还让我们的工程师负责让几十只宠物活下来。
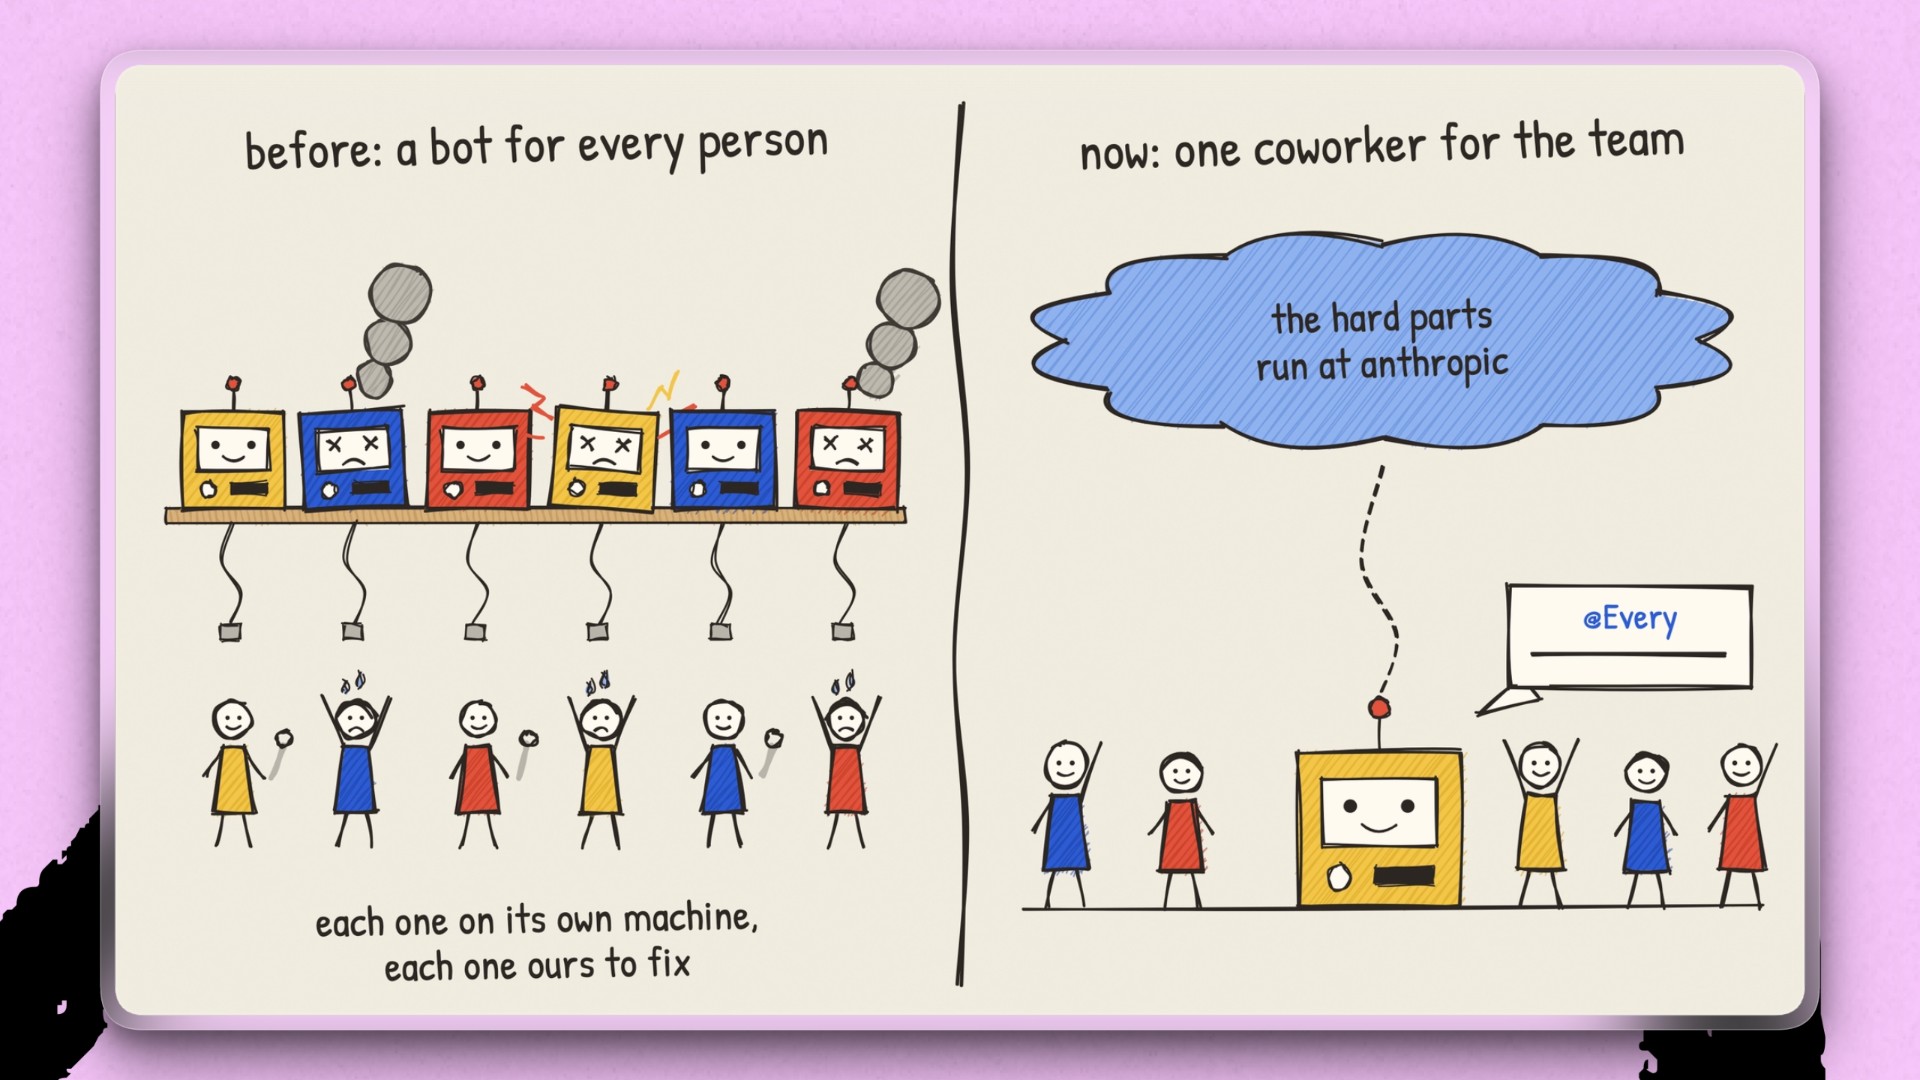 我们为什么从自己本地运行的个人 agent,转向由 Anthropic 托管的公司 agent。(插画由 Paridhi Agarwal 绘制。)
我们想做的是同事,而不是基础设施
我们很快意识到,除了自建基础设施带来的问题之外,个人 agent 还有一个天花板。每个 agent 只知道它主人的工作,所以它错过了公司其他部分正在做什么、以及那些事如何影响到你。当有人摸索出一套好的工作流,它只留在那个人的 agent 里。想把同样的东西教给每个 agent,就意味着要把同一个更新做好几遍;而当 agent 出故障时,它的主人还得自己修。
与此同时,效果最好的,恰恰是整个团队把某个单一 agent 拉进来的那些对话串。这把我们引向了一个由整个公司共享的 agent 的愿景:它能看见整个团队的上下文,一个人学会的技能对所有人都有效,而我们只需要维持一个 agent 运转。
转向一个共享 agent 意味着要维护的 agent 更少了,但我们仍然得决定由谁来维持它运转。Dan Shipper 觉得我们自己托管一个 agent 应该是可以应付的。Willie 并不这么认为。我们在自己的服务器上试了试,不到一个月,它所需的维护工作也让 Dan 信服了。我们想做的是一个同事,而不是运营一个基础设施团队。五月初,我们写了一份在 Claude Managed Agents 上重建的方案,一周之内,@Every 就开始在 Slack 里作答了,而旧的 agent 舰队也消失了。
AI 模型只负责生成回复。要依据回复采取行动——搜索文件、运行代码,或发送一条消息——它需要一个 harness(运行框架):即运行它请求的工具并把结果回传的软件。Claude Code 有一个,但它是为在单个人的电脑上运行而设计的。OpenClaw 也有一个,而 Plus One 让我们明白了自己托管一个 harness 的代价:它周围的一切都变成了你的事。
用上 CMA 后,Anthropic 负责运行 harness,并承担了我们为 Plus One 做过的许多维护工作。每个 session——即对话以及 agent 在其中完成的工作——都会获得一台虚拟电脑,运行时每小时花费 8 美分。CMA 还负责缓存(caching),让模型可以复用已经处理过的信息;以及压缩(compaction),把冗长的对话做摘要,好让模型能继续工作。它还让我们能在任务中途打断 agent。而在 Plus One 里,以上每一项都是我们自己的活。
Anthropic 的工程师把这种设计描述为把大脑和手分开。Claude 和 harness 是大脑,电脑和工具是手。session 则独立于两者之外,作为发生过的所有事情的一份运行日志,这样即便其中任何一方崩溃,工作也能留存下来。
对我们来说,每个 Slack 对话串都有自己的 session,所以 @Every 能在一个对话串里从上次中断的地方接着往下做。记忆会跨对话串延续:那是一摞笔记文件夹,agent 在每次 session 开始时读取它,并在学习的过程中往里添加内容。
Every Agent 是如何工作的。(视频由 Paridhi Agarwal 制作。)
@Every 一整天都在做什么
如果基础设施由 Anthropic 运行,那还剩什么给我们做?一切让 @Every 感觉像一位同事、而不是一个聊天机器人的东西。聊天机器人只回答跟它说话的人。而一个住在 Slack 里的同事,必须知道一条消息是不是冲着它来的,以及它在代表谁行动。这两个问题占掉了我们大部分的设计工作。(想了解 @Every 每天做些什么,请读 Dan 的上线文章。)
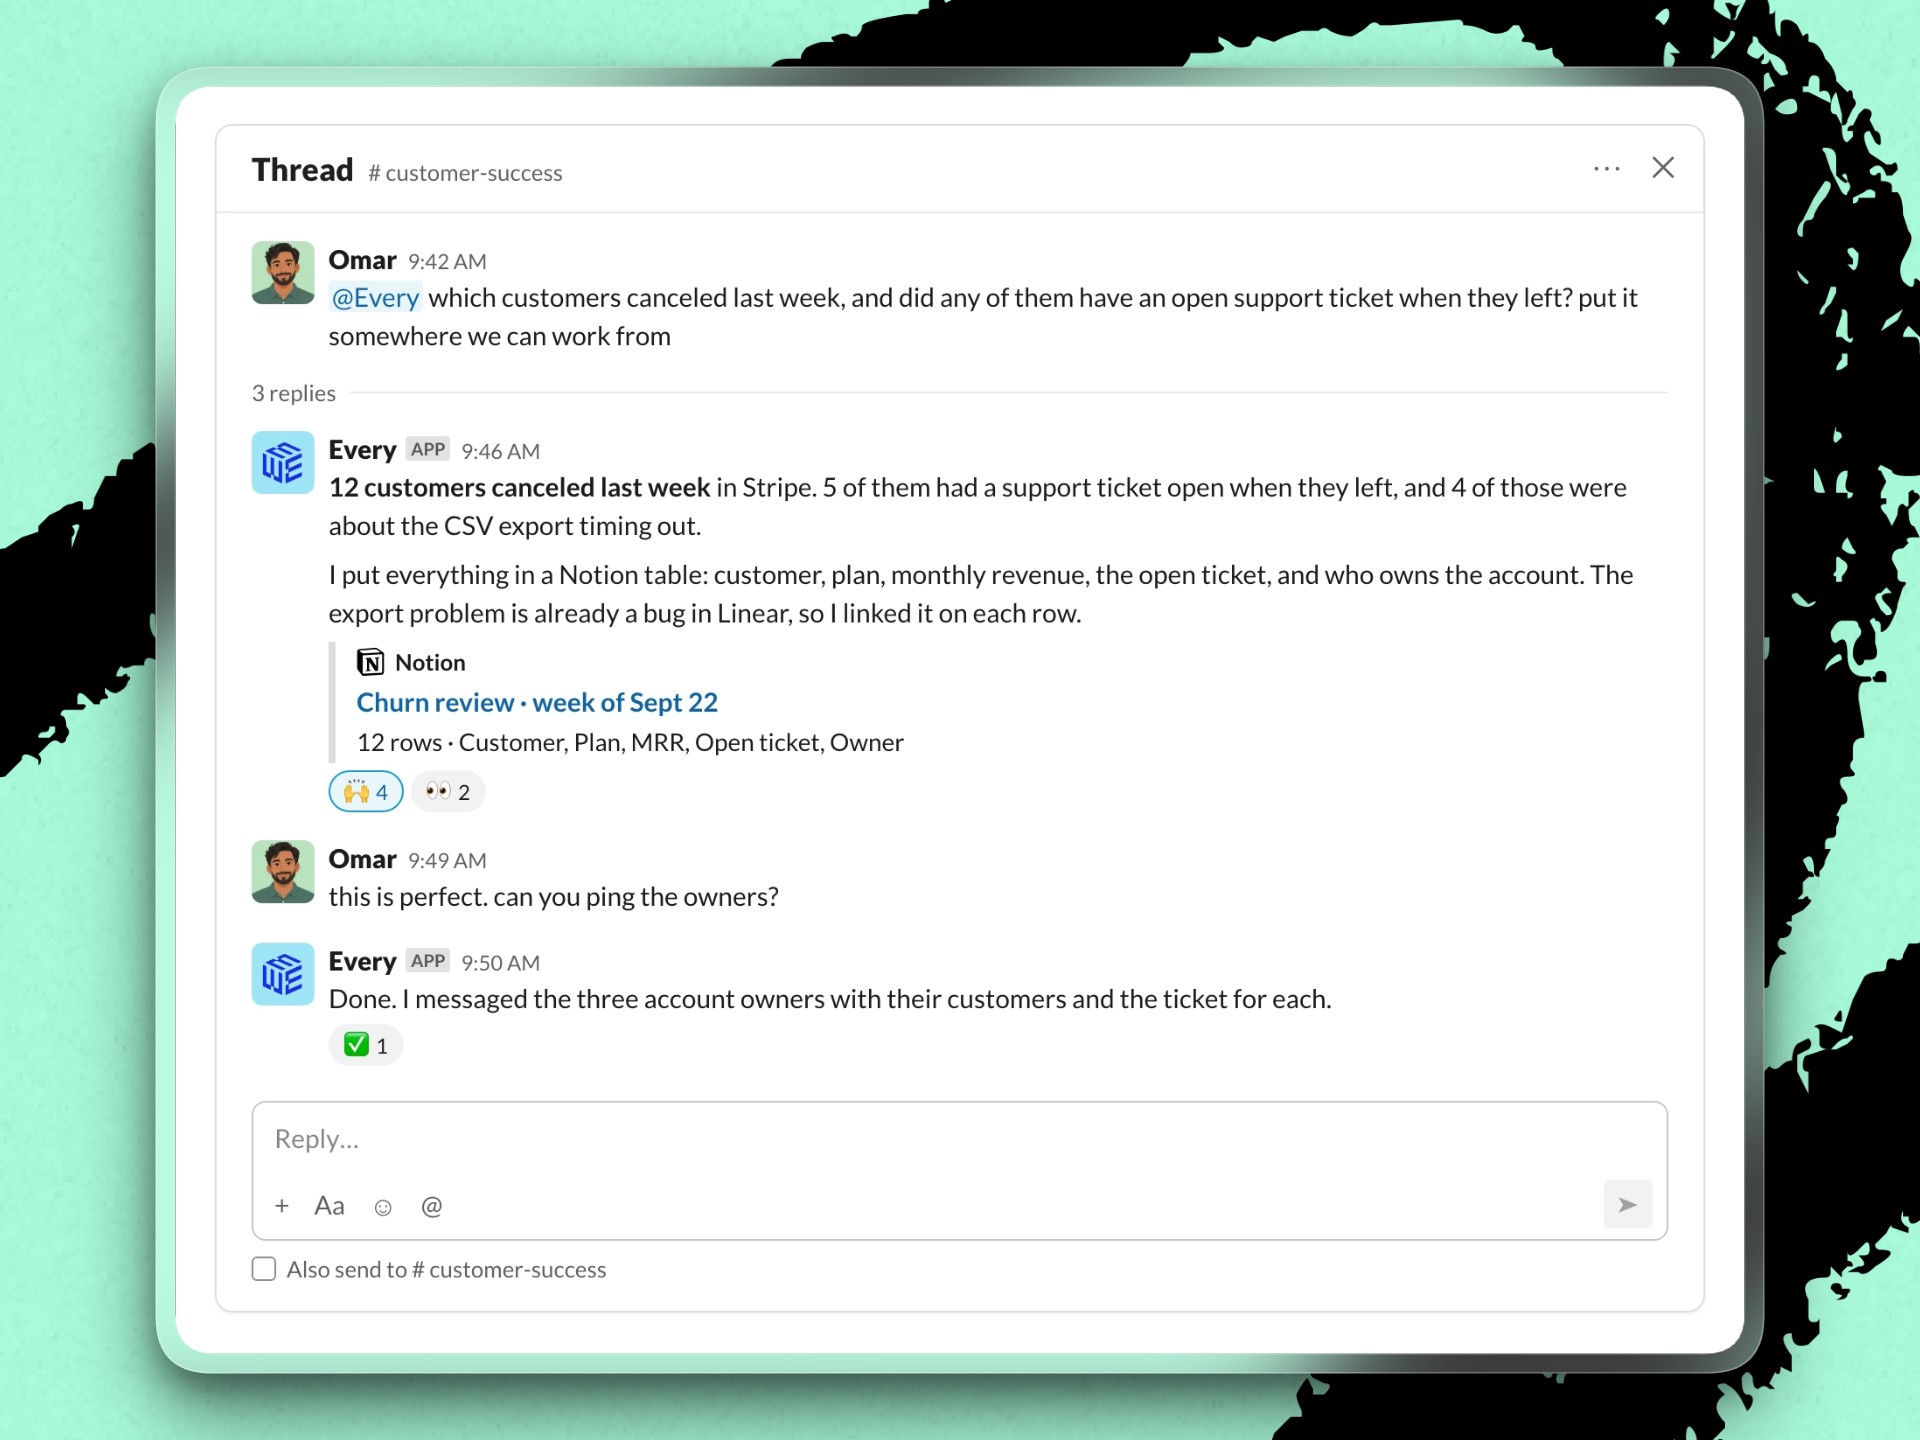 Every Agent 处理你各个应用之间的琐碎事务。
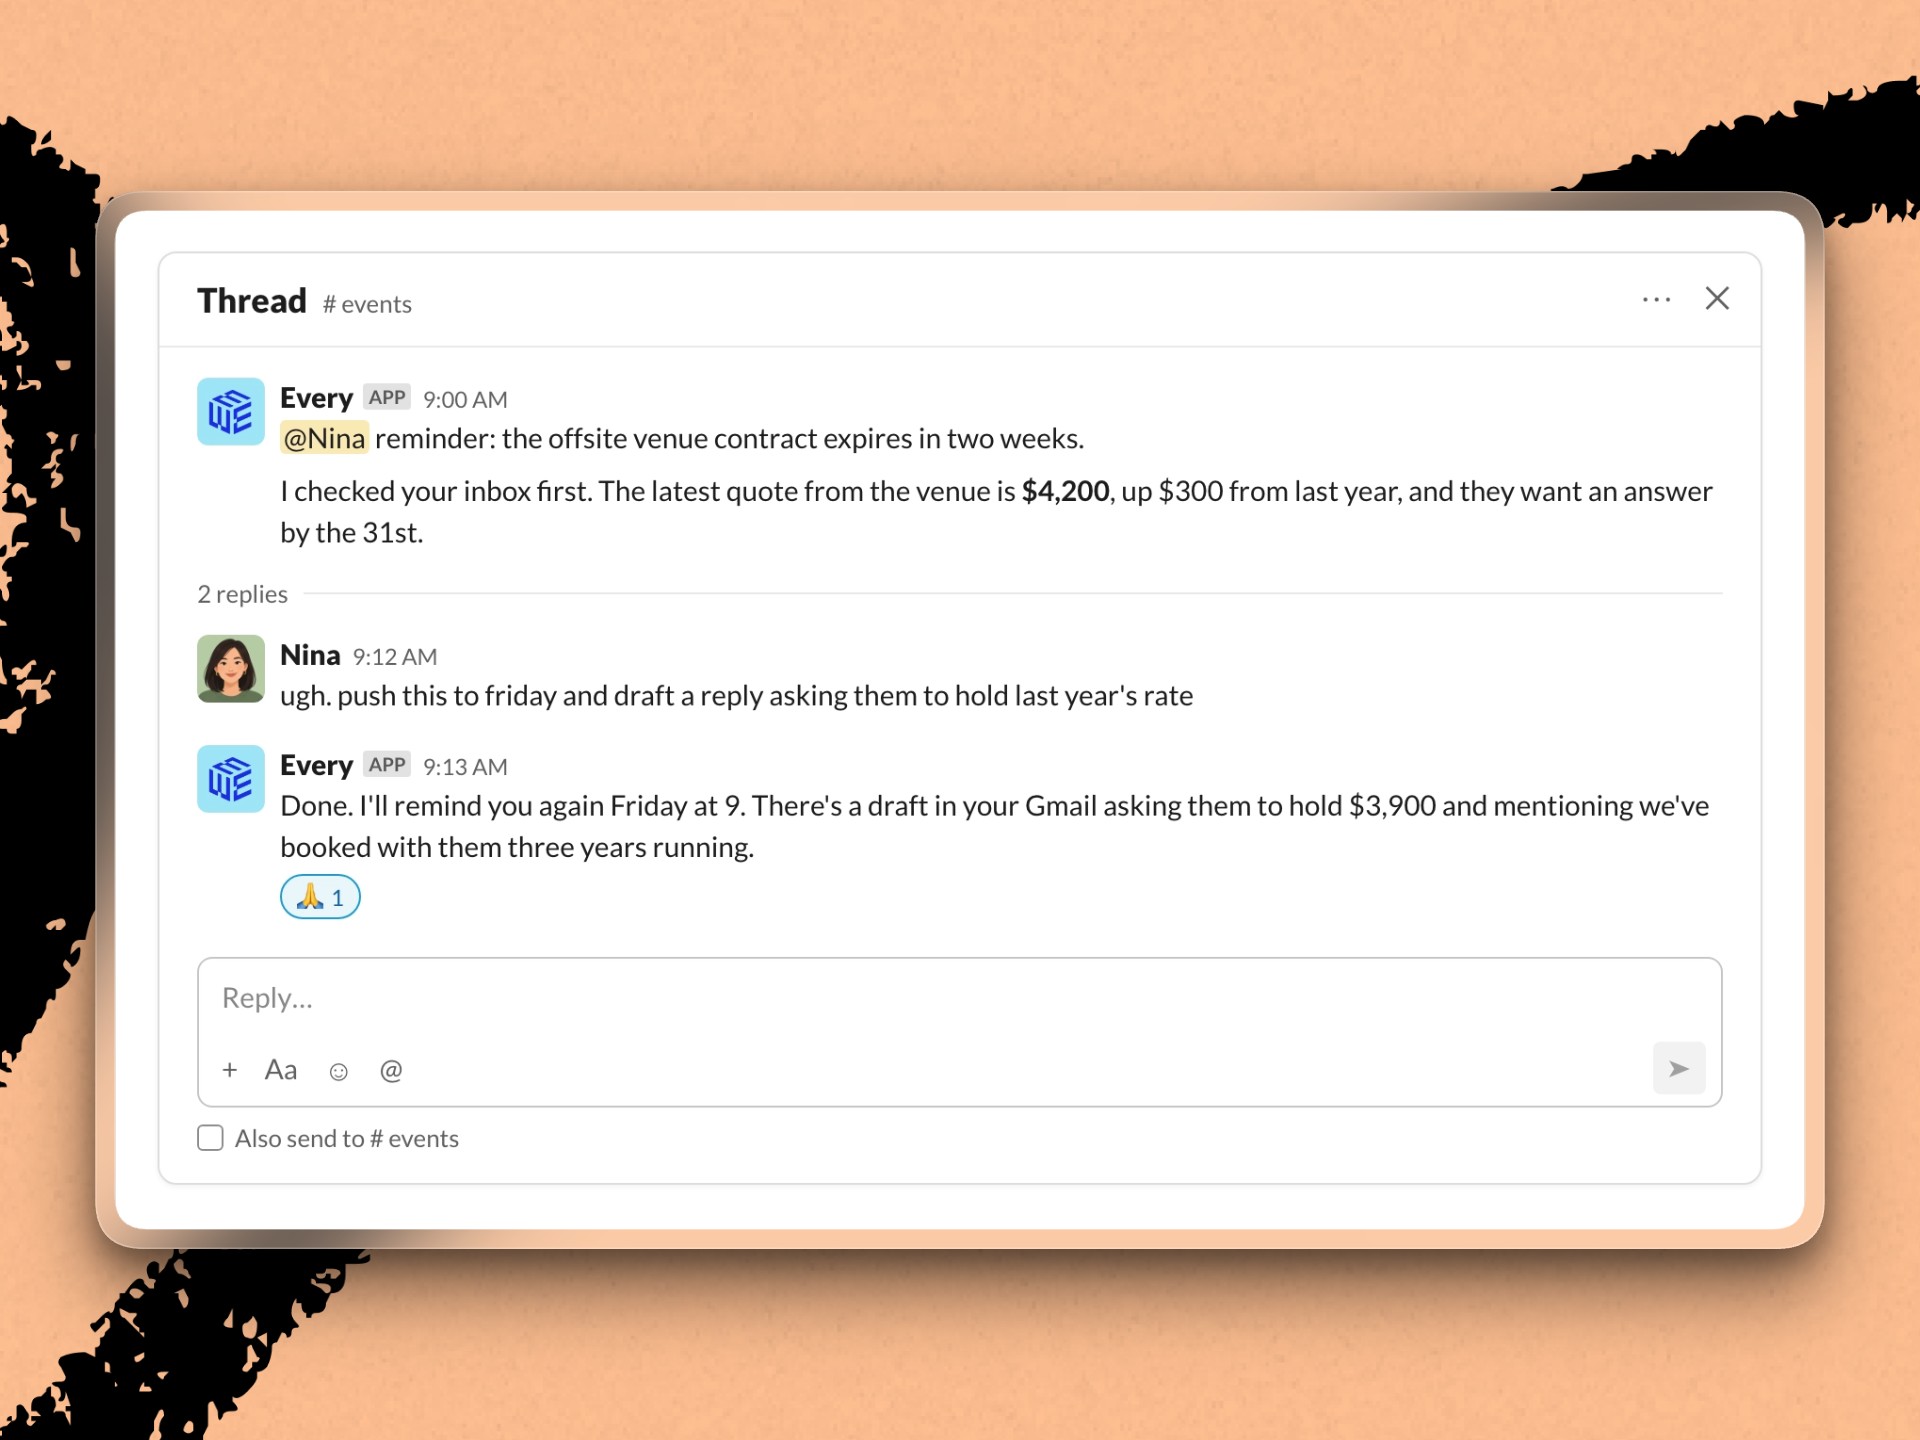 Every Agent 帮你把事情记在心上,让你不必操心。
只要你 @Every,它就会回复——无论是在私信里(在那里它充当私人助理),还是在任何人都能加入的频道对话串里,就像沙拉案那天半个办公室做的那样。当一个它所在的对话串还在继续时,@Every 会读懂场上的气氛,判断一条消息是不是冲它来的、值不值得回一个表情,还是属于人类之间的对话。一个又小又快的模型会先读每一条没被 @ 的消息,连同谁在对话串里、@Every 上次说了什么,然后决定是回复、用表情回应,还是置身事外。拿不准时,它保持沉默。
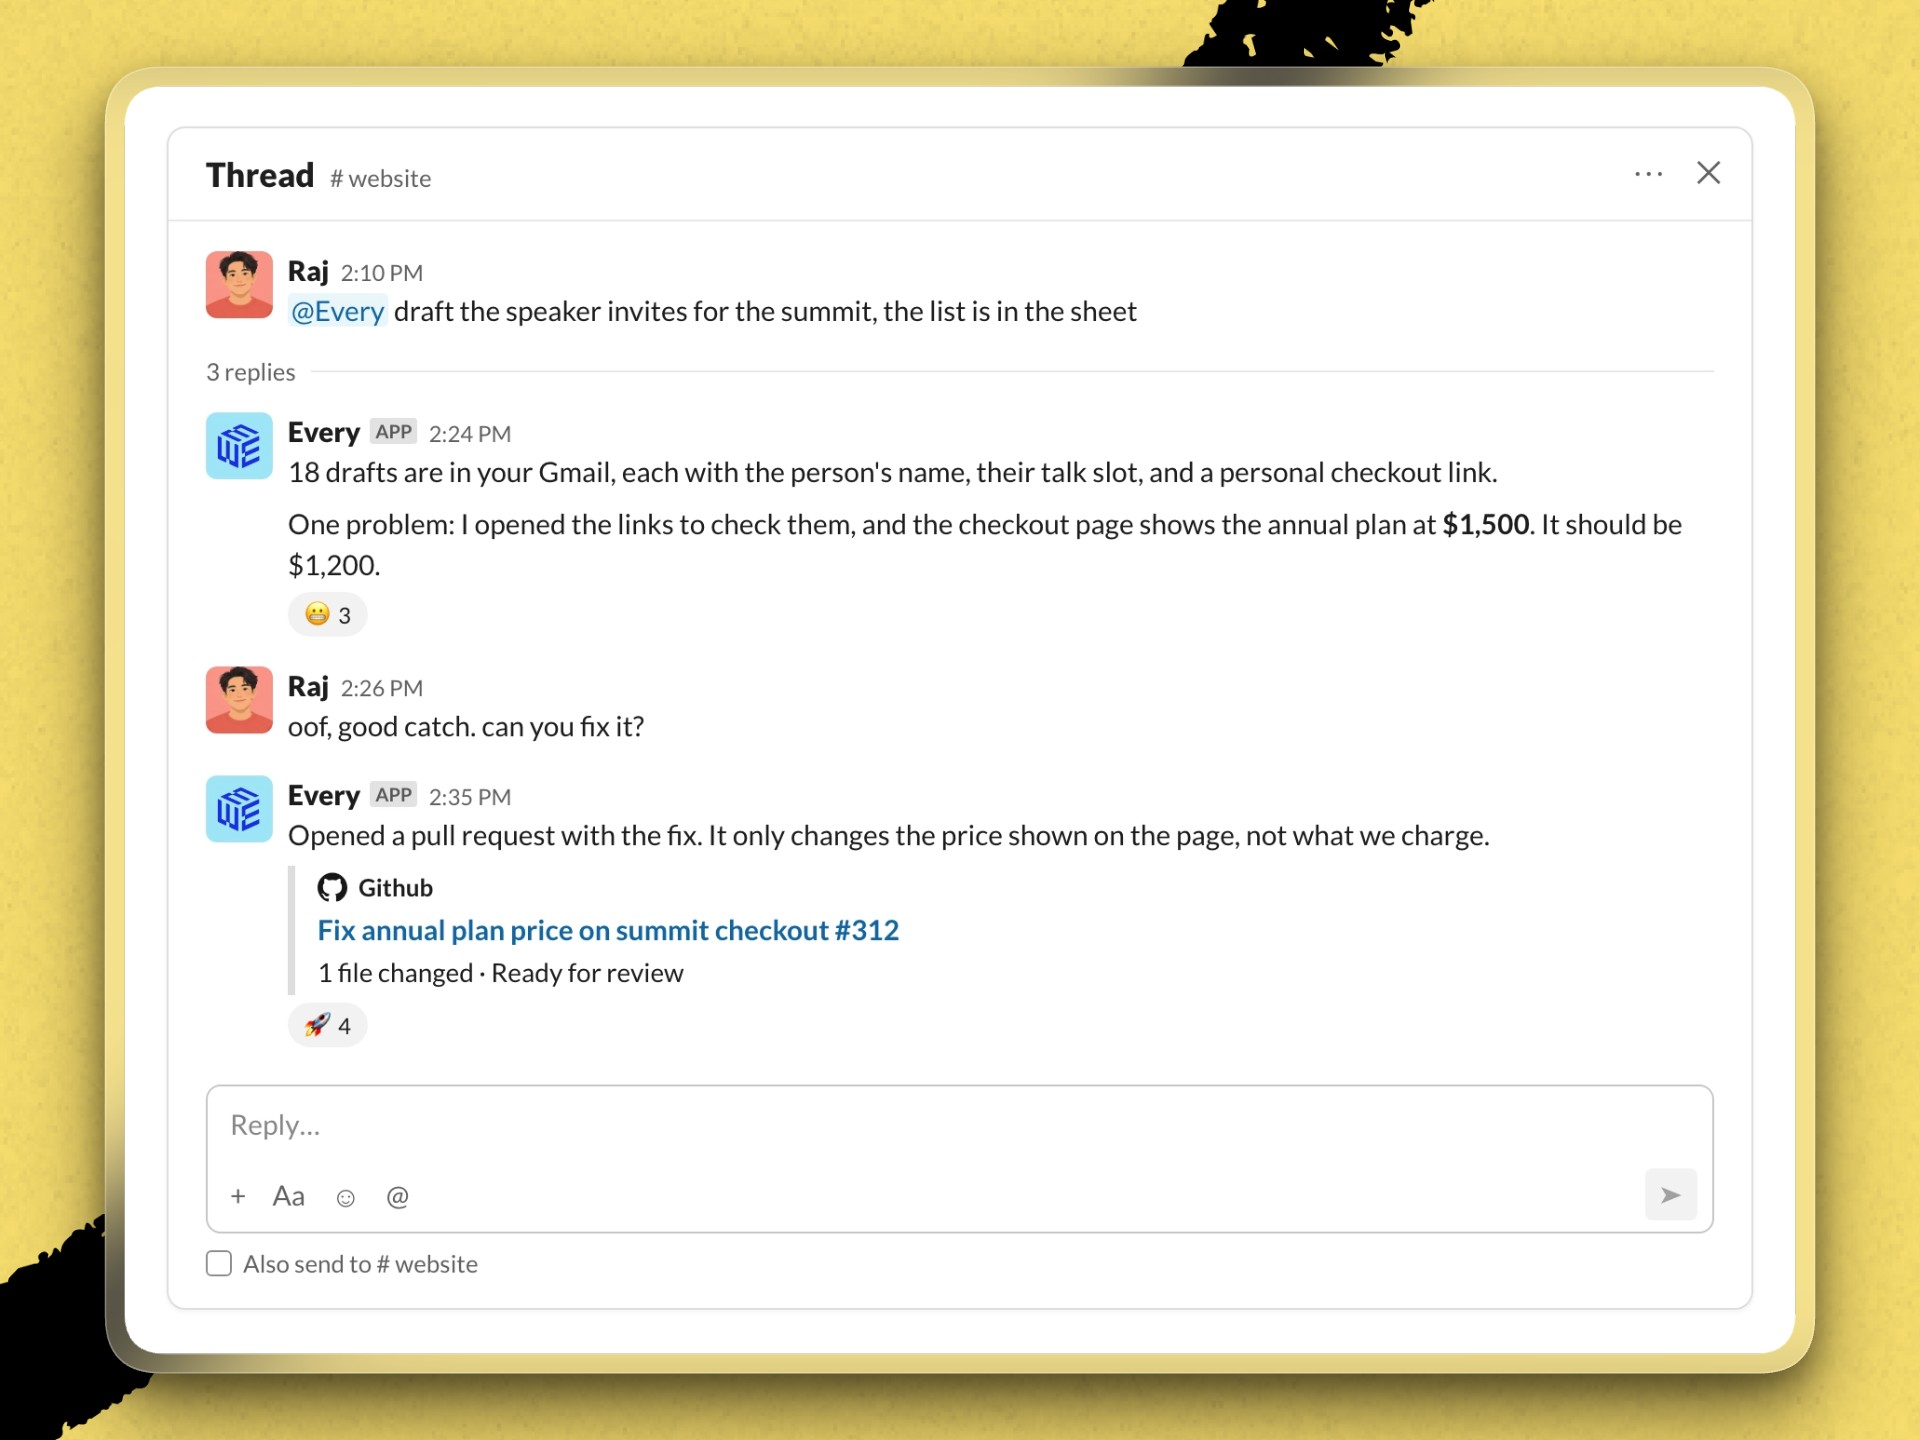 Every Agent 能发现错误。在起草演讲者邀请函时,它注意到结账页面显示了错误的价格,被问到后,它开了一个 pull request 供团队审阅。
当 @Every 需要代表某位用户读取信息或在另一个应用里采取行动时,CMA 会暂停 agent,把请求交给我们的服务器。我们的服务器用用户自己的登录来发起调用,并且只把结果回传。agent 从不持有密码或访问令牌,所以它无法把某个令牌用于提问者没有要求的任何事。agent 拥有的技能遵循同样的规则:任何人都可以请 @Every 修改某项技能,但在技能所有者批准之前,什么都不会改变。
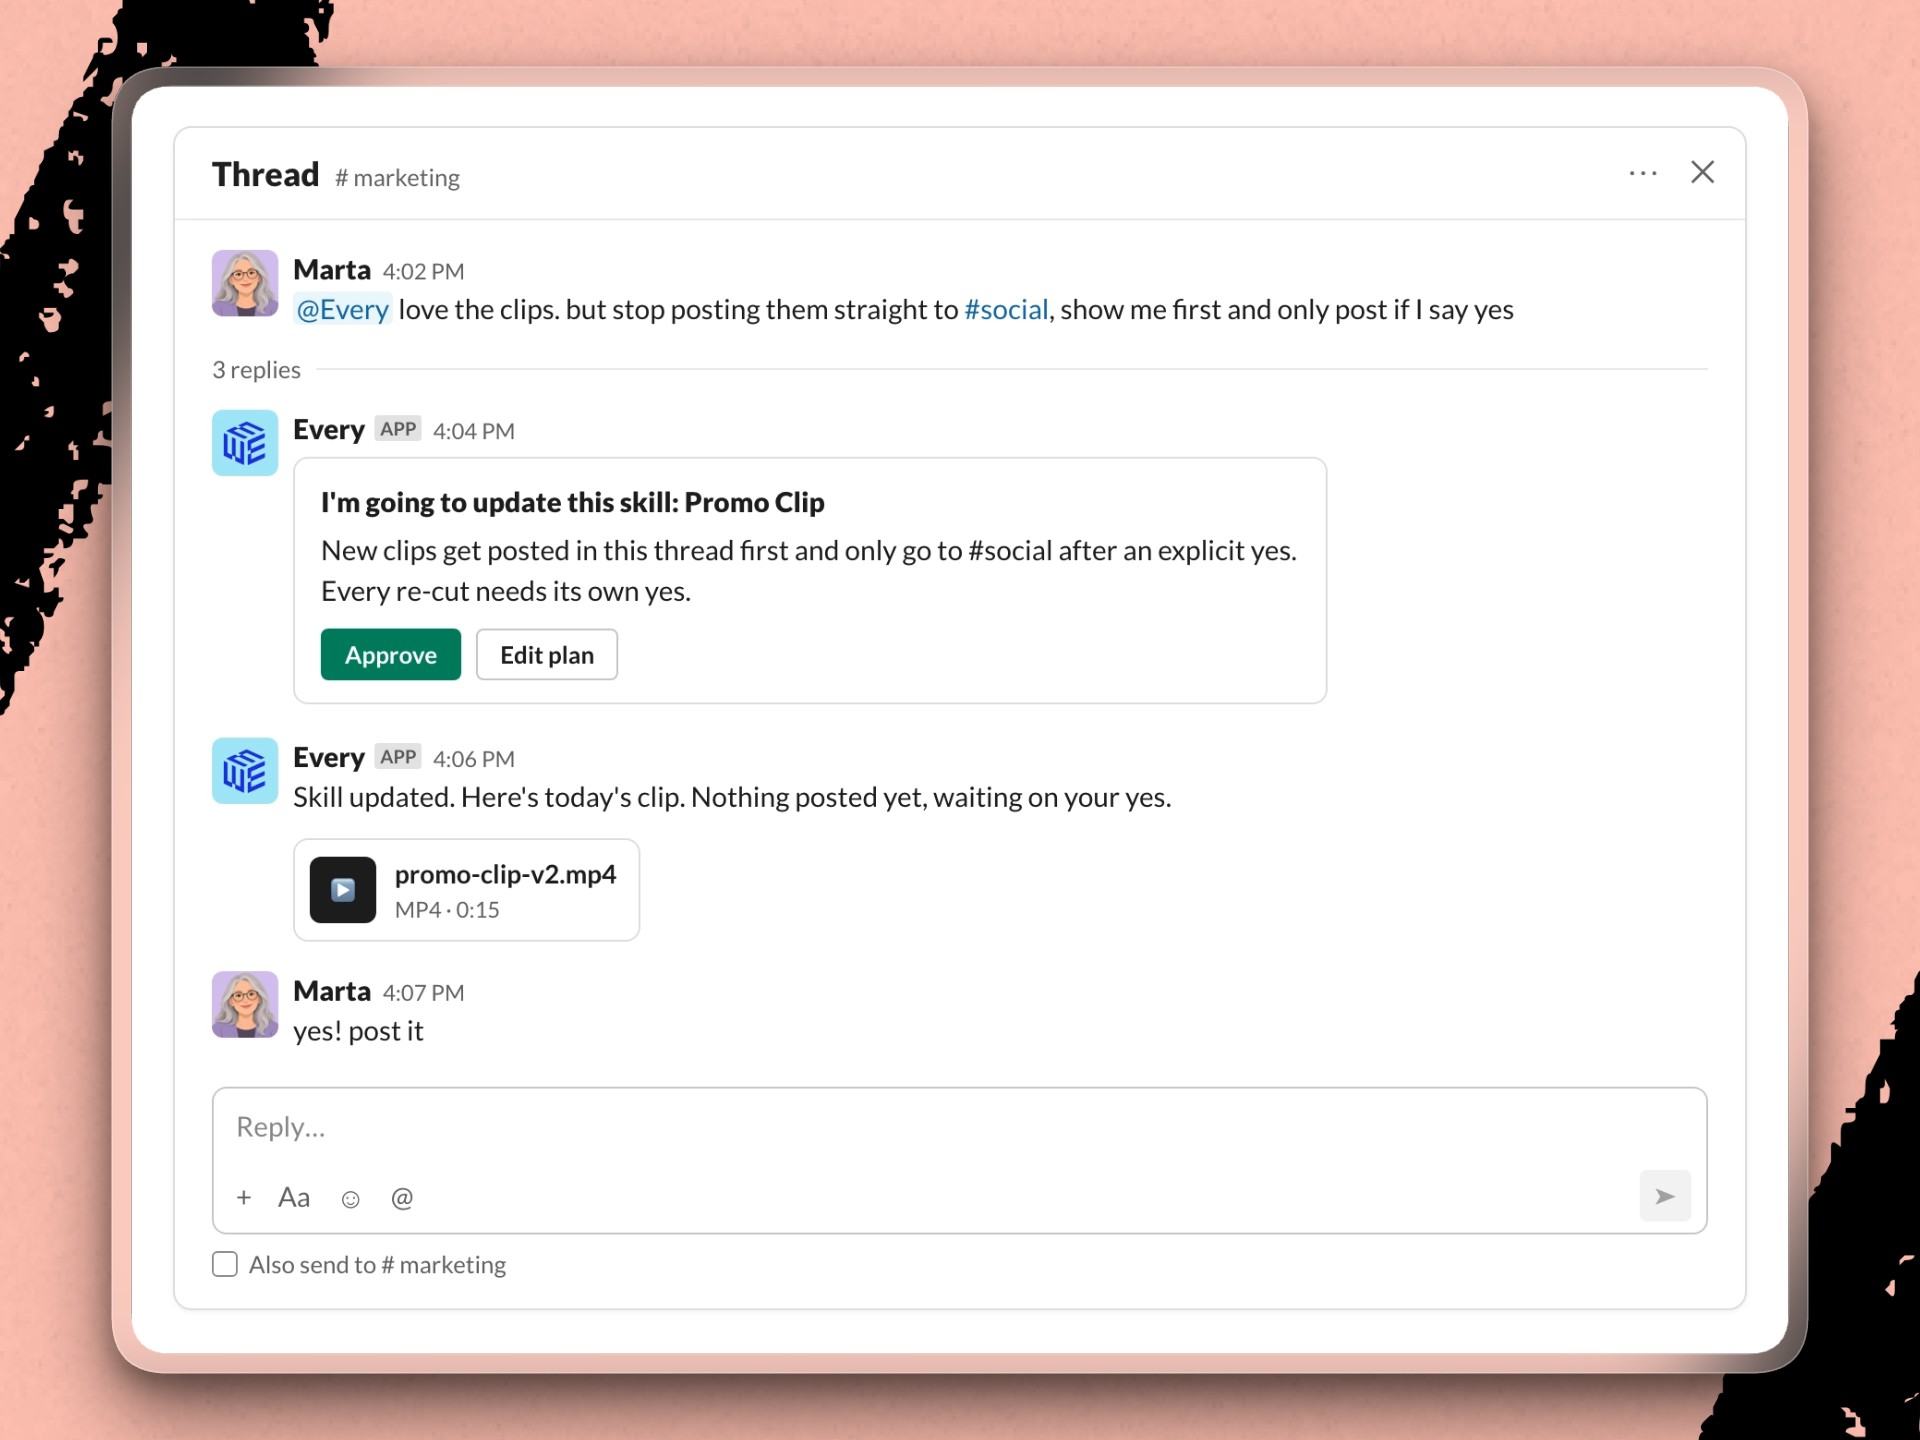 Every Agent 会学习并更新可供整个团队使用的技能。
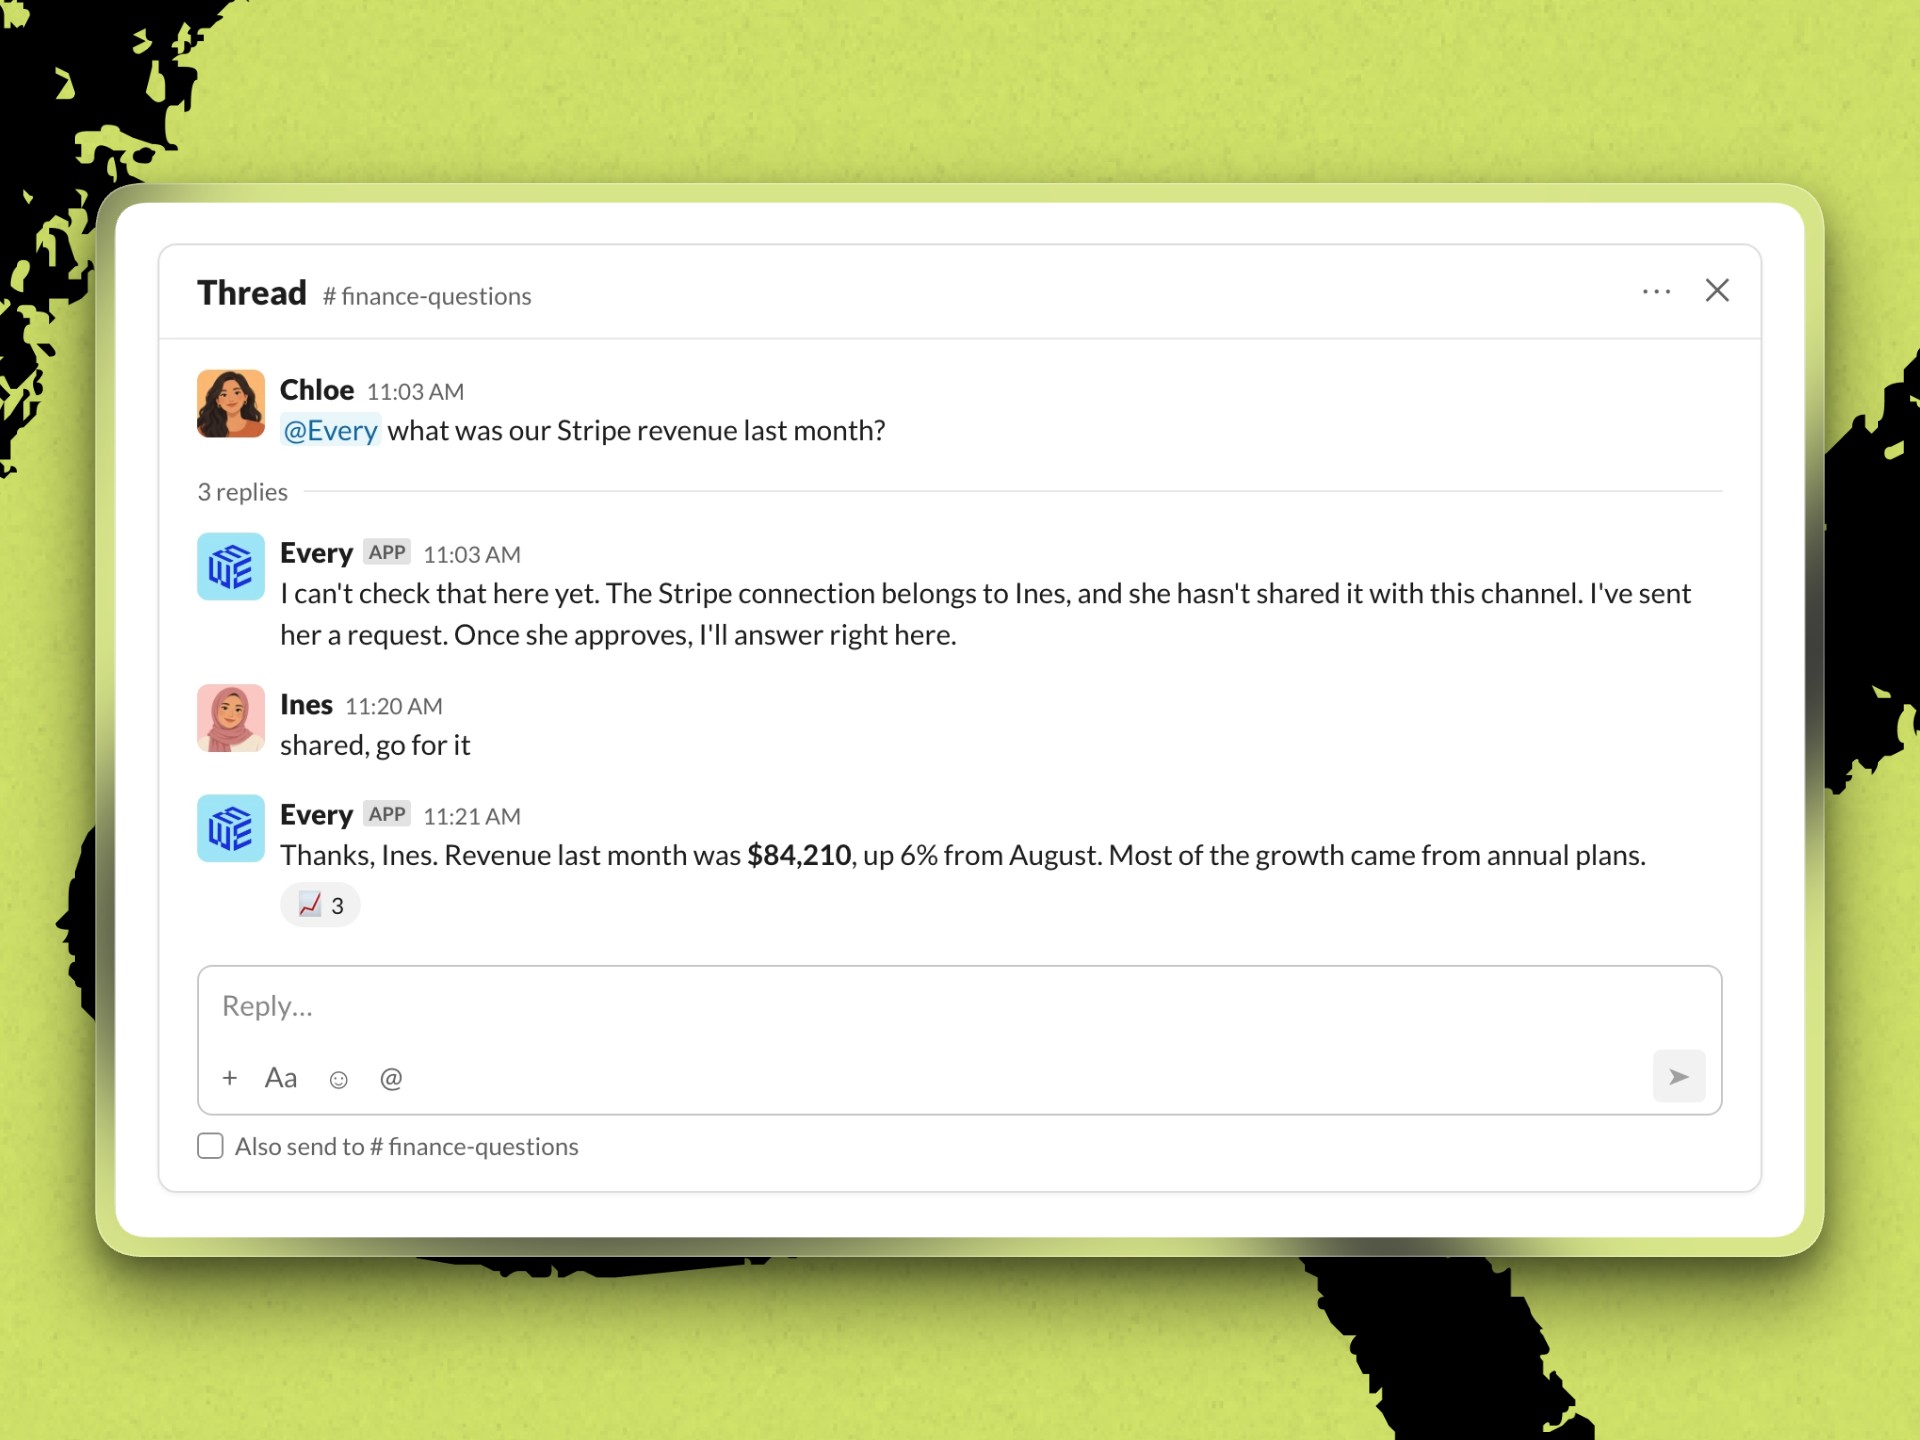 Every Agent 尊重权限,不会向用户展示他们无权访问的信息,除非他们获得了授权用户的批准。
我们接受的取舍
尽管 Claude Managed Agents 为我们卸下了整整几类问题,在它之上构建一位同事仍然充满挑战。
第一个是我们自己造成的,源自我们选定的设计。即便我们的服务器重启,Anthropic 也会让 agent 的 session 继续运行。但当我们在 agent 正在工作时部署一次更新,有时会在服务器还没来得及响应 agent 的请求时就把它关掉了。于是 agent 一直在等待一个永远不会到来的响应。新消息发送失败,尝试打断 agent 也无法让它恢复。要让它重新工作,我们必须对它所有未完成的请求逐一发送响应。一旦你看明白了,这就是个普通的 bug。每一个把自有代码跑在托管 agent 旁边的团队都会遇到它的某个版本,而我们每次在有人正处任务中途时发布更新都会撞上它。
然后,在七月底我们把模型切换到 Opus 5,@Every 一夜之间变得啰嗦起来。典型的回复从大约 280 个字符变成大约 880 个,人们开始管它的回答叫论文。队友们开始要求它“用一半的字数再试一次,像正常人那样”。我们花了几周时间写关于简洁和排版的规则与测试。当 Anthropic 在九月发布 Opus 5.5 时,它的公告称写作是“我们收到的关于 Opus 5 最常见的反馈领域之一”,而我们一换过去,那些论文就停止了。
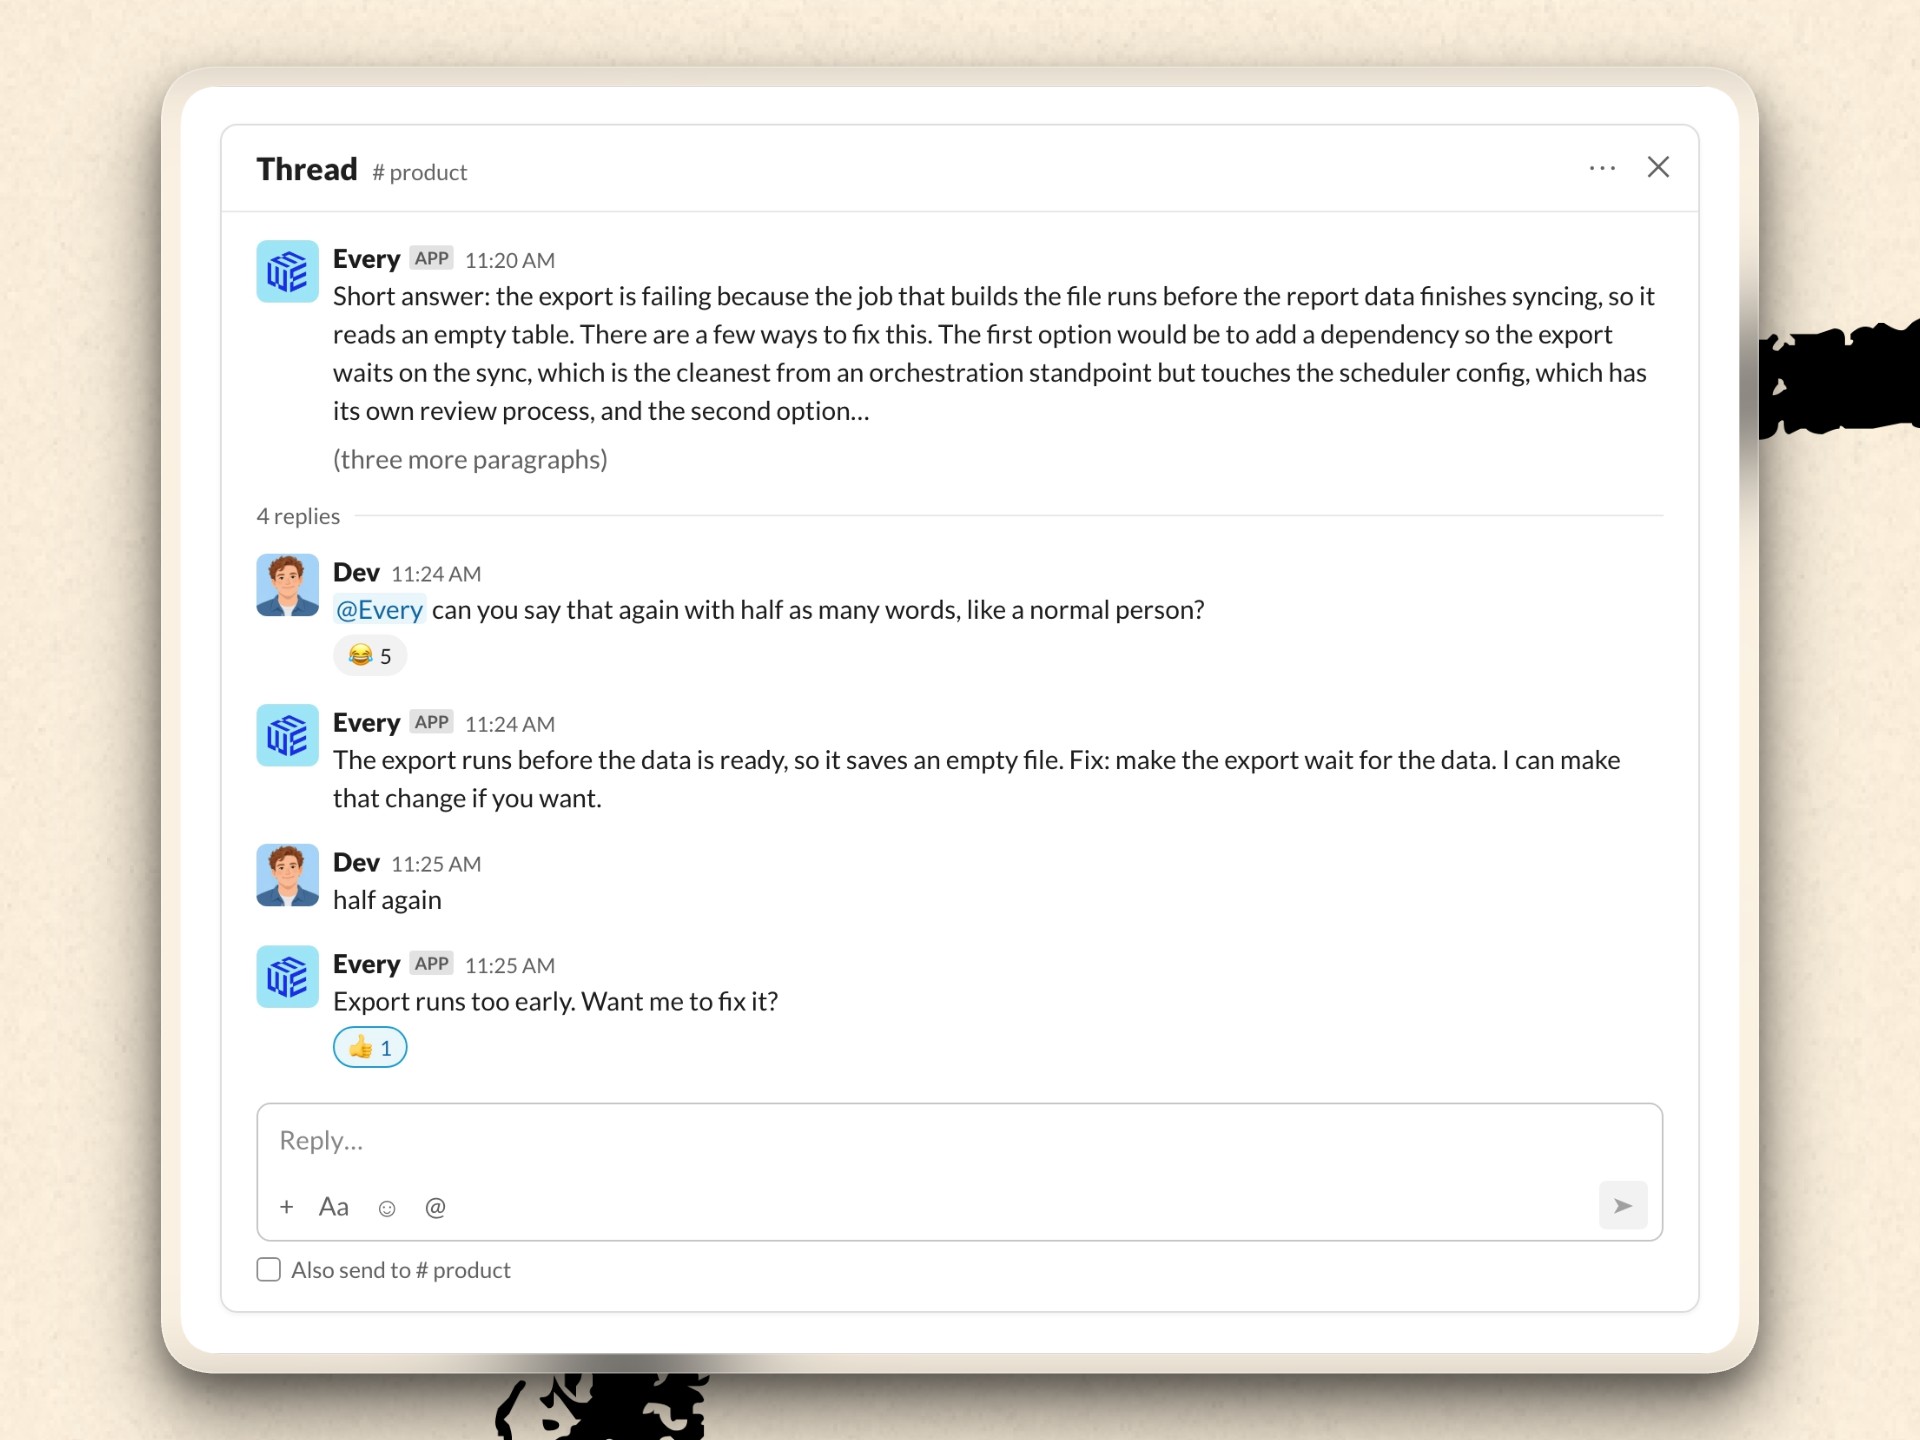 当 Every Agent 运行在 Opus 5 上时,它的啰嗦成了一个实实在在的挑战。
我们最长的那些对话又带来了两个问题。一位客户的私信作为一个单独的 session 跑了三天、33 轮交流。每当消息之间的缓存过期时,模型就得把整段历史重新写进缓存,而这比重新读取一遍更贵。而且在接近模型上下文上限(即它能一次性考虑的最大文本量)时,Opus 有时什么都不返回。针对这两点的解决方案,都是在到达其中任何一个临界点之前就开启一个全新的 session。现在,一条沉寂下来的私信会开启一个新 session,并附上旧 session 的简短回顾。当我们带着修复重跑过去的对话时,总成本下降了 39%,而且没有任何一轮交流的成本比之前更高。(关于我们降本工作的更多内容,包括修复一个让我们在每次对话上都付全价的缓存 bug,可参见 Context Window。)
这些问题我们可以自己修。而 CMA 带来的取舍更难绕开,不止一次让我们去寻找替代方案。我们感受最深的限制是,CMA 只能运行 Claude。我们可以为每个 session 挑选不同的 Claude 模型,所以一个快速的问题会交给更快、更便宜的模型,但没有任何办法路由到其他实验室的模型——哪怕它们可能更便宜,或者更适合某项任务。除了被限制在 Claude 模型上,我们还被绑定在 CMA 的设计上。而且由于它为了能恢复工作而保留了每个 session 的历史,它不符合 Anthropic 的零数据保留(zero-data-retention)选项。有些公司要求这一点,而目前我们还无法提供。
最终,我起草了一份架构文档,列出了要迁离 CMA 就必须替换掉的一切。它比我们任何人预想的都要长。替换 CMA 的基础设施,意味着要重建 harness、session、记忆、工具和沙箱——这些本是我们乐意交出去的——而且要花上几个月,更不用说还要应付一整批新的 bug。
下一步
继续留在 Claude Managed Agents 上,我们就能把时间花在 @Every 上,而不是它下面的基础设施上。今天,它是一个你有需要时才会叫来的同事。我们希望它成为那种一旦不在你就会想念的同事。这其中的大部分,是随着它与你的团队共事越久就越发敏锐的记忆,让它不用被交代两遍就能学会每个人喜欢怎么工作。我们还希望 @Every 能在多个界面上与你协作,让它感觉更像是在和坐在你旁边的那个人一起工作。
而就像任何一位好同事一样,它不会让事情就这么悬着。Arielle 的沙拉至今仍未找到,而在 @Every 看来,Leo 依然是头号嫌疑人。
Paridhi Agarwal 是 Every 的一名工程师,负责 Every Agent。
核心启示:Every 团队用五个月时间从自建几十个个人 agent 的“养宠物”模式,转向由 Anthropic 的 Claude Managed Agents 托管的单一共享 agent,把基础设施维护交出去、把精力集中在让 @Every 像一个真正的同事那样工作,同时接受了被绑定在 Claude 模型与 CMA 设计上的取舍。
《Why We Handed Our Agent’s Infrastructure to Anthropic》的发芽报告
材料核心
Every 团队先给每个员工配了一个自托管的 OpenClaw 个人 agent(Plus One),结果被"养宠物"式的运维拖垮;随后他们转向 Anthropic 的 Claude Managed Agents(CMA),把 agent 的"大脑"和基础设施交出去,只保留在 Slack 里做一个真正像同事的共享 agent(@Every)。文章的核心是一场交易:用基础设施的控制权,换回构建产品的时间——以及随之而来的锁死代价。
发芽 01:从"宠物"到"牛群",再到"租别人的牛群"
种子
文章里那句"servers should be cattle, not pets"通常被当成一句运维口号来读。但 Every 的真实路径比这句口号更微妙:他们并不是从"宠物"直接跳到了"牛群",而是走了三步——拥有宠物 → 拥有牛群 → 租用别人的牛群。每一步都是一次抽象,而每一次抽象都在做同一笔交易:用对下一层的控制权,换取上一层的速度。
这个视角能解释文章里一个容易被忽略的细节:Every 放弃 CMA 时的"架构文档比预想的长得多"。因为抽象不是免费的午餐,它把复杂度下沉了,而不是消灭了。你不再需要给机器治病,代价是你也不再拥有那台机器。
故事:基础设施抽象的阶梯
"pets vs cattle"这个比喻并非出自云原生官方,而是大约 2011 年由微软杰出工程师 Bill Baker 在一次演讲中提出,随后被 Cloudscaling 的 Randy Bias 在 2012 年的博文《The History of Pets vs Cattle and How to Use the Analogy》系统化。它最初的对照是:传统服务器像宠物,你给它起名、精心照料、病了要救;云上的实例像牛群,编号管理,坏了直接替换。Kubernetes 的整个设计哲学,本质就是把"牛群"思维工程化。
沿着这条阶梯往上,每一层都重复同样的动作:物理机 → 虚拟机 → 容器 → Serverless → 托管 agent。Every 文章里的证据极其具体:他们曾写下 /heal-bot 命令来"给 bot 治病",每 30 秒轮询一次确认 agent 还活着,还专门跑一个每小时执行的任务防止 Slack token 过期。这些都是标准的"宠物护理仪式"。而 CMA 把它们变成了"牛群"——每个 session 就是一头牛,8 美分一小时,坏了换一头。
有意思的是,Every 走到最后,连"牛群"都不自己养了。他们把牛群托管给了 Anthropic 的农场。这是阶梯上更高的一级:你不仅不救机器,你甚至不拥有机器。
Aha 瞬间
"当你的运维手册里写满了给机器治病的方法,你养的是宠物;当机器坏了你直接换一台,你才拥有牛群;而当你连'换一台'都不需要亲自做时,你拥有的其实是一个别人替你承担风险的承诺。"
发芽 02:共享记忆,才是"同事"与"工具"的分界线
种子
文章对个人 agent 失败的解释,表面上是运维问题,内核其实是一个知识问题:"Each agent only knew its owner's work." 个人 agent 的天花板不是算力,而是孤岛式的记忆——它把组织知识切成了 N 份,谁也看不见谁。而共享 agent 的赌注是:当记忆集中,它会随使用变厚,越用越聪明。
这条线索把文章从一篇技术复盘,变成了一次关于"组织记忆"的实验。
故事:知识为什么要"共享空间"
组织知识管理里最经典的框架,是野中郁次郎(Ikujiro Nonaka)与竹内弘高在 1995 年《The Knowledge-Creating Company》中提出的 SECI 模型。它的核心命题是:知识有两种——隐性知识(tacit,藏在个人经验里、说不出来)和显性知识(explicit,可写下来、可传递)。而隐性知识要变成组织资产,必须经过一个关键的中介:"场"(ba),也就是人们共享情境、面对面碰撞的物理或虚拟空间。
对照来看,Every 的 Plus One 恰恰缺少"场":每个 agent 都困在自己主人的私人工作里,一个人的好 workflow 无法沉淀为集体资产——文章原话是"Teaching every agent the same thing meant making the same update several times"。而 @Every 把 Slack 线程变成了 agent 的"场":记忆跨线程延续,skill 学一次全公司可用,任何人都能提议修改、由 skill owner 审批。这正是 SECI 里"隐性 → 显性 → 组合 → 内化"的工程化版本。
更能说明问题的是那桩"沙拉失踪案"。@Every 之所以能一本正经地列出嫌疑人名单、最后把矛头指向办公室的狗 Leo,正是因为它记得整个团队的共享情境——谁下午进过厨房、谁在场、之前发生过什么。这个玩笑的技术前提,是个人 agent 永远无法具备的集体记忆。
Aha 瞬间
"个人 agent 是一个更快的工具;共享 agent 是一个更聪明的同事。差别不在算力,而在它记得谁——是只记得你,还是记得你们所有人一起发生过的事。"
发芽 03:便利的代价——当"大脑"是租来的
种子
文章最诚实的地方,是它没有把 CMA 写成纯粹的胜利。作者承认:"more than once they had us looking for alternatives." 然后列出了三条硬伤:只能用 Claude、被绑定在 CMA 的设计上、因为要保留 session 历史而无法满足"零数据保留"(zero-data-retention)——而有些公司硬性要求这个。
她甚至专门写了一份架构文档,逐条列出要脱离 CMA 得重建什么,"ran longer than any of us expected"。这是一次罕见的**"退出成本审计"**,而它的结论令人不安:抽象省下的时间,正在以选择权为抵押。
故事:补贴互补品与锁定
这种"用便利换锁定"的剧本,在软件史里反复上演。2002 年,Joel Spolsky 在《Strategy Letter V》里提出"commoditize your complement"(让你的互补品商品化)——当你的核心产品越来越值钱,就设法让它所依赖的周边变得便宜、通用、可替换,从而放大自己。云厂商的逻辑与此同构:你越依赖它的托管层,你的迁移成本就越高,议价权就越弱。
Every 的处境是个精确的现代版本。他们享受了 CMA 的"大脑/手"分离设计——Claude 加 harness 是大脑,虚拟机和工具是手,session 是外挂的日志,任何一方崩溃工作都能续上。这个设计本身很优雅。但优雅的代价是:大脑是租来的,日志存在别人的机器上。于是"零数据保留"不是技术参数问题,而是能不能接某些客户的生意问题——它从工程限制升级成了商业限制。
值得注意的是,Every 并非没有算过这笔账。他们算出过另一笔漂亮的账:通过把长对话切成新 session 加简短回顾,重跑历史对话后总成本下降 39%。这说明团队有极强的成本意识。他们最终仍选择留下,不是没算清,而是算清了"重建要花几个月 + 一堆新 bug"之后,留下是更理性的选择。这正是锁定的本质:不是你没得选,而是每个选项都贵。
Aha 瞬间
"把大脑租出去,省下的是今天的工程时间,押上的是明天的选择权。你越用它,越离不开它;等你算清退出成本时,往往已经太贵了。"
你的思考空间
- 如果 @Every 的记忆真的"越用越厚",那它究竟是一项资产,还是一张不断加码的迁移账单?这两者会在什么节点开始互相矛盾?
- "牛群化"的尽头是什么?当 agent 也变成可随时替换的 cattle,那么在这个体系里,还有什么值得被当作宠物来精心照料——是数据、是记忆,还是人的判断?
- 一个记得整个公司、跨线程延续的共享 agent,它的"忠诚"究竟属于谁:员工、公司,还是托管它的 Anthropic?当这三者利益不一致时,它听谁的?
- "零数据保留"这类合规要求,会不会成为企业级 agent 的分水岭——把市场切成"愿意交出历史"和"绝不出让"两类客户?
- 当基础设施被一层层抽象掉,工程师的价值会向哪一层迁移?Every 说"我们想造同事,不想当运维团队"——那么造同事这件事本身,最终会不会也被抽象掉?