Copilot 在组织架构图上有了一个席位
八月,Mike Taylor 数出了 80 款名为 "Copilot" 的微软产品。他说,其中有几款是构建智能体(agent)的最佳工具——前提是你能搞定新手引导和企业 IT 管理。
周三,在雷德蒙德(Redmond)的一场发布会上——我在现场与高管交谈,并在演示区短暂试用了这款应用——微软发布了一款新的 Copilot,它把聊天、代码、Office 和一个名为 Autopilot 的常驻智能体整合在一起,取代了此前分立的消费者版和工作版聊天应用。微软并非唯一一家尝试为 AI 工作打造统一界面的公司,但它的优势在于:它的目标用户本就整天泡在 Outlook 和 Teams 里,而他们的权限早在几年前就由 IT 部门设定好了。
Autopilot 可能是新 Copilot 中最有意思的部分:它能自主工作,并能访问你所能访问的绝大部分内容。这些权限既可能让它在公司内部变得有用且值得信赖,也可能让它连一项普通任务都无法完成。微软在发布会上对评估(evals)的强调本身就说明了这一点:它指望客户来定义"在自己组织里什么才算好工作",并测试 Autopilot 是否改进了当前的工作流。
新应用有三个标签页:
- Home:把聊天、委派的任务,以及 Word、Excel 和 PowerPoint 汇聚到一处,让它们之间可以共享上下文。
- Code:让非开发者也能在安全环境内构建和分享小型应用。
- Autopilot:让你创建一个常驻智能体,给它一个目标,让它在你背后持续工作。
在一场演示中,它跟踪并管理了一家零售商的黑色星期五库存请求。为了避免无治理智能体带来的合规风险,Autopilot 智能体凭借自己的权限融入组织的治理结构,并在组织架构图中显示为向所有者"汇报"。
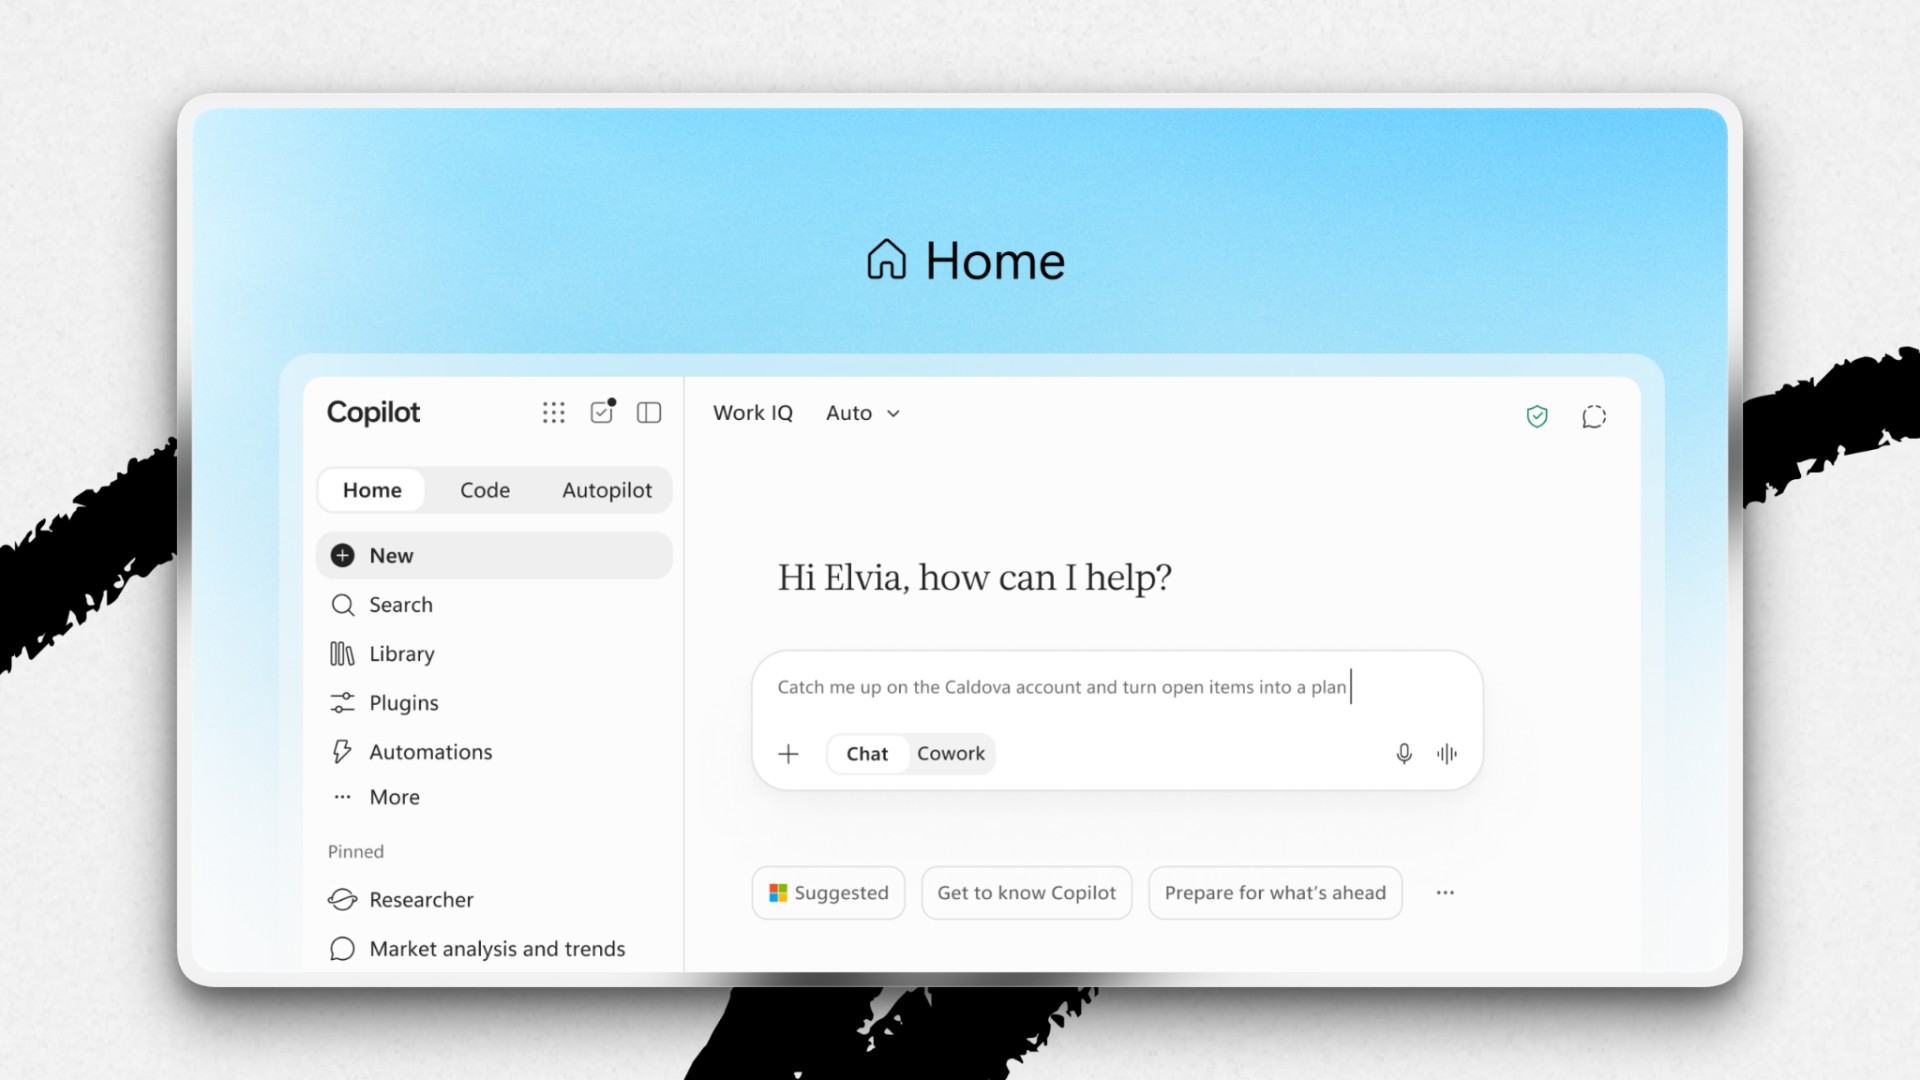
这些功能将在未来几个月内通过预览版和微软的 AI 功能抢先体验计划逐步推出。
我在演示区学到的东西
发布会上,CEO Satya Nadella 说,Copilot 如今可以在各种尺度上工作,从一个 Excel 单元格到一周会议的摘要,并且在你所做的一切中保持对同一份"记忆"的连贯感知。这正是我想在演示区验证的说法。Copilot 内置的 Office 站得住脚:Word、Excel 和 PowerPoint 都能在应用内打开,Copilot 知道你正在哪个文档里、在做什么。旧的 Copilot 按钮看不到自己窗口之外的东西。在一场演示中,我们在 Copilot 里打开了一份 PowerPoint 文稿,滚动到第 9 张幻灯片,然后回到聊天里说:"把这张幻灯片做得更易读一些。"这就足以让 Copilot 开始重新排版这张幻灯片。
接着我提了一个超出团队预先准备范围的请求:从一份 Word 文档里拉出一个表格,放进 Excel 工作簿的一个新标签页里。Copilot 找到了这两个文件,但表示自己没有编辑该工作簿的权限。类似的限制也让我们无法测试从 Chat 到 Code 的交接。这类交接正是"一个应用"卖点的核心,所以我本希望能亲眼看到一次。两次情况中,团队都向我保证:虽然演示环境没有为这些任务做好准备,但在正确的配置下它们是可以运作的。这与 Mike 在八月的观察相呼应:IT 管控让 Copilot 对企业而言是安全的,但客户的配置将决定它对某位用户来说在第一天是否可用。
一个持续工作的智能体
"新的巨大内部风险就是 AI 智能体,"Nadella 在发布会上警告说,并解释了为什么 Autopilot 的设计要帮助它赢得用户的信任。Autopilot 会调取用户过去 30 天的工作内容、其在组织架构图中的位置以及日历。它会记住个人偏好,比如"上午不开会",以及过去的纠正。这些记忆本意是对用户私密的,但在与他人协作时,这个智能体是可识别的——它会以用户给它起的名字显示,比如 "Dot(Ryan 的 Autopilot)"。同事可以在 Teams 聊天中 @ Dot 来查找会议时间,或向它提问。
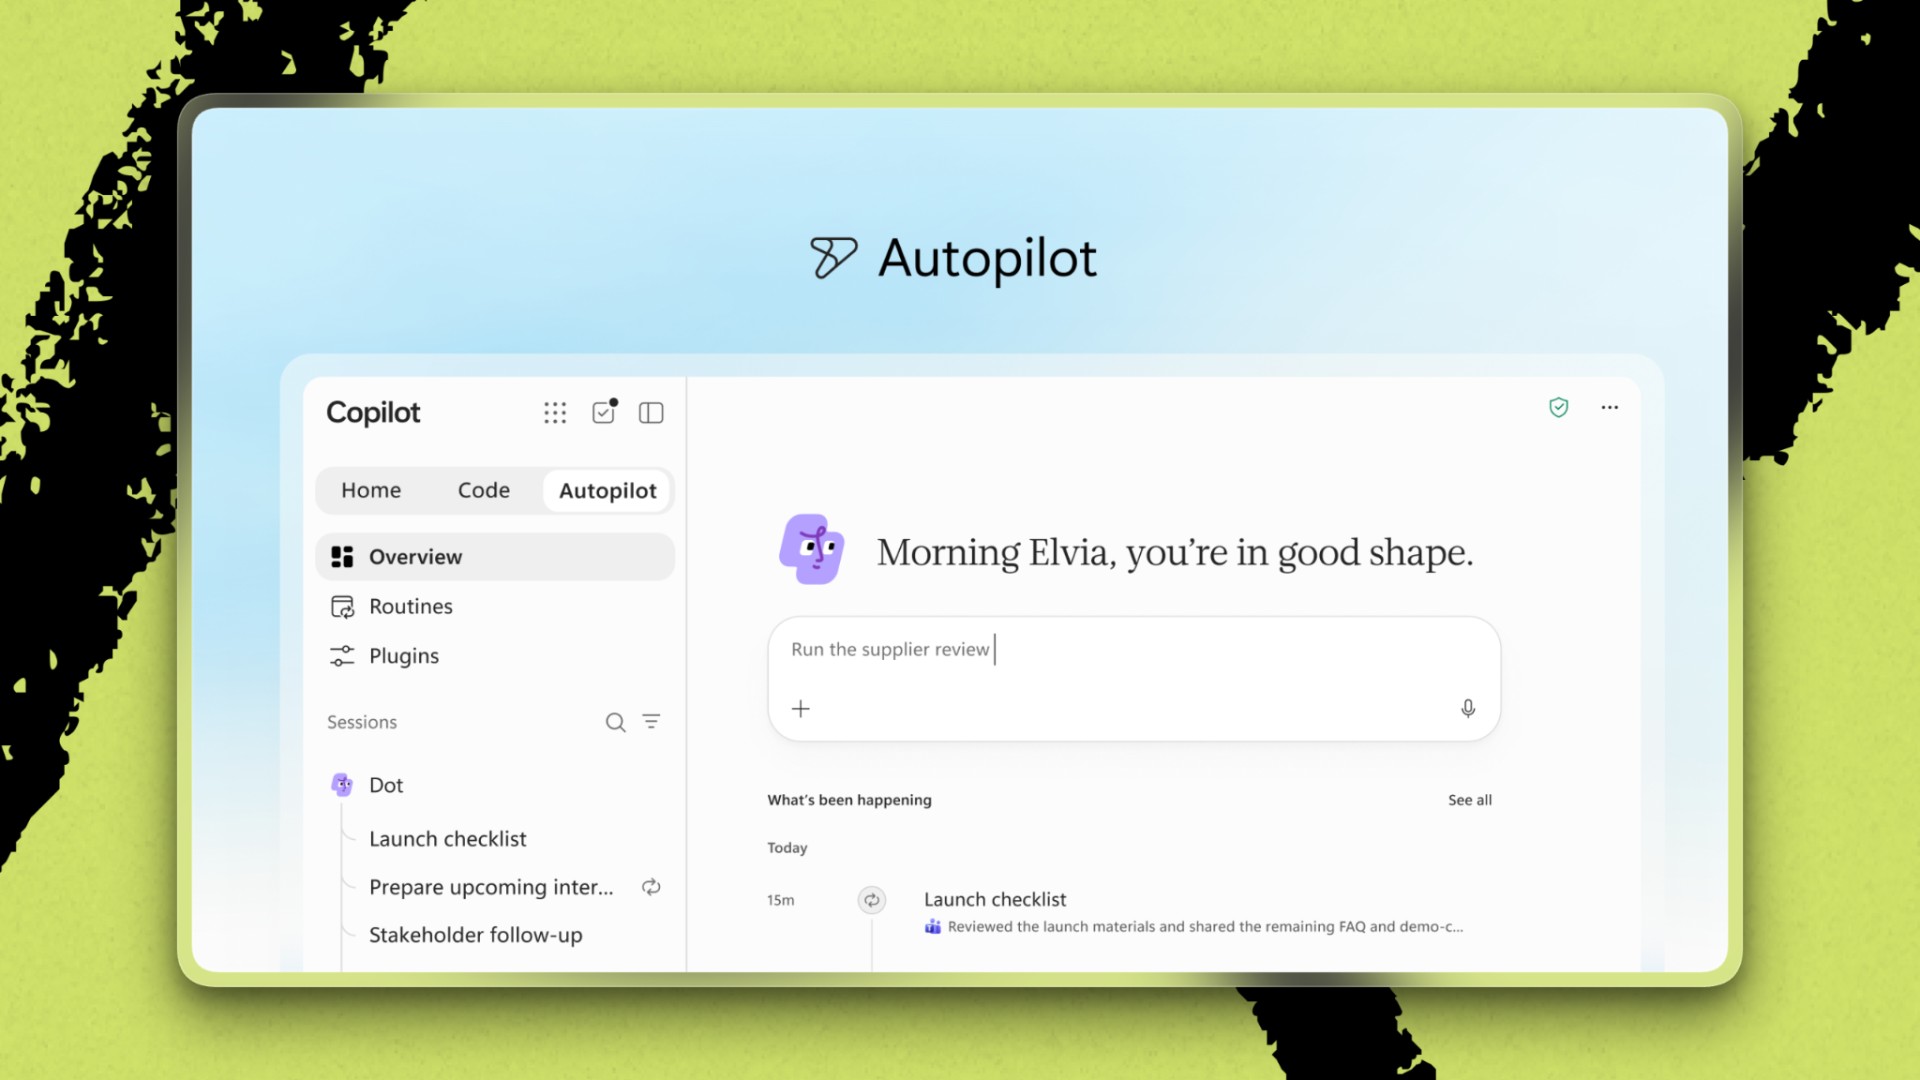
Autopilot 还能运行 Routines(例行任务):每日简报,或在你做别的事情时替你盯住某个项目的常驻任务。Charles Lamanna,负责 Copilot、智能体与平台的执行副总裁,把他的 Autopilot 命名为 Apollo,并给了它和自己的行政助理同等的 Outlook 访问权限。他几乎完全在 Teams 里和 Apollo 交流,就像给同事发消息一样。他给它设定诸如"确保我为客户会议做好准备"这样的目标,而它会全天候运转,识别日历上的这些通话,并自动从 Teams、邮件和笔记中为他汇总相关背景。
全天候工作是有代价的。Autopilot 按用量计费(credits),且默认关闭。Lamanna 设想公司最终会做到每人一个 Autopilot、每组一个 Autopilot。他说,要让成千上万个智能体全天候消耗 token 变得合理,Autopilot 必须"跨过更高的门槛",比那种只在用户开口时才工作的 AI 工具更高。
"更高的门槛"意味着什么
发布会上,微软花了多得惊人的时间来谈客户应当如何评判 Copilot。这种强调反映了整个行业向评估(evals)的转向,正如 Laura Entis 昨天所报道的。Nadella 呼吁"针对你所在公司的评估":基于你的人员所做的工作来设计测试,用它来比较模型、衡量表现。通用基准无法告诉一个组织,某个智能体是否改进了它自己的某个流程。
Lamanna 告诉我,微软内部运行着大约 16,000 项评估。每一项评估都代表一个他们从使用数据中识别出的常见任务或工作流,并由领域专家构建。公司也会与客户一起构建评估。他说,在一家大型消费品公司,一个微软团队正在识别对该业务最重要的任务。客户接入必要的数据,微软则修复测试所暴露的问题。
Lamanna 说,在这方面取得成功的客户,会让每天实际做这份工作的人来构建评估。他们还会"拥抱红色"。一个失败的测试告诉你该修什么,一旦它通过了,你就写一个更难的。而在这些客户让智能体上手之前,他们会先测量人类现在是怎么做这份工作的——跟踪错误率、一份合同走完流程所需时间等结果——这样智能体就有一个真实的基线可以去超越。
这一标准应当适用于整个新 Copilot。每一个功能都必须改进它承诺要简化的那项工作。Copilot 内置的 Office 将省去大量为了给聊天机器人提供上下文而做的复制粘贴。Code 针对的是我反复见到的一种模式:有人做了一个好用的 AI 工具,在自己的笔记本电脑上跑得漂亮,但再没有第二个人用过。微软希望分享一个应用能像发一份 PowerPoint 文稿一样简单。Autopilot 则服务于那些你不在工位时堆积起来的任务。
微软已经拥有公司智能体所需的一切:你的文档、对话和权限。但当演示无法把我的工作从一个应用带到另一个应用时,它恰恰说明了微软为什么可能难以兑现这个承诺。那些本意是让 Copilot 值得信赖的管控,也可能让它无法完成工作。针对公司的评估能让客户衡量 Copilot 在这些护栏之内工作得有多可靠——以及它是否真的改进了员工今天的工作方式。
Ryan Sloan 是西雅图的一名数据科学家。他在 Full Rank 撰写关于 AI 度量与评估的文章。
核心启示:微软把 Copilot 整合为"聊天 + 代码 + Office + 常驻智能体 Autopilot"的统一应用,并让智能体以自有权限进入组织治理结构;但正如演示区所暴露的,让它对企业可信的那套管控,也可能正是让它干不成活的原因——能否兑现"一个应用"的承诺,最终取决于客户自己的权限配置与针对公司定制的评估。
Copilot Gets a Seat in the Org Chart 的发芽报告
材料核心
微软发布了一个统一的 Copilot 应用,把聊天、代码、Office 和一个常驻自主 Agent——Autopilot——装进同一个界面,并让 Autopilot 带着权限、以 owner 的名义出现在组织架构图里。作者 Ryan Sloan 的核心观察是:让企业敢信任 Copilot 的那套权限控制,恰恰也是让它在普通任务上做不成事的原因;因此微软把"定义好工作、测量表现"的责任交给了客户,靠公司专属的 evals 来判定 Agent 是否真的改善了工作。
发芽 01:组织架构图,是一套用"人"编码的权限系统
种子
这次发布真正的动作,不是"又推出了一个工具",而是把 Agent 放进组织架构图——给它分配权限、指定 owner、让它以名字("Dot (Ryan's Autopilot)")在 Teams 里被 @。工具没有席位,同事才有席位。微软用命名暗示了它想让 AI 占据的位置。
故事
看航空业的命名学就明白了:在真实驾驶舱里,Copilot(副驾驶)是一个人类角色——坐在机长旁边、共享视野的人;Autopilot(自动驾驶仪)才是机器。微软把"应用"叫作 Copilot(人类角色),把"常驻自主 Agent"叫作 Autopilot(机器角色),命名本身就暴露了它想让 AI 站的位置。
更有历史意味的是"computer"这个词。在 20 世纪中叶,computer 是一个人类职位——NASA 的 Katherine Johnson 等被称为"human computers"(见《Hidden Figures》),"computer"在招聘启事上指的是坐在桌前算数字的人。后来这个词从人迁移到了机器。微软现在做的,是把"copilot"从人(航空副驾驶)迁移到机器,再进一步给它一张架构图上的椅子。Charles Lamanna 把 Autopilot 命名为 Apollo、给它和行政助理同等的 Outlook 权限、几乎只在 Teams 里像给同事发消息一样和它对话——这不是隐喻,这是组织行为的复制。
连接点:文章反复强调 Autopilot "shown 'reporting' to their owners in the org chart"。组织架构图的本质,就是一套用汇报线和 owner 关系编码的权限系统。
Aha 瞬间
"组织架构图本质上是一套用人际关系编码的权限系统——而微软最大的动作,也许是把这张架构图本身当成了一个 API。"
发芽 02:权限悖论——让它值得信任的东西,也是让它无法工作的东西
种子
演示失败不是 bug,而是设计的结果。作者想从 Word 拖表格到 Excel、想测 Chat 到 Code 的交接,都被权限挡住。文章点破的张力是:让 Autopilot 在企业里"值得信任"的同一批权限,也让它在普通任务上"无法工作"。信任与能力,来自同一个源头。
故事
安全工程里有一条 1975 年的经典原则——最小权限原则(Saltzer & Schroeder, The Protection of Information in Computer Systems):每个程序只应拿到完成其任务所需的最小权限。这对人类 IT 管理员是清晰的,但 Autopilot 的任务是开放的、临时的、跨应用的——"最小权限"对一个还不知道下一步要干什么的 Agent,几乎无法预先计算。演示里它"找到了两个文件却说没有权限编辑工作簿",就是这个数学题无解时的日常版本。
再往下一层是 Norm Hardy 在 1988 年提出的**"糊涂代理问题"(confused deputy problem)**:一个拥有权限的程序,会被没有权限的人利用,替它行使权限。一个拥有"你几乎所有权限"的 Autopilot,天生就是一个高价值的糊涂代理目标。Nadella 自己在台上说"The new massive insider risk is the AI agent"——他非常清楚这一点。
连接点:文章说 Autopilot "can access most of what you can",这既是它的卖点,也是它的风险源;而文章开头那句"with permissions their IT department set years ago",说明企业 Agent 的能力上限,往往不由模型决定,而由几年前某个 IT 管理员设的权限决定。
Aha 瞬间
"在企业里,Agent 的能力天花板不由模型决定,而由 IT 部门几年前设的权限决定——这也是为什么微软把 Copilot 的成败,押在了客户的 evals 上,而不是押在自己的模型上。"
发芽 03:Evals 是新的管理学科——"拥抱红色"与先给人类做基线
种子
文章最被低估的部分不是 Agent,而是 evals。微软把"如何判断 Copilot 干得好不好"这件事交回给客户:要求企业定义什么是"好工作"、先测量人类现在的表现,再让 Agent 上场。这不是一个产品功能,这是一门新的管理学科。而 Autopilot 按用量计费、24 小时运行的商业模式,正是逼出这门学科的经济动力——Lamanna 说要跑成千上万个常驻 Agent,它必须"clear a higher bar"。
故事
"拥抱红色"(embrace the red)几乎是软件工程里**测试驱动开发(TDD)的原文照搬:在 Kent Beck 的 red-green-refactor 流程里,"红色"就是测试先失败的那一刻——失败是信号,不是耻辱,红过了才写绿。工厂里是同一个逻辑:丰田生产系统的安灯绳(Andon cord)**允许任何工人拉停整条产线,把问题暴露出来而不是藏起来。
更深的一层是"先测量人类基线"。文章说客户 "before those customers let the agent try, they measure how the humans are doing the job now",追踪错误率、合同周转时间这类结果。这正是临床试验的逻辑:在随机对照试验里,新疗法(Agent)必须和现有流程(对照组)比,否则你根本分不清改善来自 Agent,还是来自时间、注意力或其他因素。微软内部跑约 16,000 个 eval,本质上就是把 Deming 那句"不能测量就不能改进"搬进了 AI——而且要求"每天做这份工作的人来写 eval",也就是把测量权交还给一线。
连接点:文章说"A general benchmark cannot tell an organization whether an agent improves one of its own processes"——通用基准没有对照组,公司专属 eval 才有。这一句话,把 Copilot 从"模型竞赛"重新拉回了"管理实验"。
Aha 瞬间
"微软其实在请每一家公司给自己的流程做一场临床试验——Agent 是实验组,员工现在的做法是对照组,而 eval 就是那个判定疗效的终点指标。"
你的思考空间
- 如果组织架构图真的成了一个 API,那么当 Agent 有了席位、owner 和汇报线,它的错误该由谁负责——是 owner、是 IT,还是微软?"报给 owner"是责任归属,还是一种责任转移?
- "先测量人类基线"听起来理性,但如果同一个任务两个员工做出来天差地别,Agent 要打败的到底是"平均人类"还是"最好的人类"?这会如何改变它被接受的难度?
- 如果最小权限原则对开放式 Agent 几乎无法预先计算,企业会不会被迫在"给足权限"和"放弃 Agent"之间二选一?有没有第三种路径——比如让 Agent 在"申请权限"的循环里工作?
- Nadella 说最大的内部风险是 AI Agent。当每个员工、每个团队都有一个 24 小时运行的 Autopilot,企业的攻击面是变大了,还是因为有了可审计的"席位"反而变清晰了?
- 如果 eval 由"每天做这份工作的人"来写,那么随着 Agent 接手越来越多任务,写 eval 这件事本身会不会成为这个岗位的新定义?今天的执行者,会不会变成明天的评估者?