为什么评估(Evals)现在如此火热
原文:https://every.to/context-window/why-evals-are-so-hot-right-now 作者:Laura Entis|2026 年 9 月 24 日
在今天的 Context Window 中,我们评测了 Grok 4.7(“一次倒退”?),并解释了为什么 evals(模型评估)突然无处不在。另外,社交媒体负责人 Becky Isjwara 拆解了她把 Every 文章变成爆款短视频的工作流;平台负责人 Willie Williams 主张 Slack 智能体就是新的网站;我们还分享了新一批 Thesis Statements,包括 Cmpnd 的 Drew Breunig、Notion 的 Geoffrey Litt 和 MIT 的 Daniela Rus 关于“自动化之后会发生什么”的观点。
Mini-Vibe Check
Grok 4.7 表现参差不齐
Grok 4.7 于周一公开发布。那体感如何?嗯,它还在不断变化。
在团队的早期测试中(早于公开发布),这个模型几乎没法用。它留下未完成的任务,无视指令,还未经许可就合并代码。
Every 有许多 Grok 4.6 的重度用户——尤其是 Cora 总经理 Kieran Klaassen 和设计师 Tyler Nishida——他们喜欢它,因为它便宜、快速,而且足够可靠,能当主力工具用。(Tyler 估计,上个月他追踪到的代码事件中有 97% 是 Grok 完成的。)
Grok 4.7 最初感觉像一次大幅倒退。上周,评估负责人 Mike Taylor 用自己的个人基准测试跑这个模型时,报告它的得分是 42%,而 Grok 4.6 是 84%。“也许他们仓促推出了,或者他们有更好的东西即将发布,”他说。“这看起来像是一次倒退。”
案子就此了结。真的吗?
并没有,至少对 Tyler 来说没有。他注意到,在公开发布之前,这个模型的表现一直在改善。尤其是公司的 AI 助手 GrokBot,在开始使用 Grok 4.7 之后变得更好了。以前他会发出一连串全大写的纠正——“停下,停下,停下。这不是我想要的!”——现在他只发简单的一行请求。“我感觉我对它的微观管理少了很多,”他说。
到了上周五,Grok 4.7 对他已经运转良好。截至本文撰写时,它已是他的日常主力。他甚至略微更喜欢它而不是 Grok 4.6——它保留了他最初被 Grok 吸引的特质:一个便宜、可控的模型,让他能持续工作,而不必频繁撞上使用上限。
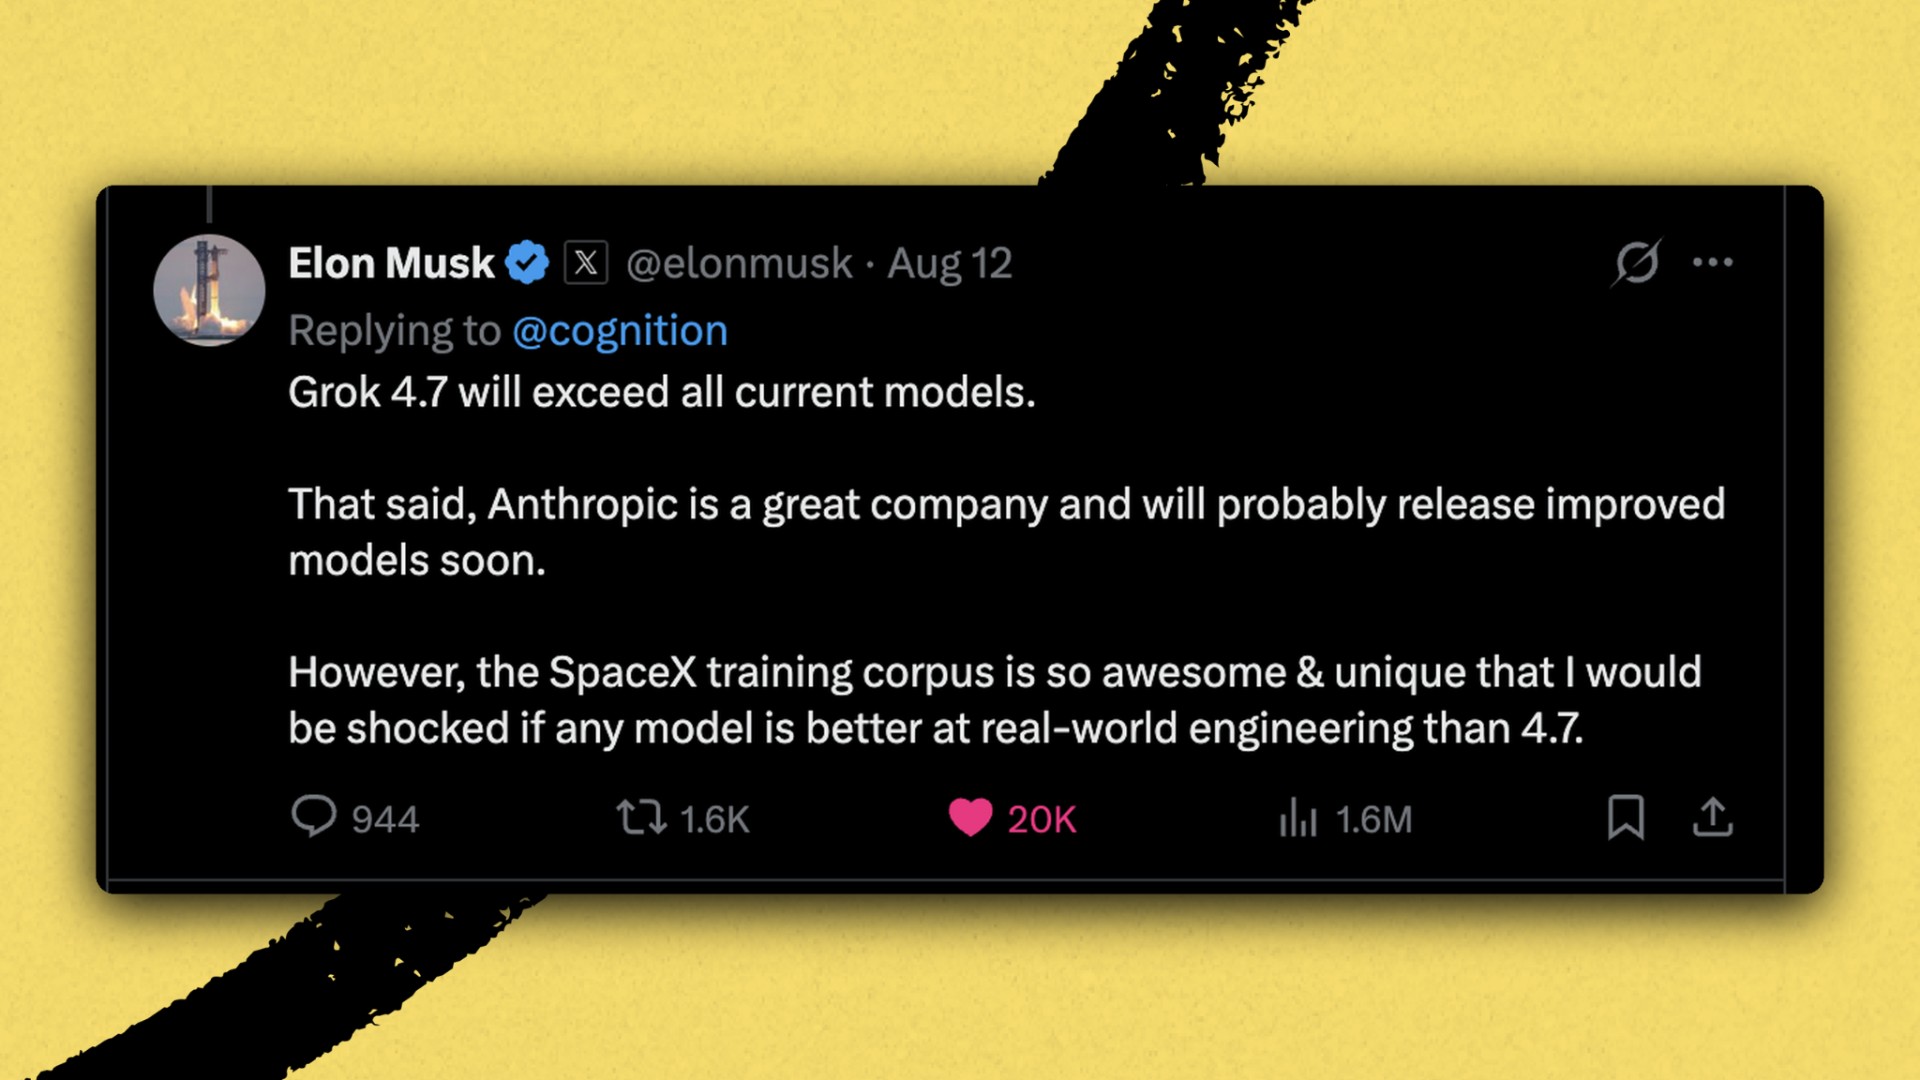
他的认可也有保留:当 Grok 4.7 需要协调其他智能体时,他仍觉得它令人沮丧,并更喜欢在单一对话中使用它。而 Elon Musk——他曾在一则(已被删除?)推文中宣称 Grok 4.7 将“超越所有当前模型”——让他期待的不止是渐进式改进。“我本来不会对它这么兴奋,我现在只是有点失望,”Tyler 说。
Tyler 的队友们并不都回心转意。Kieran 的评价依然是负面的。“和 Opus 5.5 相比,这个模型根本没法比,”他说。“这是我连考虑都不会考虑使用的模型。”
特约撰稿人 Katie Parrott 的写作测试也令人沮丧。她不喜欢 Grok 4.7 的编辑判断力。当被要求改写 Dan Shipper 的《自动化之后》一文的引言时,它写出了这样一句:“如果模型能做这项任务,人头就是情绪。”Katie 说,这是该模型“马斯克式大能量”的一个例子。
她发现它的写作风格同样糟糕。在同一篇《自动化之后》的改写中,它的开头段落全由短陈述句构成。
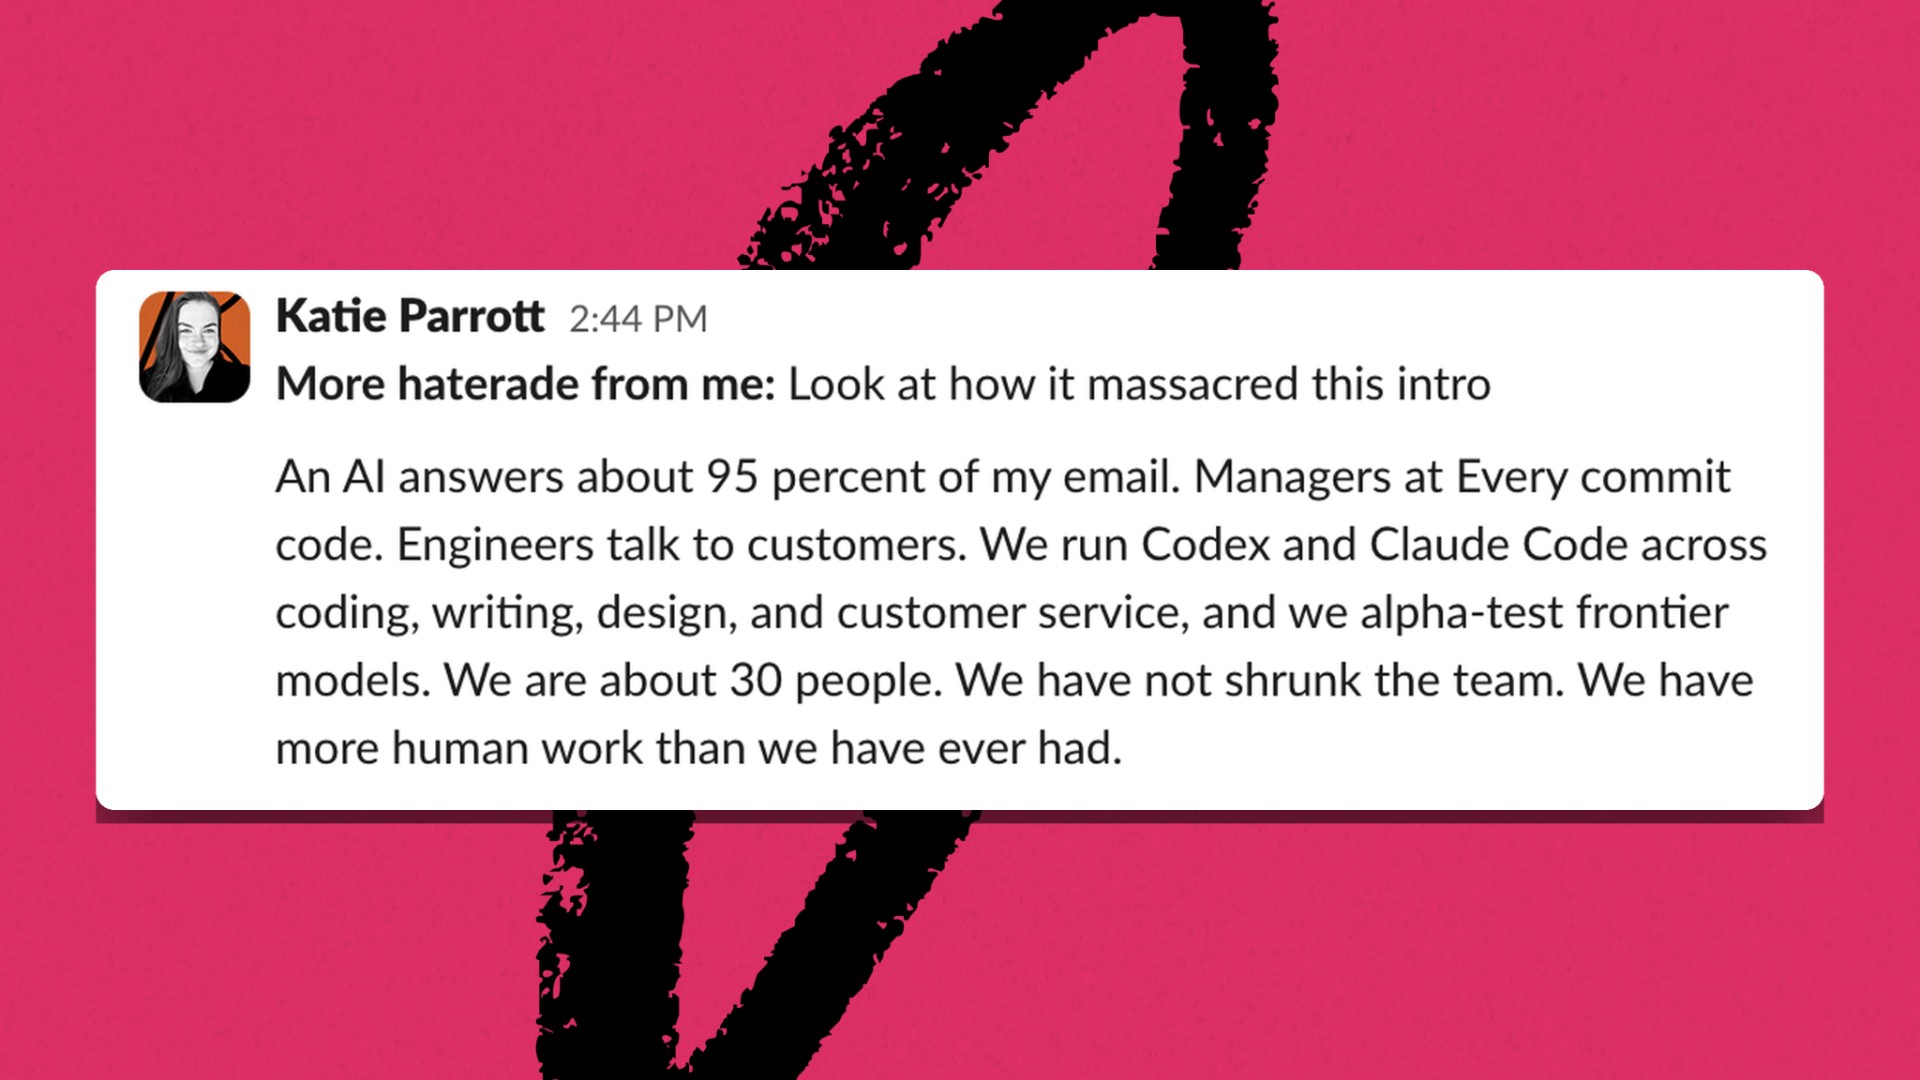
“它没有抑扬顿挫和节奏,对读者也没有共情或心理理论,”她说。
我们的结论: Grok 4.7 至少赢回了 Every 的一位最大用户。如果你喜欢 4.6 的日常编码能力,Tyler 的经历给了你尝试升级的理由。但如果你用 AI 写作,Katie 的测试表明,你还是别碰这个模型为好。
Signal
Evals 走向主流
发生了什么: Evals 正迎来高光时刻。科技意见领袖 Lenny Rachitsky 上周分享的 25 个产品管理职位中,他说近一半要求有撰写 evals 的经验——也就是对 AI 系统执行任务表现如何的测试。
在应用监控公司 Sentry,工程师 Ryan Brooks 报告,过去一个月中,提议的代码变更触发了大约 1,800 次 eval 运行——而 5 月份还几乎为零。这些检查能在更新发布前就发现问题,比如修改后的指令导致智能体在它此前能很好处理的任务上挣扎。
这意味着什么: 资深应用 AI 工程师 Nityesh Agarwal 说,过去选择最智能的模型是一个合理的默认选项。但前沿模型已经变得如此强大,以至于大多数知识工作者在日常工作中并不需要它们的全部智能。已经有几个模型能处理这些任务,这让速度、价格以及与用户品味的契合度成为更重要的选择标准。
Nityesh 正在帮助 Every 的每个人,基于现有任务和个人的优秀工作标准来构建个人基准。随着模型发布加速,这些基准让我们能快速测试一个模型在我们工作中不同部分的表现如何。“如果我有自己的个人基准,我就会知道是否需要关注某个模型发布,”Nityesh 说。
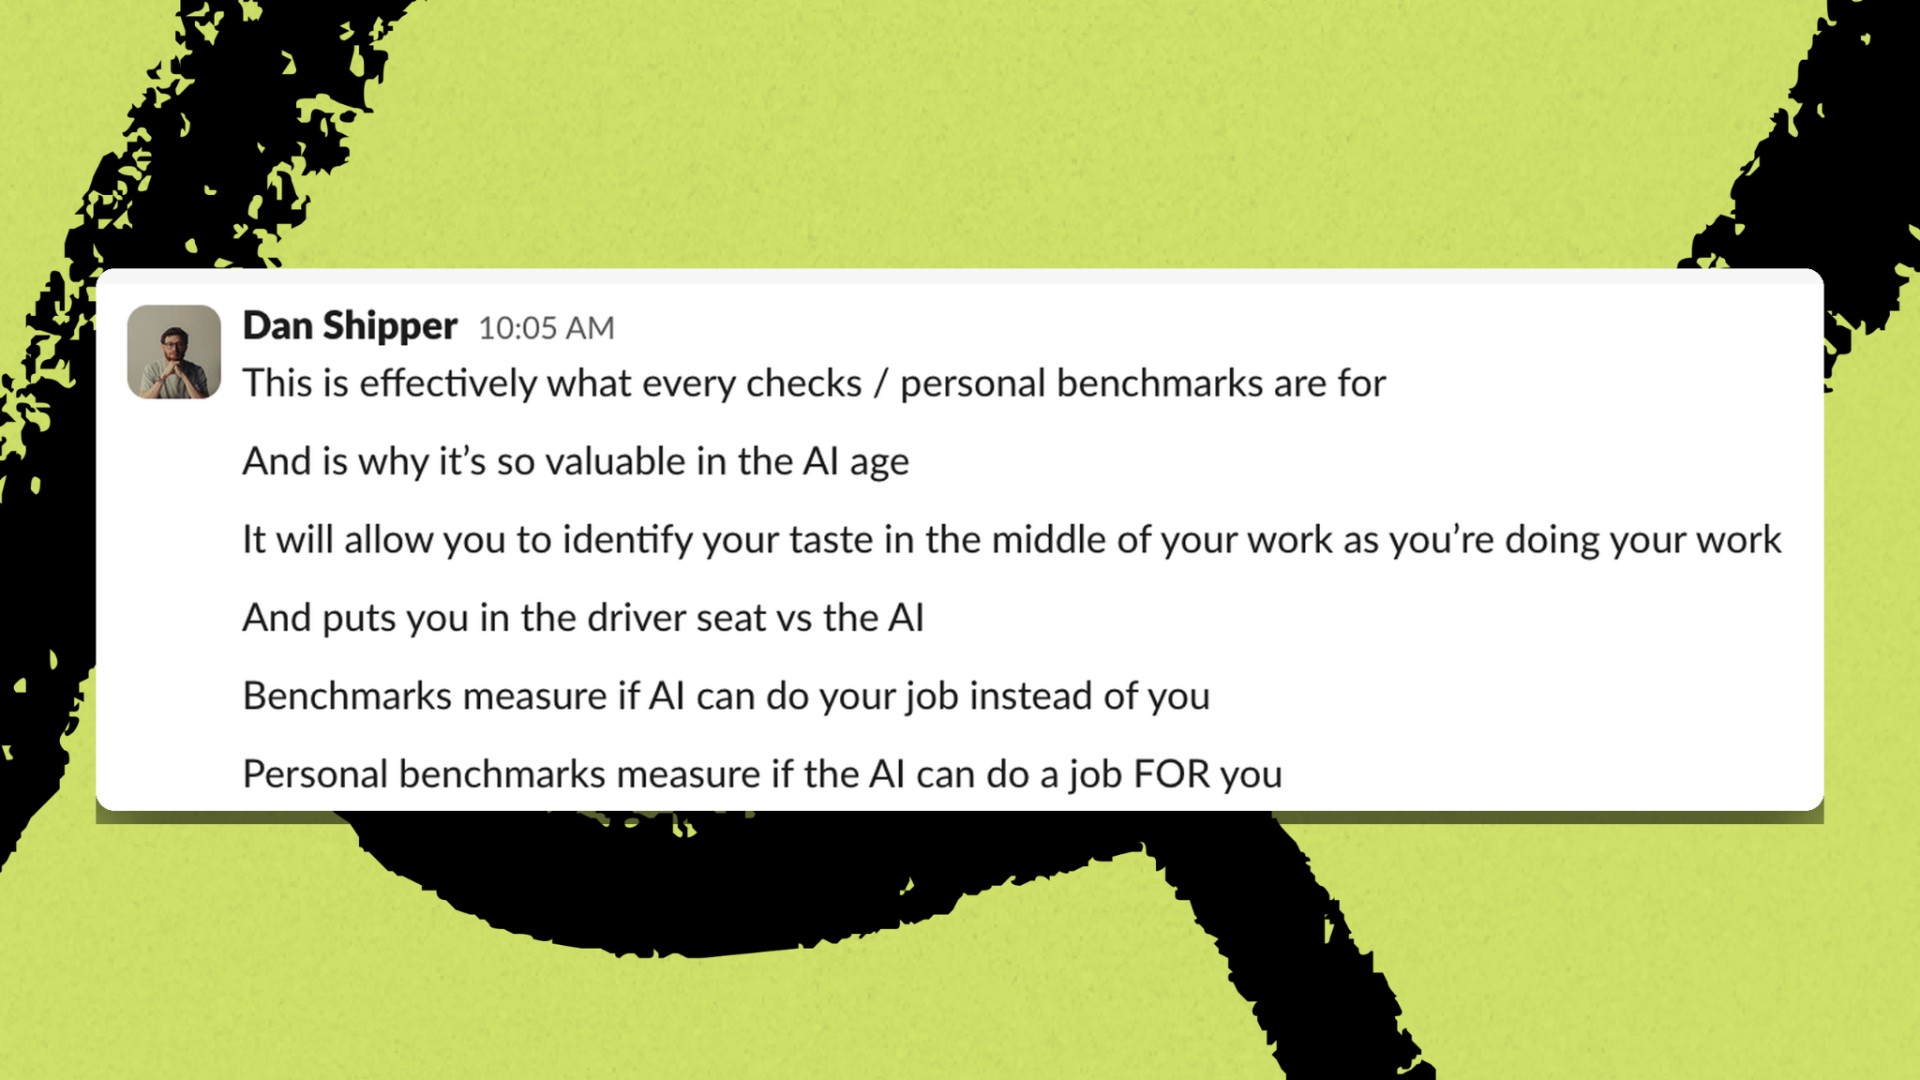
为什么重要: 用 AI 构建的团队越来越需要自己判断其质量——定义什么是成功,并检查模型更新是帮助还是损害了他们的工作。
Evals 帮助团队在客户遇到问题之前捕获失败,并测试一个更快、更便宜的模型对其产品是否表现得足够好。对个人来说,evals 能根据能力、速度和成本,找出哪个模型最适合某项特定任务。随着模型进步,“你的日常主力未必需要是最智能的那个,”Nityesh 说。
Steal this workflow
把一篇文章变成短视频
Every 的社交媒体负责人 Becky Isjwara 在把文章变成短动画视频方面取得了病毒式成功。对于 Katie 的《复合写作指南》——它讲解如何用 AI 写作来随时间提升你的手艺——她制作了一个 18 秒的短片,把封面上的飞散纸张做成动画,并把写作过程表现为一个循环。
(视频:Becky Isjwara 基于《复合写作》封面图制作的动画,由 Becky Isjwara 提供。)
为了制作这些视频,Becky 在 Claude 桌面应用中使用 Hyperframes 搭配 Fable。Hyperframes 让 Claude 能把文本、图像和动画变成一部完成的视频。
她的流程如下:
第 1 步:决定如何用视觉呈现这篇文章。 把文章 URL 给 Claude,让它建议一个开场钩子和一系列场景。自己读一遍文章,然后检查 Claude 提议的场景是否展示了文章最有趣的想法。
第 2 步:规划每个场景。 让 Claude 创建一个分镜,每个场景配一张静态图像。让它使用文章封面图的颜色,并包含屏幕上将出现的文字。在进入动画之前,检查故事是否容易理解、视觉是否传达了预期的想法。
第 3 步:制作视频。 一旦你认可了分镜,就让 Claude 用 Hyperframes 把这些场景变成视频,加入动作和转场。如果你想给封面插图做动画,把它上传到 Flora——一个用 AI 创建图像和视频的工作空间。在 Flora 中,选择 MiniMax(一个 AI 视频生成模型),并描述你希望插图如何运动。然后把生成的片段交给 Claude,让它纳入你的分镜。
第 4 步:观看并改进。 在 Claude 的内置预览中观看视频,暂停并告诉 Claude 要改什么——比如“这个场景在屏幕上停留久一点,好让我读完文字”,或“最后一个字母被截掉了。调整布局,让整个词都可见”。让 Claude 应用你的要求,然后复查视频以确认改动并检查是否出现新问题。
本周试一试: 选一篇文章和一张封面图,用这些步骤制作一个短视频。一旦你对结果满意,就让 Claude 把这个工作流和你的修正保存为一项可复用的
Why Evals Are So Hot Right Now 的发芽报告
材料核心
当前沿模型普遍跨过"够用"门槛后,选择"最聪明的模型"不再是默认选项,判断的重心从共享的基准(benchmark)转向私人的、任务特定的评估(eval)。Grok 4.7 的撕裂口碑——同一天里被 Mike Taylor 判为"退步"、被 Tyler 奉为"日常主力"——正是这场重心转移的活体样本。
发芽 01:从"最聪明"到"够用就好"——当共享考试被全员考满
种子
材料说:"Choosing the most intelligent model used to be a reasonable default... frontier models have become so capable that most knowledge workers don't need their full intelligence." 这不是一条关于 AI 的新闻,而是一条关于"技术跨越充足阈值后会发生什么"的规律。重新框定:eval 走红不是 AI 圈的新鲜事,而是任何技术成熟到"够用"之后,竞争轴从"能力上限"转向"适配度"的必然结果。
故事:
基准饱和史。 NLP 领域有一条清晰的"考试被考满"轨迹:GLUE(2018,Wang 等)是第一个被广泛使用的通用语言理解基准,设计目的是区分模型;不到一年,模型就超过了人类基线,于是 2019 年推出 SuperGLUE;2020 年 MMLU(Hendrycks 等)登场,覆盖 57 个学科,试图用更难、更广的题维持区分度——到 2024 年前后也逼近饱和。每一次都是同一个循环:造一把尺子 → 全员考满分 → 尺子失去信息量 → 换一把尺子。当"公共考试"不再能区分模型,判断力就必须下沉到本地、任务特定、私人的层面。这正是 eval 的结构性成因。
满意化(satisficing)。 赫伯特·西蒙 1956 年的论文《理性选择与环境结构》提出:真实生物从不优化,而是"搜寻到够好即停"——因为穷尽搜索的成本超过收益。Nityesh 那句"you don't necessarily need your daily driver to be the most intelligent one",就是满意化原理在模型选择上的复现。当一个"便宜、可操控"的模型足以让你不再撞上用量上限(Tyler 对 Grok 的偏爱),继续追逐最智能的模型就是非理性的过度优化。
锯齿状前沿。 材料自己用了一个小节标题"Jagged frontier",指向 Ethan Mollick 与波士顿咨询 2023 年的研究《Navigating the Jagged Technological Frontier》:AI 在某些任务上强于人、在另一些任务上弱于人,而这条边界是隐形的——不测试就看不见。这正是为什么"够用"无法靠直觉判断,只能靠 eval 测量。
Aha 瞬间
"当所有人都能考满分时,考试就不再传递信息;真正有区分度的问题,从'它有多聪明'变成了'它有多贴合我的具体工作'——这就是 eval 取代 benchmark 成为热点的原因。"
发芽 02:同一模型,两种判决——benchmark 与 eval 是两种仪器
种子
材料把 Grok 4.7 的撕裂口碑写成一个悬念:"Case closed. Or was it? It was not." 重新框定:这不是争议,而是范畴错误。Mike 和 Tyler 没有互相矛盾——他们用的是两种根本不同的仪器。Mike 跑的是 benchmark,Tyler 跑的是 eval。
故事:
同一天的两份判决书。 材料里,head of evals Mike Taylor 用他的个人基准测出 Grok 4.7 得分 42%,而 4.6 是 84%,结论"a step backward"。同一天,设计师 Tyler Nishida 说 4.7 已经是他的 daily driver,他甚至"稍微更偏好它",因为过去要发一连串大写纠正——"Stop, stop, stop. That's not what I wanted!"——现在只需一句请求。两人都没有错。
benchmark 与 eval 的分野。 benchmark 是标准化的、共享的、跨模型可比的——它回答"哪个更聪明"。eval 是任务特定的、私人的、可执行的——它回答"这个是否为我所用"。前者像 SAT,后者像试用期。一个候选人可以有顶级的标准化分数(benchmark),却在实际岗位上不合适(eval)。材料的编辑判断正是这个分野的印证:给写作者的结论是"leave the model alone",给日常编码者的结论是"a reason to try the upgrade"——同一模型,按任务分裂成两条推荐,这正是 eval 思维。
Elon 的承诺是一种 benchmark 式断言。 Musk 在(已删除的?)推文里宣称 4.7 将"exceed all current models"——这是一个全局的、可比的、benchmark 式的声明。Tyler 的"let down"则是一个私人的、任务式的、eval 式的判断。承诺与体验的落差,本质是两种仪器的错配。材料里 Sean Campbell 的论题——"We'll be assessed on what we can defend, not what we can produce"——是这场转移在人类身上的镜像:可辩护的(具体、情境化)正在压过可生产的(规模化、标准化)。
Aha 瞬间
"Grok 4.7 的'争议'在看清 Mike 与 Tyler 用的是两种仪器后就消散了——评估的未来不是给出一个统一判决,而是承认只有'适配',没有'最优'。"
发芽 03:当 eval 变成 KPI——古德哈特定律的阴影
种子
材料把 eval 的走红当作好消息呈现:Lenny Rachitsky 分享的 25 个 PM 岗位里近半数要求 eval 经验;Sentry 一个月跑约 1,800 次 eval,而 5 月还接近零。但值得追问的是:当 eval 从个人实践变成招聘要求和团队指标时,会发生什么?
故事:
古德哈特定律。 查尔斯·古德哈特 1975 年在《Problems of Monetary Management: The U.K. Experience》中提出:任何被选作目标的度量,都会失去它作为度量的价值(Marilyn Strathern 1997 年将其浓缩为"当一个度量变成目标,它就不再是好的度量")。eval 的核心价值恰恰在于它是私人的、任务特定的、基于"existing tasks and individual standards for good work"(Nityesh 语)。一旦它被标准化成岗位要求——"近半数 PM 岗位要求 eval 经验"——它就有可能重新长成一个大家共同追逐、共同刷分的 benchmark,也就是 eval 当初要逃离的东西。
SAT 的教训。 SAT 诞生时被设计为超越出身的"中立度量",但几十年后,备考产业把它变成了一个可被针对性训练的目标,其区分度被系统性稀释。eval 若走上同一条路,最可能先被"刷"的,正是那些最容易被形式化的任务——而最难被形式化的(比如 Katie 说 Grok 4.7 缺乏的"cadence or rhythm and no empathy or theory of mind for the reader"),恰恰是最需要 eval 的地方。材料里的张力正在于此:eval 最有价值的地方,正是它最不可移植的地方。
Aha 瞬间
"eval 的价值恰恰在于它的不可移植性——当它变成简历上的一行,它就开始重新长成它本来要逃离的那把公共尺子。"
你的思考空间
- 如果你的个人基准说模型 A 更好,但你的日常体验说模型 B 更顺,你该信哪个?这道裂缝本身,是不是在告诉你"你到底在测量什么"?
- 公共基准已经走完 GLUE → SuperGLUE → MMLU 的饱和循环。个人 eval 会重蹈覆辙,还是会因为"任务特定"而免疫?
- 材料说 eval 能帮团队"catch failures before customers encounter them"。但"品味"——Katie 说 Grok 4.7 缺的那种东西——能写出 eval 吗?编辑判断可以被评估吗?
- Willie Williams 说"Slack agents are the new websites":如果 agent 住在上下文最丰富的地方,这是让 eval 更容易(数据现成),还是更难(待测的面更大)?
- 如果"你不需要你的 daily driver 是最聪明的那个",那前沿实验室的商业模式,以及"state of the art"这个词本身,会发生什么?