如何充分利用 Jev
原文:https://every.to/context-window/how-to-get-the-most-out-of-jev
Jev 速度快、成本低,而且足够准确,能够大规模处理那些你绝不会花钱让 LLM 去做的判断——这封邮件紧急吗?这段话听起来像 AI 写的吗?这个客服请求要不要升级?——它可以对任何内容、在任何时候都做这类判断。今天,评估负责人 Mike Taylor 解释这解锁了什么,市场负责人 Douglas Brundage 分享他让 Jev 投入工作的捷径,高级编辑 Jack Cheng 则展示为什么 Jev 如此擅长把意图转化为行动。
信号
为什么 Jev 刷爆了你的时间线
发生了什么: 9 月 15 日,在隐身模式中打磨了两年的 AI 前沿实验室 TypeSafe 发布了 Jev——一个不生成内容、而是对文本和结构化数据进行分类的模型。这次发布像点燃了一根至今未熄的火柴:在 X 上,Jev 的演示随处可见。用户们纷纷走红,展示 Jev 如何被用来玩电子游戏、重新排序搜索结果、过滤社交媒体帖子,以及许多其他用途。高级编辑 Jack Cheng 的 Jev 演示展示了该模型从语音和手势中推断用户意图的能力,观看量已突破 100 万。
一旦你搞清楚 Jev 是什么、不是什么——它是一个决策模型,不是聊天机器人——这种狂热就说得通了。用大白话把一个任务表述成一个是非题、一道多选题或一个评分,Jev 就会返回一个概率。由于它输出的是概率,而不是逐个 token 地生成文本,Jev 可以并行回答海量问题,几乎瞬间完成,成本只有基于文本的 LLM 的零头。
这意味着什么: Jev 的准确、快速和极其廉价,解锁了一整个世界的可能性。这个模型擅长规模化分类:例如,它能在不到一秒内把你整个收件箱存档分门别类,如时事通讯、工作消息、活动邀请等。(当然,语言模型也能做到,但速度更慢、成本高得多。)一条通用经验法则是:如果一项任务简单到人类花不到 10 秒就能完成——比如判断一封邮件该如何分类——那它就是 Jev 的理想用例。而对于需要更多推理、人类要花 10 秒以上才能完成的任务,就该请语言模型的智能出场了。
整理邮件很直截了当。要用 Jev 处理更复杂、更主观的判断,比如“这封邮件紧急吗?”,你——或者你的智能体——必须先把“紧急”定义成一组更清晰的检查项:它是真人发的吗?你认识发件人吗?忽略它会不会让你付出代价?Jev 会分别评估每个问题,然后你可以在代码里把这些分数组合起来,衡量紧急程度。
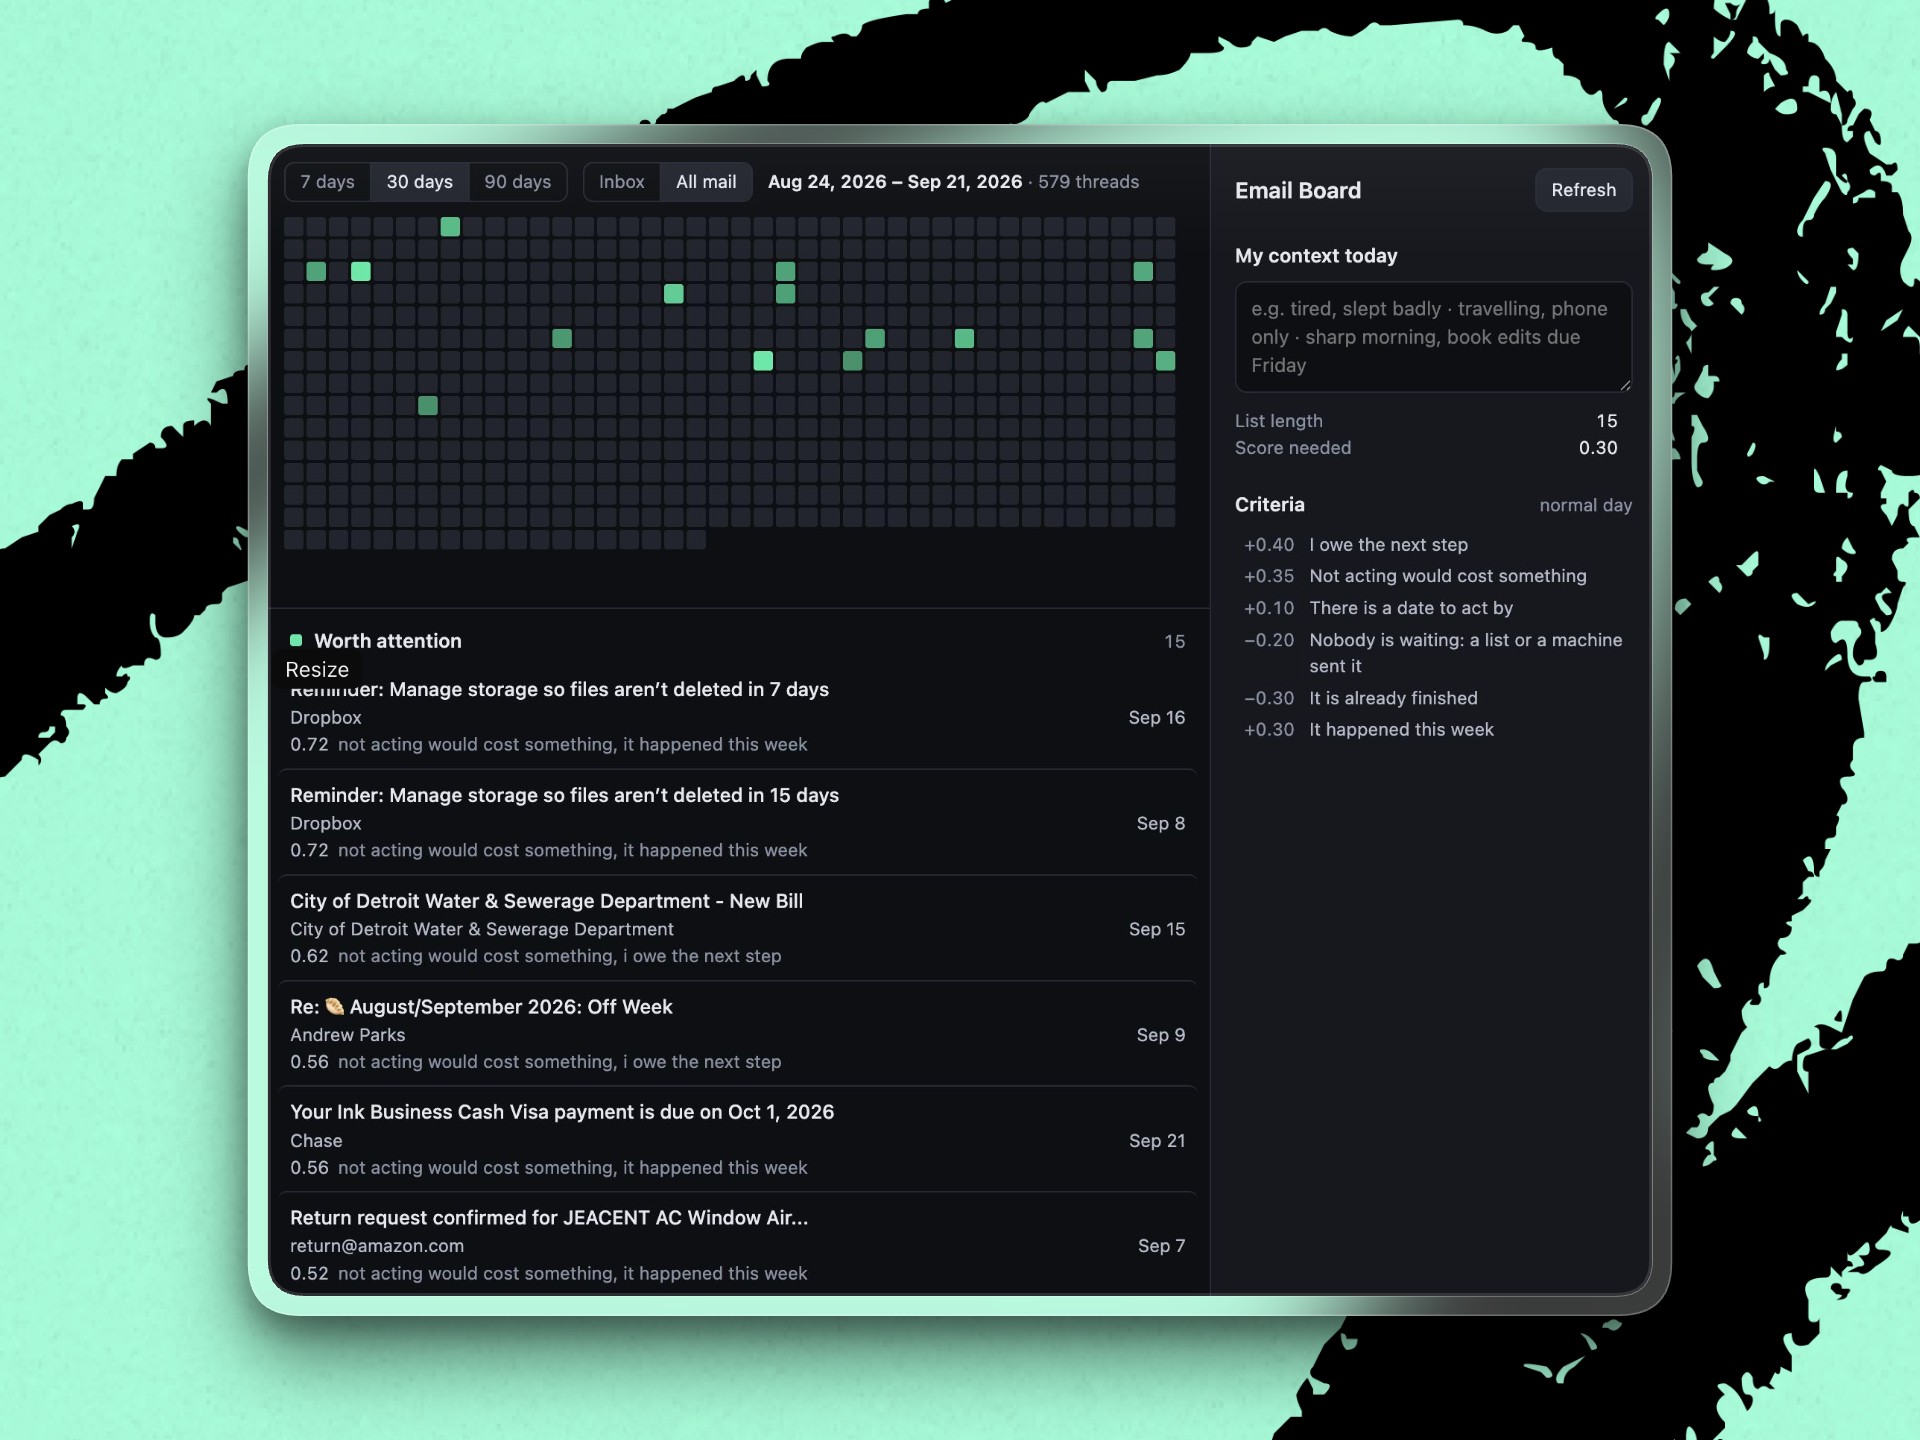 Jack 的邮件看板实验把每封邮件拿去对照一组单独的问题,并对答案加权,从而判断哪些值得他关注。(截图由 Jack Cheng 提供。)
翻译层让 Jev 用起来不像聊天机器人式 LLM 那么直观,但“它把很多兴奋感带回了编程,”Mike 说。“现在的情况是,‘嘿,如果我在定义这个问题时能更有创意一点,我就能用便宜 600 倍的方式做到。’”
为什么重要: Jev 也能和传统 LLM 配合得很好——可以把它看作一个 Codex 或 Claude Code 可以调用的工具,用来做那些狭窄但高频的判断。这样一来,你就可以使用自己选的智能体,把它的输出发给 Jev 做实时反馈。例如,Mike 说,你可以在 Codex 里起草一篇文章,让它在每个阶段都把草稿发给 Jev,检查文章是否带有 AI 腔调。当某个短语被 Jev 标记出来时,Codex 可以当场修改。或者,你可以用 Jev 判断所有频道里的哪些 Slack 消息符合你的跟进标准——并实时把它们整理成一个个人信息流。
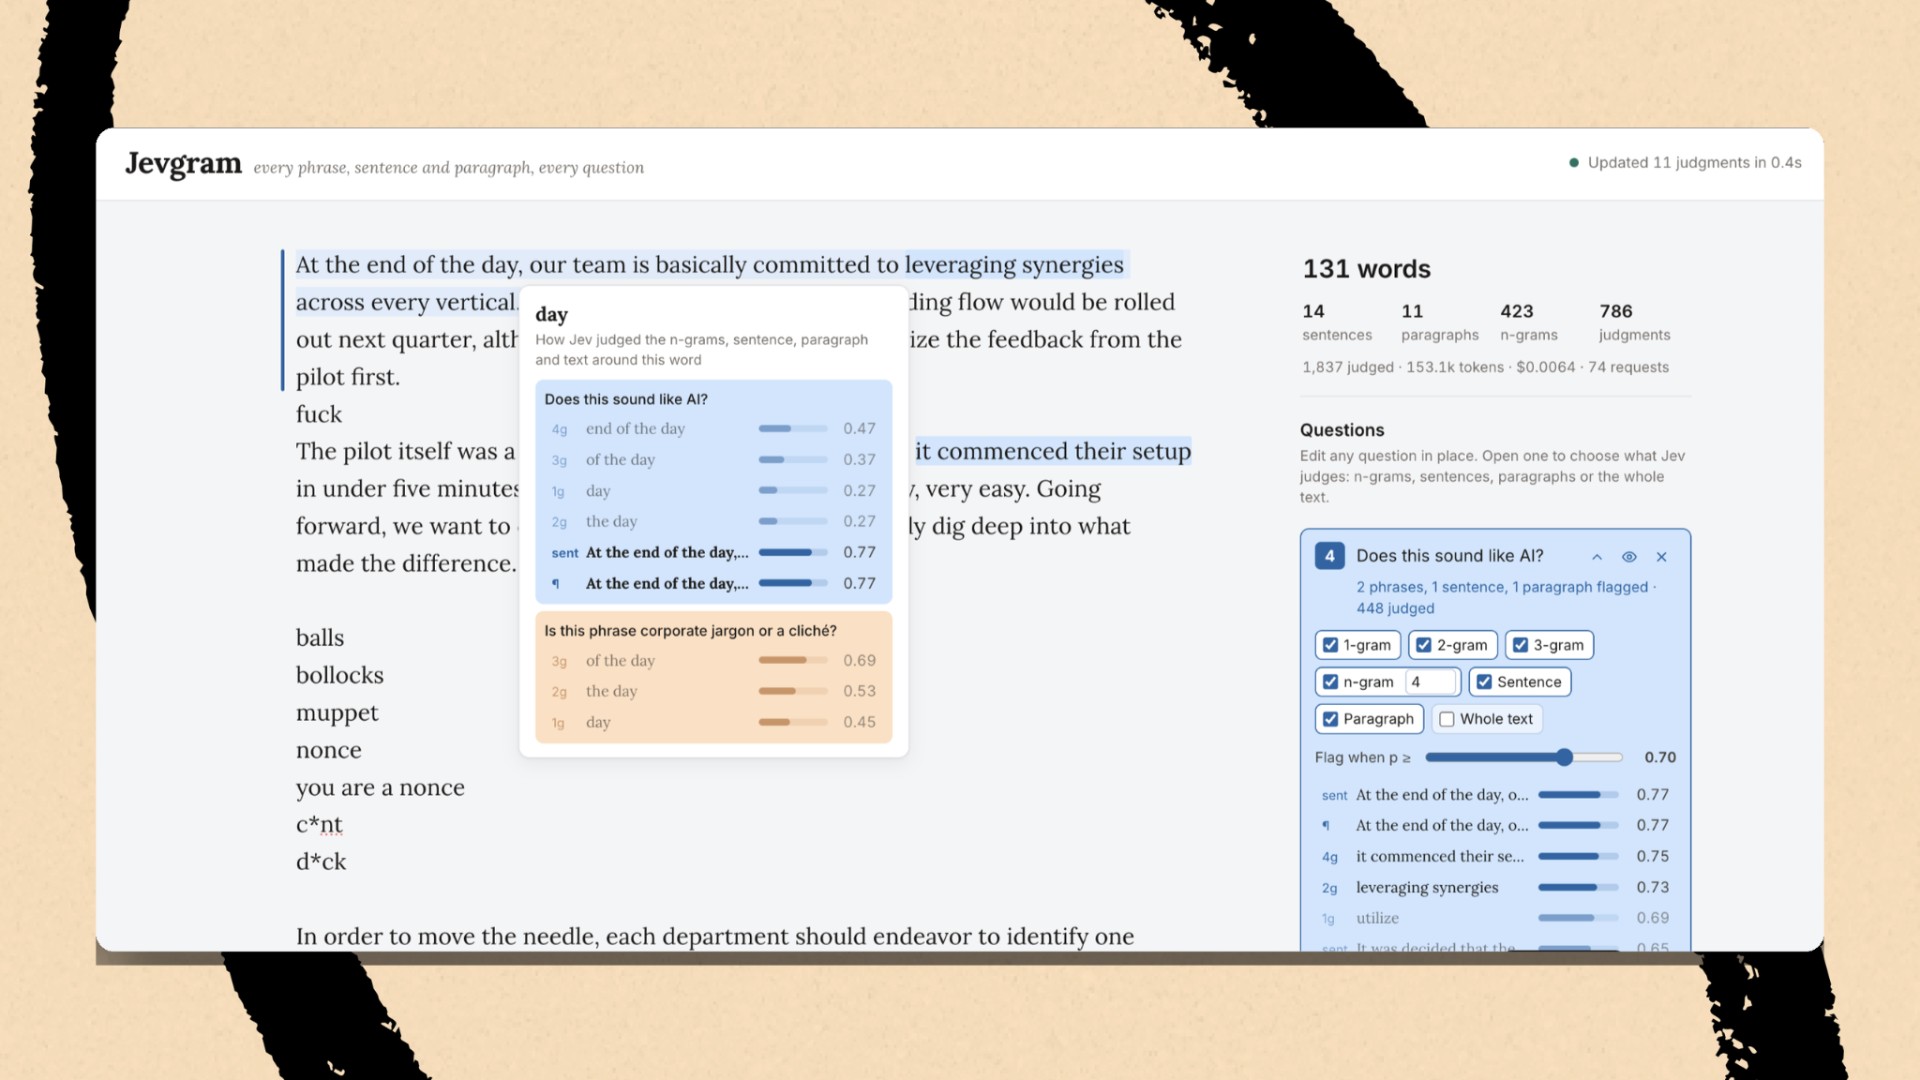 Mike 用 Jev 搭了 Jevgram,它可以让你基于文本匹配任一问题的可能性来审视文本,包括“这读起来像 AI 吗?”(截图由 Mike Taylor 提供。)
Jev 让你能“检查一切”,Mike 说。“我觉得人们才刚刚开始意识到这意味着什么。”
偷师这个工作流
把一个模糊的问题拆成 Jev 检查项
Jev 可以基于任何问题对文本分类,包括主观问题。但像“这封邮件紧急吗?”或“这段文字听起来像 AI 吗?”这样的提问,留有太多解释空间。把这类请求拆成具体的检查项,能让你更好地控制 Jev 评估的内容——也让它在分析结果与你不同时,更容易被追查。
第 1 步:安装官方 TypeSafe skill。 这会把 TypeSafe 关于 Jev 如何运作、以及如何为它构造问题的说明交给你的编程智能体。告诉你的智能体:
从 https://github.com/typesafe-ai/skills 安装官方 TypeSafe skill,然后用它帮我搭建这个 Jev 工作流。
第 2 步:用 AI 追问你的真实意图。 让 Codex 或 Claude Code 定义“紧急”“相关”或“值得一读”对你来说意味着什么。
从这条提示词开始:
    提示词

    我想用 Jev 就 [材料] 回答 [主观问题],以便我 [采取行动或做出决定]。请让我分享一些例子,并解释我为什么会选中一些、拒绝另一些,包括那些我拿不准的情况。用我的回答写出一份可用的定义。
第 3 步:把你的定义拆成离散的检查项。 为了搭建一个个性化的邮件过滤器,Jack 与 [Fable](https://every.to/vibe-check/anthropic-mythos-our-f
《How to Get the Most Out of Jev》的发芽报告
材料核心
TypeSafe 的 Jev 是一个只做分类、不生成文本的"决策模型":把任务表述成是/否、多选或打分,它返回概率,因而能以极低成本并行处理海量判断。文章的核心主张是——Jev 的价值不在于更聪明,而在于它把"判断"从"生成"里剥离出来,代价是你必须先把"紧急""像不像 AI 写的"这类模糊概念,亲手翻译成一组可判定的检查项。
发芽 01:真正的门槛不是算力,是"翻译层"
种子
文章里最容易被"4.2 美分"盖过去的一句话,是 Mike Taylor 那句:只要"在定义这个问题时更有创意一点,就能便宜 600 倍"。Jev 的定价确实惊人,但文章反复强调的摩擦点在别处——它比聊天机器人"不那么直观",因为它不接受模糊提问。于是"10 秒规则"(人类 10 秒内能做完的事交给 Jev,超过 10 秒的才动用语言模型)表面上是复杂度分界线,实际上是一条定义成本的分界线:越简单的事,越容易被说清楚;越模糊的事,越需要你先把"我到底在问什么"讲明白。
故事
医学里有一个几乎同构的做法。1997 年,Wells 等人在《柳叶刀》发表了后来被称为"Wells 评分"的深静脉血栓预测规则:临床医生不直接凭直觉回答"这个病人有没有 DVT",而是逐项打分——活动性癌症 +1、瘫痪或近期石膏固定 +1、卧床超过 3 天或 12 周内大手术 +1、整条腿肿胀 +1、小腿周径差超过 3cm +1、既往确诊 DVT +1……最后还有一项反向项:如果存在一个至少同样可能的替代诊断,扣 2 分。
这个结构值得停下来看一眼。它和 Jack Cheng 那个邮件过滤器("是不是真人写的?有没有人在等我?忽略它我会不会付出代价?")是同一件事:把一次说不清的直觉,拆成一串可以单独争论、单独修改、单独出错的条目。而且 Wells 评分里那个 −2 说明,好的拆解不是"多列几条理由",而是允许证据反向——文章 Step 4 里 Jack 发现过滤器把新闻简报标成"紧急"后回头改标准,走的就是这个动作。
再往外延一层(这里是类比,不是历史断言):2010 年代之前,语音识别依赖 MFCC 这类人工设计的特征加上 HMM-GMM 模型;2012 年 Hinton 等人把深度网络接进声学模型之后,"让人自己找特征"这件事逐渐被端到端学习取代,并成为深度学习胜利叙事的一部分。Jev 像是把这一步倒放回去——但它倒放的位置变了:以前是人替模型设计特征,现在是人替自己把概念说清楚。模型不再需要你懂它,它需要你懂你自己。
Aha 瞬间
"Jev 不要求你更懂模型,它要求你更懂自己。'紧急'这个词在它面前必须被拆成'是谁发的、我是否认识他、忽略它我要付什么代价'——这个拆解动作本身,就是一次对自己判断标准的审计。"
发芽 02:看不见画布的智能
种子
文章里最像技术细节、其实最锋利的一句是:Jev 不接受图像输入,因此从不"看见"画布。Jack 的 demo 看起来像"读懂意图",实际上是一组小问题(改哪个形状?什么颜色?放哪里?)加上一层普通代码的映射。文章用的词是 "appear to interpret intent"——appear 这个词承担了全部重量。
故事
1986 年,Rodney Brooks 在《IEEE 机器人与自动化杂志》发表分层控制架构,随后在 1991 年的《Intelligence Without Representation》里把这套想法推到底:智能不需要一个中央世界模型。他的六足机器人 Genghis(1989)能走路,靠的不是先感知、再建模、再规划、再行动的传统流水线,而是一层压一层的独立行为模块,彼此抑制与激发——没有哪一层"知道"整只机器人在干什么。
把这套架构和 Jack 的浏览器端应用并排放:语音转写、指尖坐标、画布状态被描述成形状属性列表,全部丢给 Jev 回答几个平行的小问题,再由普通代码把答案翻译成 tldraw 命令。没有世界模型,没有"理解",只有分层的行为加上一个把答案变成动作的接口。
再叠一层 Daniel Dennett 在《The Intentional Stance》(1987)里的论点:我们通过归因信念和欲望来预测一个系统的行为,这是一种有效的立场,并不要求系统内部真有对应的心理状态。我们对着恒温器说"它觉得太热了",对着 Jack 的应用说"它知道我想画蓝方块"。
Aha 瞬间
"实时感不是来自更快的理解,而是来自更小的理解。Jack 把'他想要什么'拆成'哪个形状、什么颜色、放在哪里',每个问题都快到让普通代码接得住——意图于是从心灵问题变成了工程问题。Jev 没有让机器学会读心,它让'看起来像读心'变得足够便宜、足够快。"
发芽 03:当"检查一切"变成基础设施
种子
Mike 说:"Jev 让你检查一切。我觉得人们才刚刚开始意识到这意味着什么。"Douglas 的 Grok 机器人在接入 Jev 之前每次跑不到 20 条帖子,之后超过 500 条。覆盖面扩大了二十几倍,但人的阅读带宽没有变——多出来的判断全部压在过滤器的正确性上。
文章 Step 4 那句"判断你是否同意这些分类",读起来像一句调试建议,其实是整条工作流里唯一的人类防线。它之所以被写成一个独立步骤,恰恰说明防线很薄。
故事
1997 年,Parasuraman 和 Riley 在《Human Factors》上发表了《Humans and Automation: Use, Misuse, Disuse, Abuse》,把人和自动化的关系拆成四种失效模式,其中 "misuse" 指的就是过度信任——当系统大多数时候是对的,人就不再核对,直到它错得足够大。航空业后来把这个现象叫作 automation complacency,并花了很长时间才承认:自动化程度越高,飞行员的监控能力反而越容易退化。
这和 Jev 的处境构成了直接对话。当一次判断的成本是每百万 token 4.2 美分、而输出还是免费的,"不检查"就成了经济上的默认选项。文章给出的定价表里,Jev 的输入价格比 Astra 或 Fable 5.1 低了三个数量级——这个价差买来的不是"更便宜地做同样的事",而是"以前根本不会去问的问题,现在可以问了"。问题数量从 20 涨到 500 的时候,人的注意力预算一分没涨。
Aha 瞬间
"Jev 让'检查'变得几乎免费,但没有让'发现它错了'变得免费。当一次判断的成本低于一次怀疑的成本,质量控制就不再是模型问题,而是注意力分配问题——文章 Step 4 那句'看看你是否同意',才是整条工作流里最贵的一行。"
你的思考空间
- 如果你的"紧急"定义已经被 Jev 忠实执行了 90 天,某天它漏掉了一封真正重要的邮件——你会先怀疑定义,还是先怀疑自己?这两种怀疑导向的修改方向完全不同。
- "10 秒规则"划出的那条线,到底是任务复杂度的线,还是责任归属的线?一个 11 秒的任务被交给 Jev 处理并出错了,谁来承担?
- Jack 的 demo 里,"看起来像理解意图"和"理解意图"的差别,在什么场景下会从哲学趣闻变成有代价的差别——医疗、驾驶、还是金融风控?
- 当判断的边际成本趋近于零,什么样的判断反而会变得更珍贵?是那些需要你亲自动手的,还是那些必须由你签字负责的?
- Douglas 的学习方式——"看到别人用 AI 做了件酷事,就把内容丢给 AI 说'照做'"——它的天花板在哪里?如果每个人都这样学,创新从哪来?