为什么你应该烧掉更多 Token
原文:https://every.to/context-window/why-you-should-burn-more-tokens
Every 的 CEO Dan Shipper 消耗的 token 是公司里第二高用户的三倍还多。这个差距让他感到不安:我们其他人是不是因为想得太小,才把 AI 账单压得这么低?
Dan 说,低 token 消耗本身不一定是问题,“但它应该是一个烟雾信号,尤其是在工程团队里——它提醒我们:‘也许我们这里还能做更多的事。’”
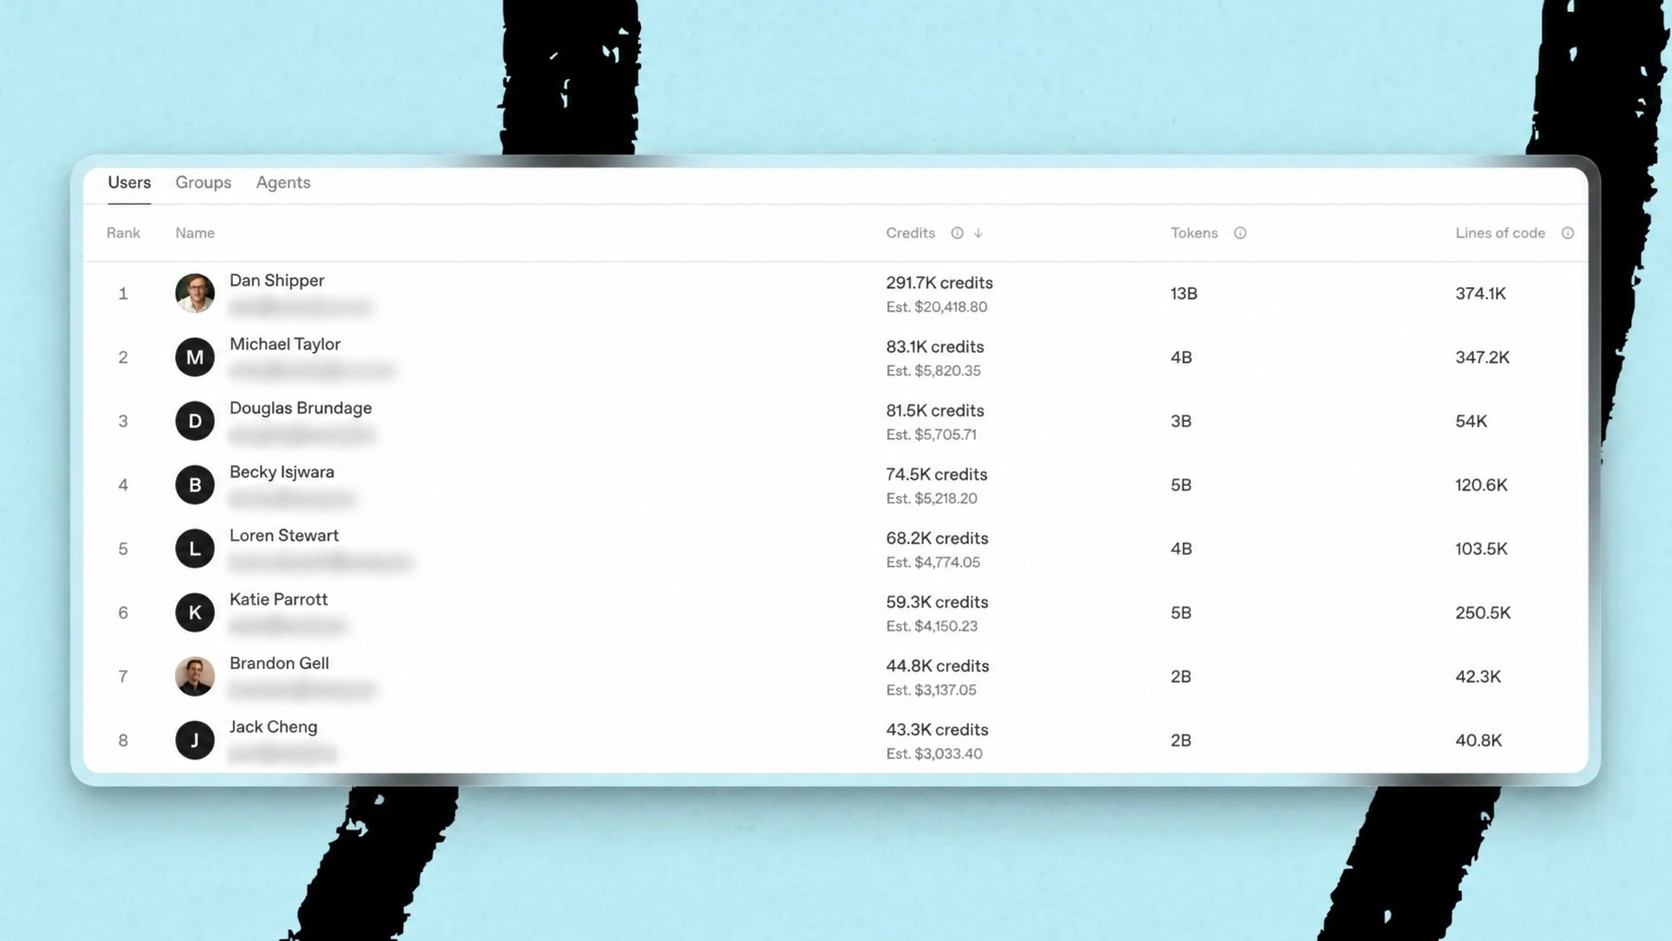
Every 的 OpenAI token 排行榜。(截图由 Laura Entis 提供。)
目标并不是 tokenmaxxing——为烧 token 而烧 token,把它当成运动项目。Dan 想做的,是给人们空间去尝试激进的新策略和工作方式;这些尝试一旦跑通,带来的生产力提升将远远超过 token 成本。
在与平台负责人 Willie Williams 的一次对话中,他们定下了一个具体的起点:先找出工程团队的主要瓶颈,看看 AI 能否消除它们,然后才做成本收益分析。
Inside Every
前沿团队里的 token 预算
Dan 不为实验设定统一的支出上限。相反,在一次昂贵的运行之后,他期望团队自问:这次结果值得花的钱吗?下次能不能用更低的成本得到相近的结果?一次昂贵的实验,如果揭示了有用的新能力或新限制,那就是值得的;而收益平平的实验,只有在能以更低成本复现时,才值得继续投入。
运营负责人 Arielle Shipper 把这套理念转化为支出决策。目前,她对昂贵运行逐案评估,用结果来决定是继续资助这项工作,还是调整方向。
她的预警系统是公司信用卡。她把 ChatGPT 的自动充值金额维持在 500 美元——每次卡被充值,她都会收到一条 Slack 推送通知,而一天里这种情况会出现多次。如果扣款异常密集地接连发生,就说明有人正在搭建或测试一个大项目,这促使她去查看用量排行榜,并联系排在最前面的那几个人。
“然后 Dan 总会回复说,‘是我在跑 Ultra,’”她说。这也解释了为什么他稳居排行榜榜首。
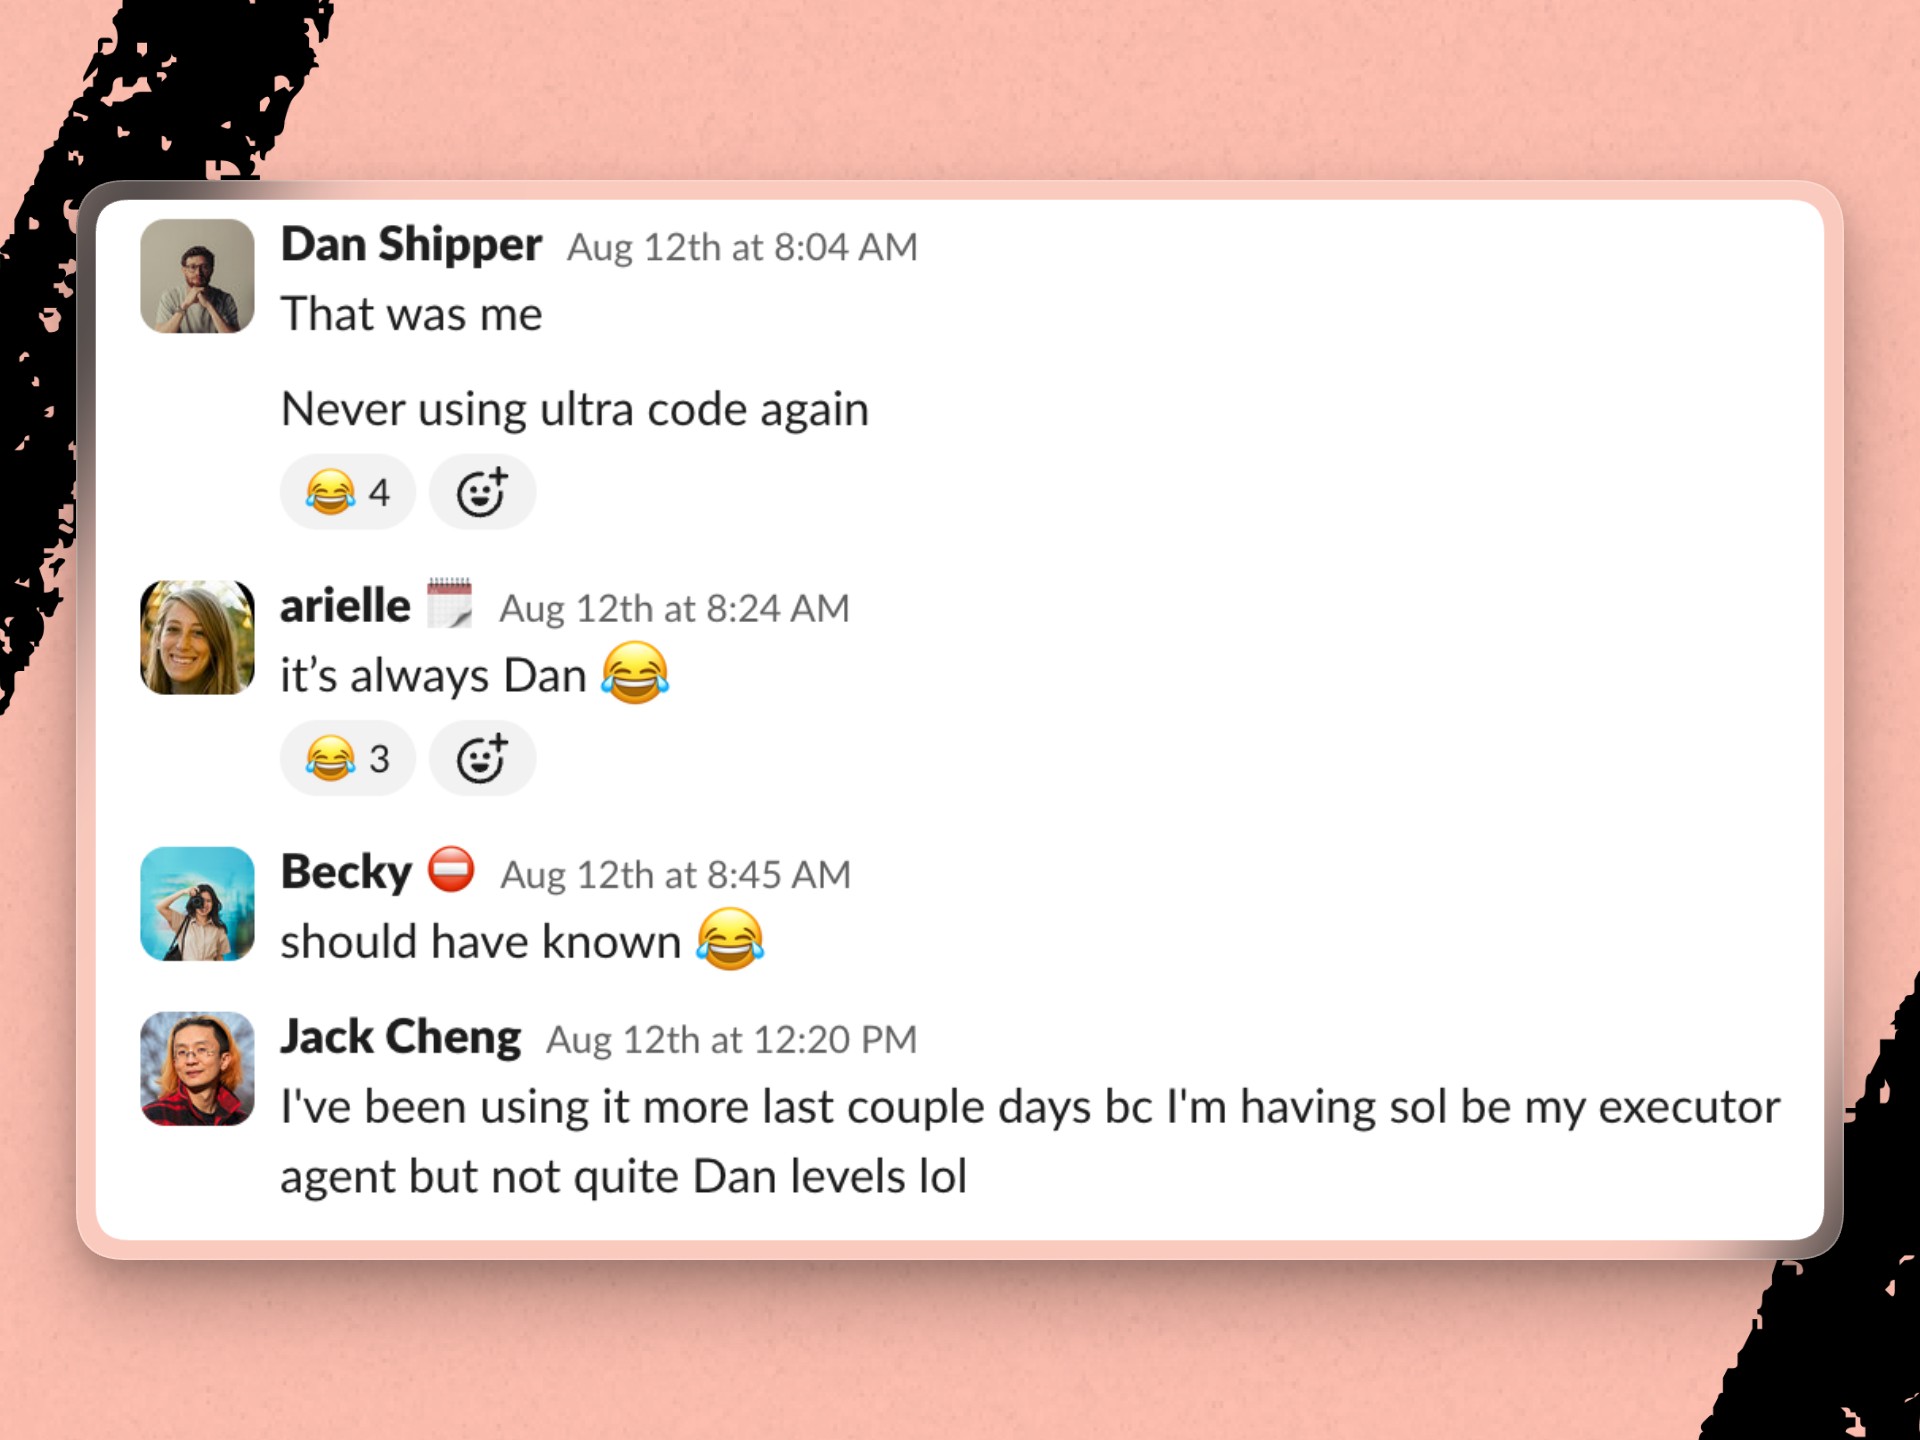
常见的一幕。(截图由 Laura Entis 提供。)
她想要三个问题的答案:这次运行花了多少钱?给我们换来了什么?我们又学到了什么?
Every 正在把这些问题嵌入自己的基础设施。团队正在开发一项技能,让员工能够创建并分享自己的 AI 支出损益表;而评估负责人 Mike Taylor 正在为每位员工创建个人基准测试,用来显示哪些模型——包括那些不那么流行、更便宜的模型——能够处理我们许多重复性任务。目标是在不打击雄心勃勃的实验的前提下,让支出和模型选择变得更加透明。
团队里很多人已经在主动回答这些问题了。在一连串 Astra 实验烧掉数十亿 token 之后,视频负责人 Randy Counsman 给 Arielle 发了消息,详细说明哪些行得通、哪些行不通、他学到了什么——而学到的非常多。
数据点
45 亿
这是 Randy 为了用 Astra 给他自己的脸做一个 3D 模型而烧掉的 OpenAI token 数量。
这个项目一开始相当无害:受社交媒体上那些用免费 3D 工具 Blender 制作的炫酷 AI 生成演示的启发,他也想自己做一个 3D 模型。毕竟,试验 AI 是他工作的重要一部分。
他使用X 上分享的策略,搭建了一个负责维护计划的编排 agent、一个负责任务分配的实现 agent,以及负责执行任务的子 agent,并指示 Codex 不断改进模型,直到它“完成得极好”,Randy 说。回过头看,“这是一个模糊的目标。”这是他当时的 prompt:
    Prompt

    你是一个管理者 agent。创建一份详细的待办清单。把这份清单交给实现 agent。部署一个实现 agent,其 /目标 是在 Blender 中极好地重现这张图片,然后它应该接着部署子 agent,其 /目标 是检查各项单独任务。
    我想要一个头部/肩部的模型,用四种截然不同的着色器渲染——spiderverse、照片级写实、复古黑色电影(vintage noir)和双色调(duotone)。在开始实现任何着色器之前,先部署一个 agent 去研究相关信息。边做边沉淀知识——这个任务的一部分使命,就是在该 repo 中沉淀知识,包括着色器风格方面。
    还应该部署一个评判 agent,根据需要把修改/反馈发回给管理者 agent。管理者随后按需把新任务发给实现 agent,直到完成得极好。
然后他就让模型跑了起来。跑啊。跑啊。跑啊。
等他暂停这个项目时,它已经跑了一天半,烧掉了数十亿 token。结果,用他的话说,“非常粗糙(very janky)”。
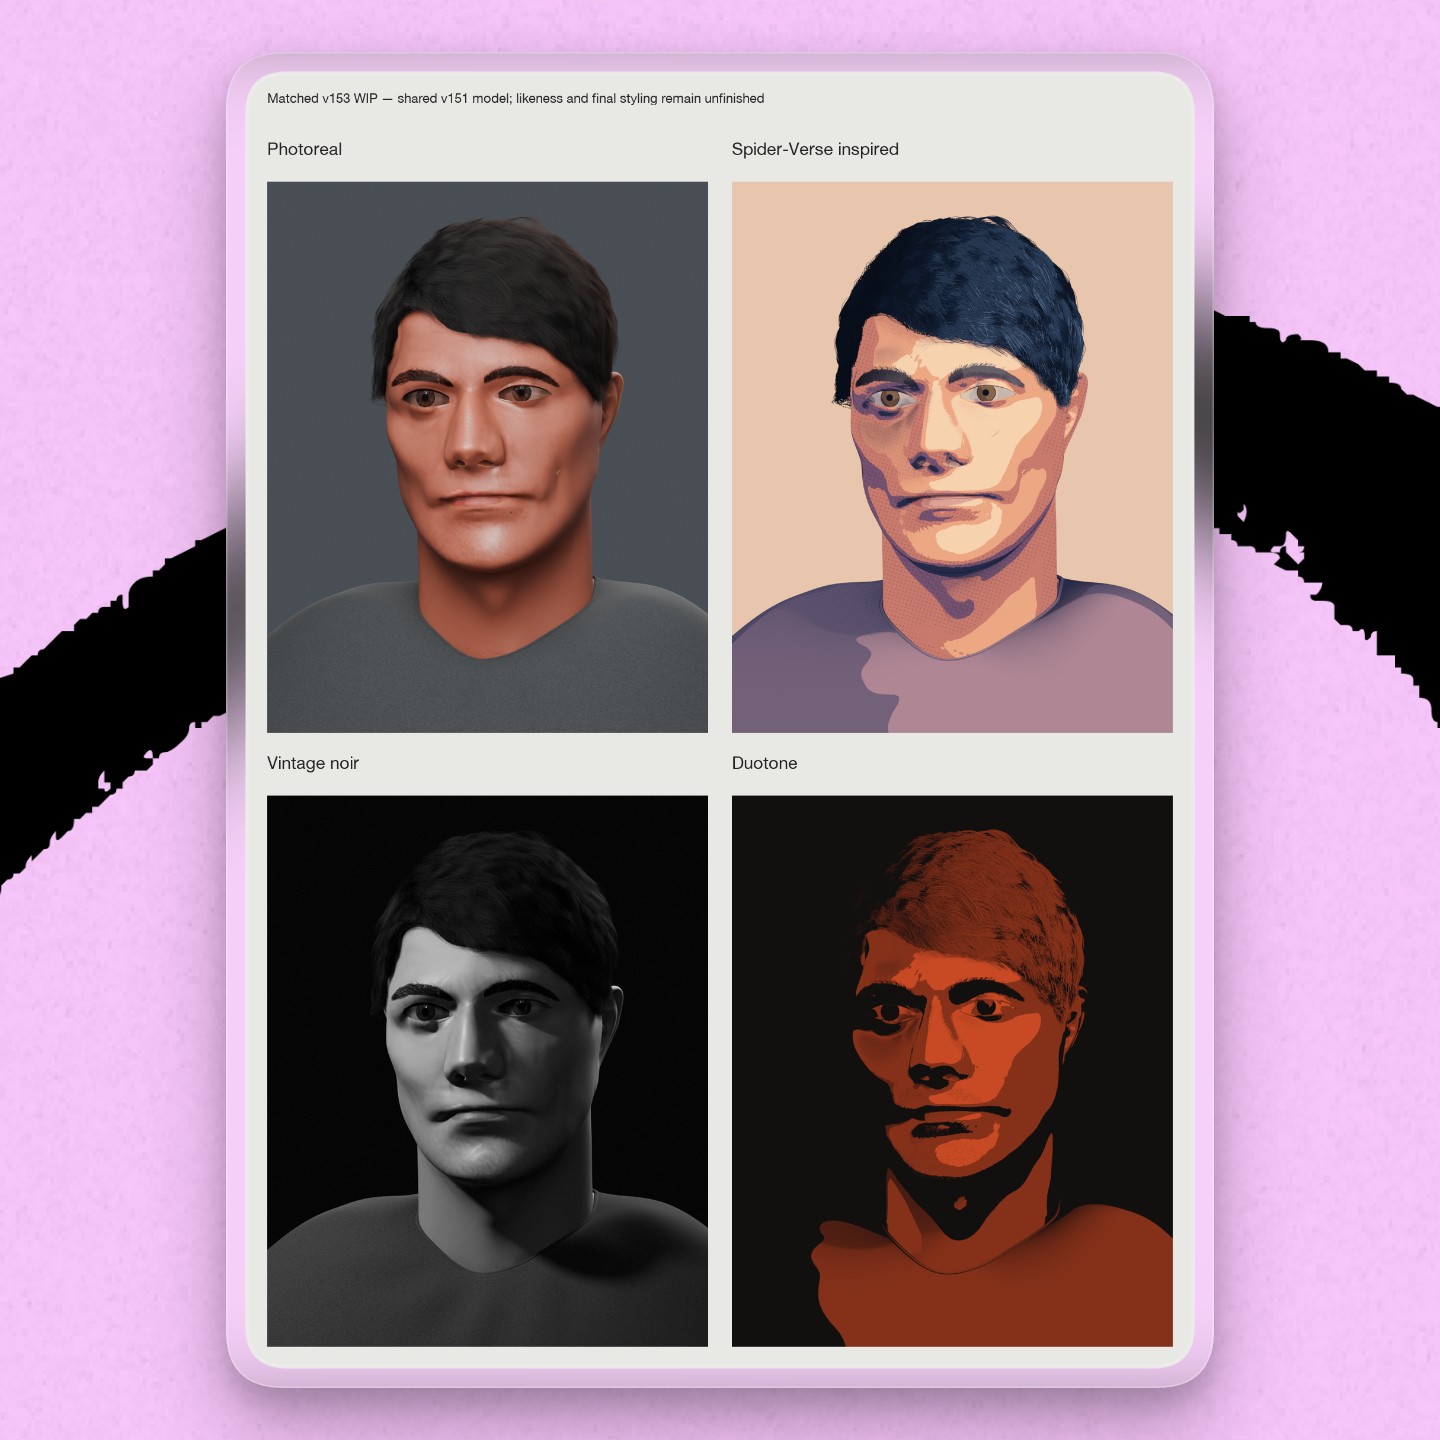
输出结果,用四种着色器渲染。(图片由 Randy Counsman 提供。)
对他 Codex 会话做的一次 AI 审计显示,他的设置制造了一个极度消耗算力的“无序 agent 群(unruly swarm)”。Randy 让编排 agent“按需”部署 agent,却没有限制数量,还加了一个实现 agent 来给子 agent 分配工作。随着运行继续,这些层级之间来回传递着越来越多的上下文——哪怕只是简单的状态检查,比如确认某个子 agent 是否完成了任务——把 token 烧在了协调上。
Randy 此后重塑了他用于复杂项目的设置。他彻底去掉了实现 agent,把编排 agent 限制为最多五个 Sol 子 agent 以控制成本,现在还会告诉编排 agent 何时暂停并征求他的反馈。在最近的一个项目里,他还生成了自己想要的设计图,这样评判 agent 就能拿模型的工作与一个具体目标对照,而不是遵循那种“不断改进”的开放式指令。
如果一个失败的实验能显示 AI 系统的短板,它仍然是一笔好投资。Randy 现在有了一个可以用来测试新模型的基准——它们能把人物、动物和角色的 2D 图像多好地转成 3D 模型——以及一套更精简的设置,用更少的 token 拿到更好的结果。
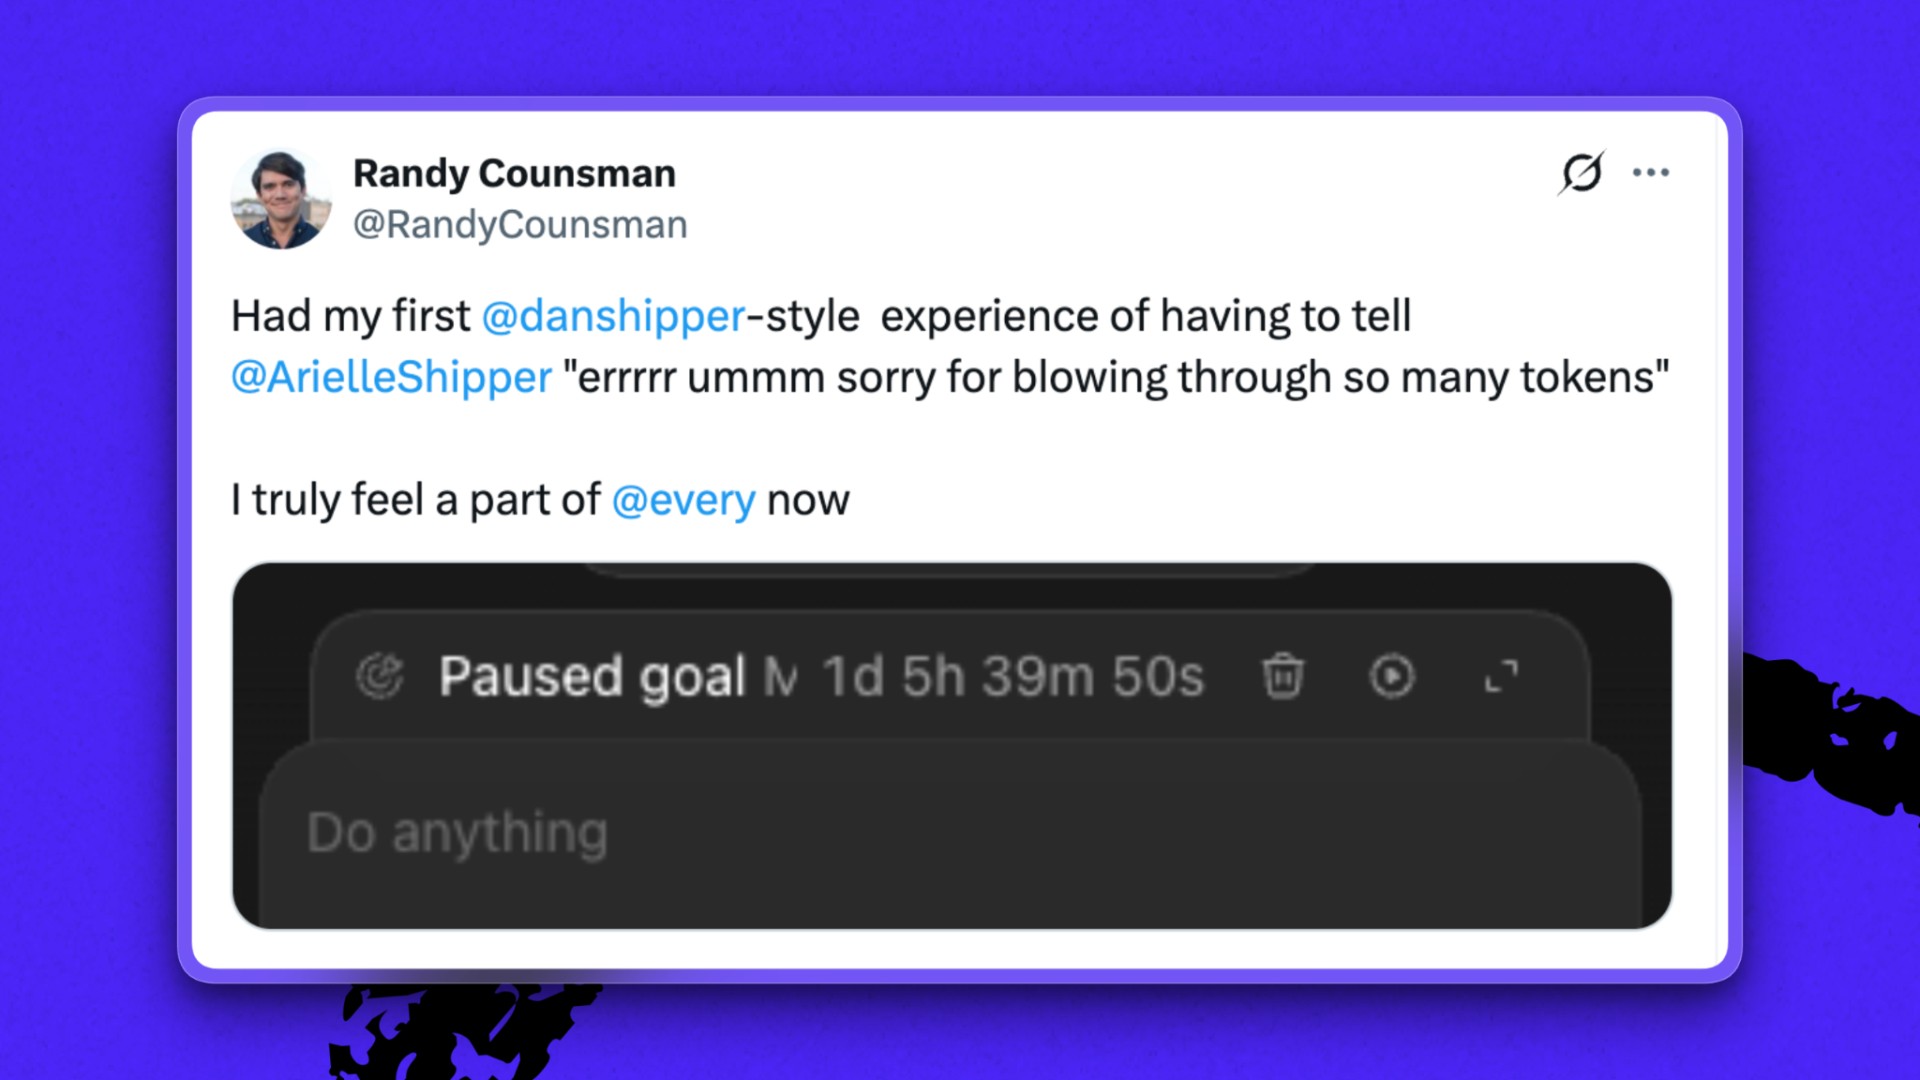
在不知不觉中因实验而大量消耗 token,是 Every 的一种成人礼。(截图由 Laura Entis 提供。)
**你也来试试:**挑一个消耗 token 超出预期的 AI 任务,把下面这段粘贴到你选择的 agent 里:
    Prompt

    查看 [任务/项目] 在 [日期范围] 内可用的会话历史和 token 使用记录,包括任何子 agent 会话。
    我当时想做 [目标]。结果是 [实际发生了什么]。帮我理解 token 都花到哪去了,以及下次我可以怎么做不一样。
    在记录允许的范围内,按活动和模型拆解使用情况。
    寻找重复劳动、不必要的状态检查,以及 agent 之间传递的大量上下文。给出具体例子。
    区分必要工作和可能的浪费。不要想当然地认为高用量或缓存输入就是浪费。
    针对我的指令、模型选择或 agent 设置,推荐三个最有用的改动。
    如果你无法访问需要的记录,告诉我需要提供什么。
偷走这套工作流
别拿 Fable 去做 Sonnet 的活
Spiral 总经理 Marcus Moretti 的 token 支出策略很直接:把自己的 Claude Code Max 套餐控制在每周用量限额之内。
这是一个简单目标,但需要主动管理;Marcus 会把工作有选择地分配给 Fable 5.1 或更便宜的模型。
第 1 步:了解每个模型擅长什么。 Marcus 使用 Anthropic 的模型已经足够久,能判断一项工作到底需要 Sonnet、Opus 还是 Fable 级别的智能。
第 2 步:把模型和任务匹配起来。 基础任务——比如分析数据检查——交给 Sonnet。目标清晰的工作,比如范围明确的产品改动,交给 Opus。对于更大的功能(比如他正在做的新计费实现),Marcus 用 Fable 5.1 来明确要构建什么、以及它该如何运作。
第 3 步:对于复杂工作,让模型去委派。 计划一旦就绪,Marcus 会加上下面这条指令——这是他在独立开发者 Simon Willison 发帖谈到之后开始使用的 prompt:
    Prompt

    “开始吧,对于所有编码任务,用你的判断决定是否委派给更低一级的模型。”
Fable 把任务分配给 Opus 和 Sonnet,然后检查它们的工作。这让最强的模型管理项目,而不必亲自执行每一项任务。
**这周就试试:**选一个重复性任务,用一个比你平时更便宜的模型来跑。在把更便宜的模型设为该任务的默认之前,先检查结果是否满足你的需求。
日常主力
团队这周在用的模型:
Douglas Brundage,市场负责人:更多地把 Fable 5.1 用于视觉工作,另外用 Grok Bot 监控社交媒体,并构建一个做视觉的工具。
Randy:复杂工作用 Astra(high),基础任务用 medium;语音模式编排用 Sol(extra high),因为他觉得“Astra 对我来说太慢、太蛮力了”。代码相关规划用 Fable,Astra token 用完时用 Opus。
Kieran Klaassen,Cora 总经理:编码和知识工作用 Fable 5.1(extra high,100 万上下文),部分研究和写作切换到 Astra。
Tyler Nishida,设计工程师:在 Cursor 中用 Fable 5.1(high)作为项目的协调-编排者,配 Grok 4.6(extra high)子 agent。个人项目用 Astra(ultra)。“它不是一个模型,但 Cursor 项目作为你偏好模型的日常主力非常棒。我的侧边栏非常干净,管理工作也容易多了。”
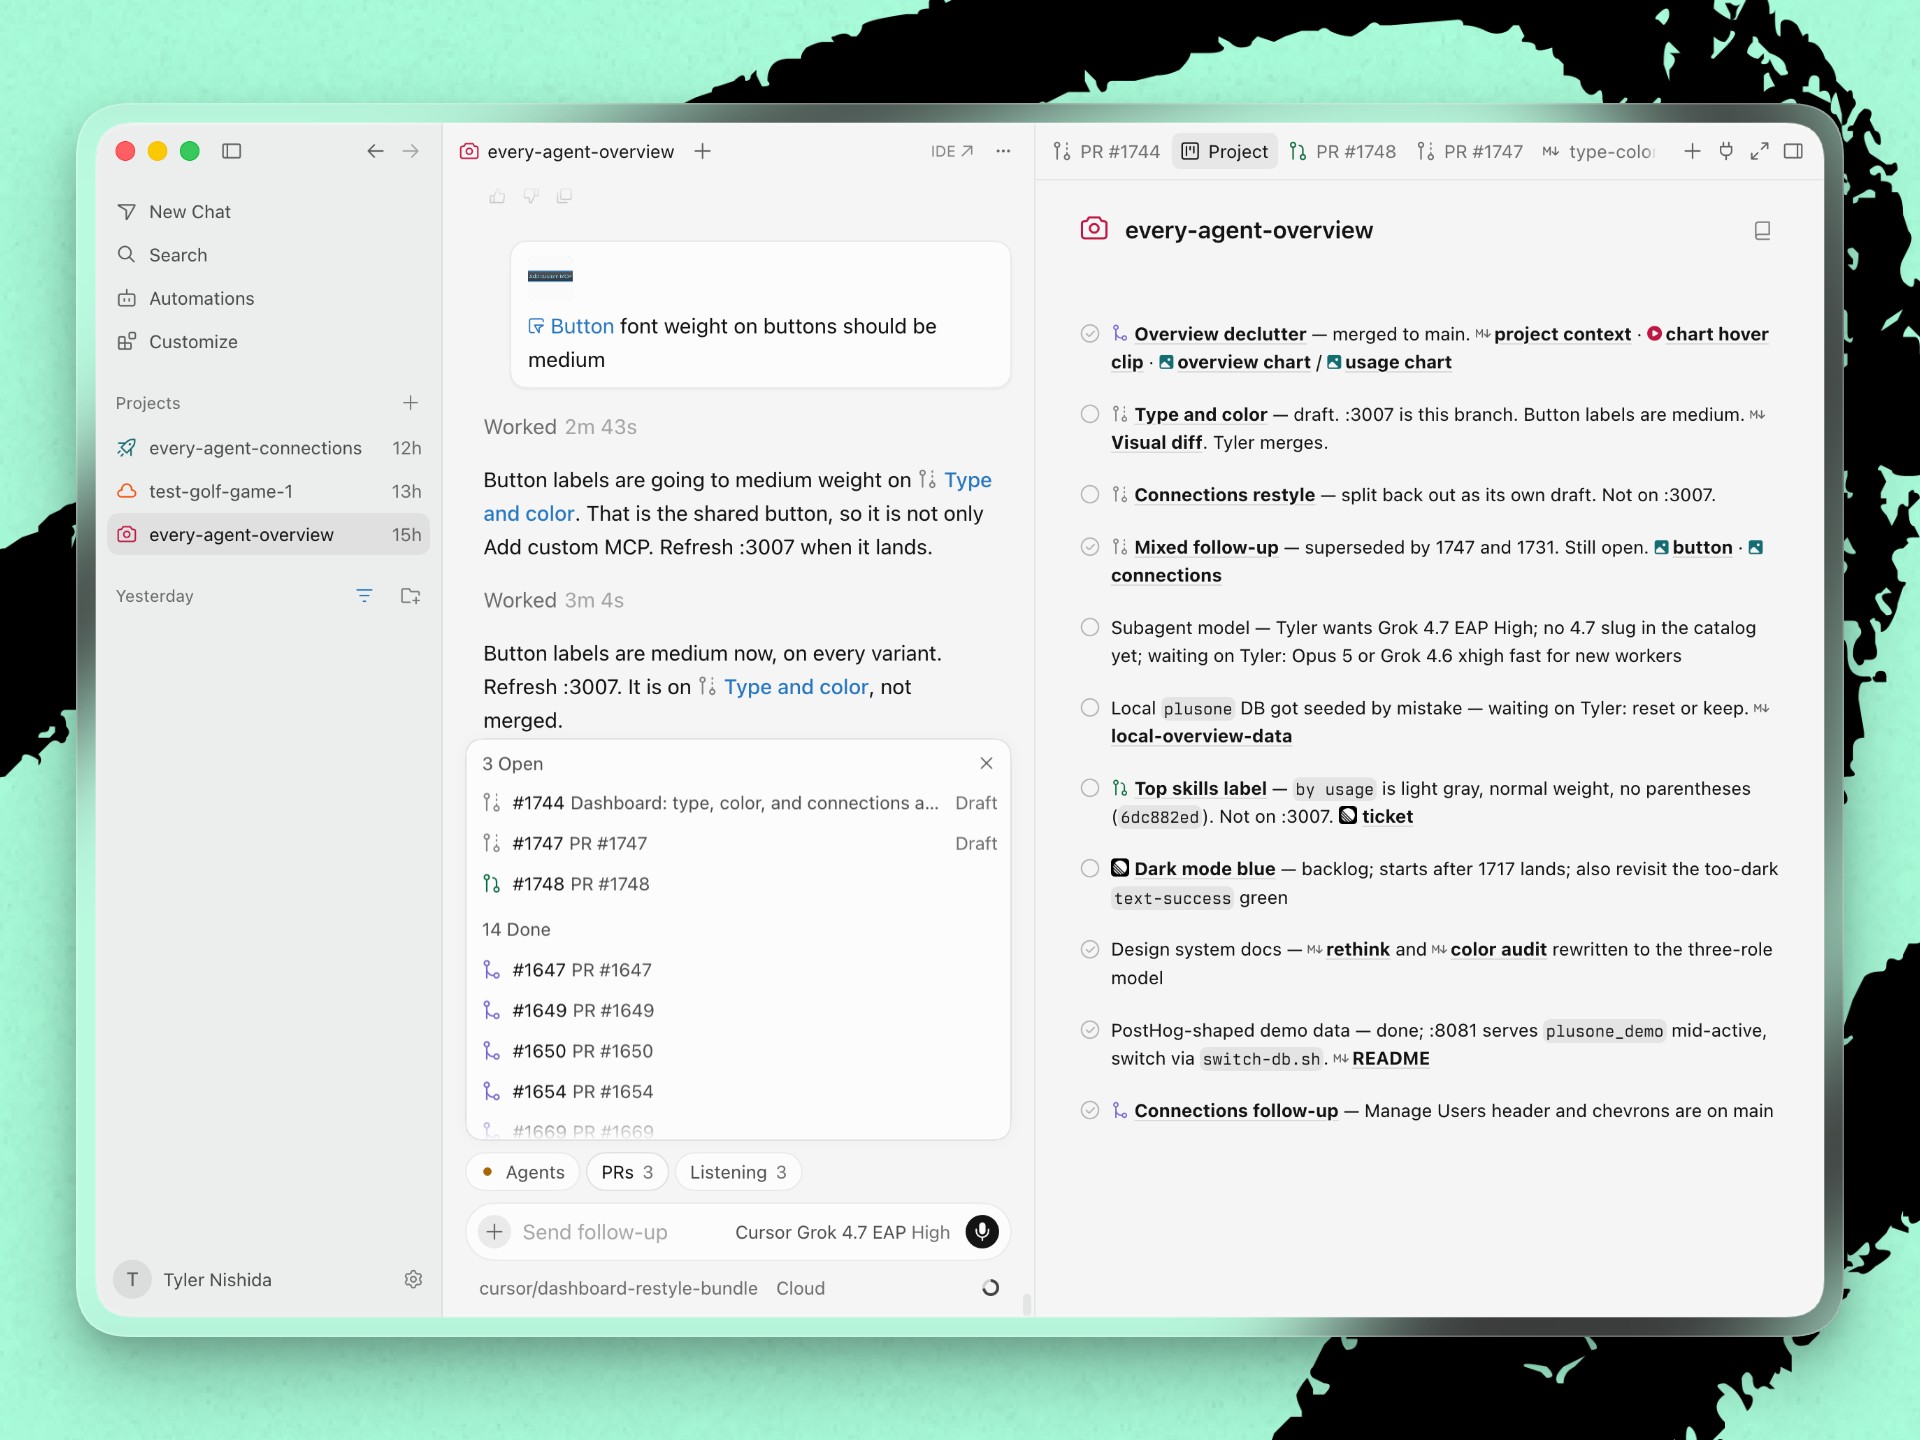
Tyler 的 Cursor 设置。(图片由 Tyler Nishida 提供。)
Katie Parrott,特约撰稿人:“Astra 的热度对我来说已经退了,”她说。如今她回到 Sol(high)做任务管理,并切换到 Claude 模型来写作,因为她觉得 Sol 和 Astra“太平——它们只是陈述事实,而不是塑造一个能把读者带进去的叙事。”
Natalia Quintero,咨询负责人:Astra(medium)。
Yash Poojary,增长工程师:Astra(high)和 Fable 5.1。
Arielle:Sol(medium)。“Sol 永远。SOLoyalist,”她说。
Loren Stewart,工程师:为了降低成本,编码从 Astra 降级到 Sol(medium),效果不错。Fable 5.1“依然是最佳思考伙伴”。
Laura Entis 是 Every 的特约撰稿人。想读更多这样的文章,请订阅 Every,并在 X 上关注 @every,在 LinkedIn 上关注我们。
核心启示:低 token 消耗本身不一定是问题,但它是一个“烟雾信号”,提醒你别因为想得太小而错失机会;真正的目标不是为烧而烧,而是通过有策略的实验去发现 AI 能消除的瓶颈——只要你能对每次昂贵运行回答“花了多少钱、换来了什么、学到了什么”,那么即便结果失败,它也可能是一笔划算的投资。
Why You Should Burn More Tokens 的发芽报告
材料核心
Every CEO Dan Shipper 是全公司 token 消耗最高的人,是第二名的三倍多——他不认为这是浪费,而把它当作一个"烟雾信号":如果工程团队花得少,可能不是省钱,而是想得太小。整篇文章的核心主张是,AI 支出应该被当作探索预算来管理,而不是成本科目:贵实验值得做,前提是它换来可复用的知识,以及日后能被压缩成可复现的低成本流程。
发芽 01:低消耗不是美德——AI 支出是"学习科目",不是"成本科目"
种子
Arielle Shipper 把 Dan 的哲学翻译成了三个问题:这次运行花了多少?买到了什么?我们学到了什么? 前两个问题属于成本会计,第三个问题不属于任何传统会计科目——而它恰恰是唯一决定了前两个问题是否值得的变量。
这不是修辞。2024 年以来推理模型的兴起,本身就建立在一个可购买的前提上:推理时间计算(test-time compute)可以换取准确率。当"想得更久"变成了可以按 token 计价的商品,公司的思考深度第一次成了一个可以明码标价的预算项。问题只剩下一个:你打算为思考付多少钱。
故事
亚马逊 2015 年致股东信里有一组被反复引用的概念:Type 1 决策是单向门,不可逆,必须慢、必须慎重;Type 2 决策是双向门,可逆,就应该由高判断力的个人快速做掉。 大多数组织犯的错是拿单向门的流程去处理双向门——每一个实验都要立项、审批、论证 ROI。
Every 的做法像是反过来给"双向门"开了预算通道:Arielle 把 ChatGPT 自动充值保持在 500 美元,每次充值都会推一条 Slack 通知,而她真正的动作不是去掐断,而是去看排行榜、找排行榜顶部的那个人。"然后 Dan 总是回我,'是我在跑 Ultra。'" 在这条链路里,$500 的自动充值不是成本科目,而是一个会计科目的开关——把"异常支出"翻译成"异常信号"。
而在另一头,Randy Counsman 在烧掉 4.5 亿 token 之后主动去找 Arielle,汇报什么成了、什么没成、他学到了什么。这个动作本质上是在给一次昂贵的失败做结账:把它从"损耗"转成"知识资产"。
Aha 瞬间
"成本会计只问一个问题——花了多少;学习会计要问三个——花了多少、买到什么、学到什么。Every 把 500 美元的自动充值做成了一个信号灯,而不是一个刹车片。"
发芽 02:Randy 的 "unruly swarm"——多智能体为什么天生烧 token
种子
Randy 的失败常被读成"prompt 写坏了"。但文章里那句审计结论更值得盯住:他的编排方式生成了一个"unruly swarm"(不守规矩的集群)。问题的根源不是模型变笨了,而是他在无意中复刻了一个官僚机构——编排者(manager)、执行者(implementer)、子智能体(subagents)、审查者(judge),层层转包,而且"需要多少子智能体"没有上限。
他自己开出的药方也一样:删掉 implementer 这一层、把编排者限制为 5 个 Sol 子智能体、让编排者在特定节点停下来等他反馈。这几乎就是组织扁平化的教科书操作。
故事
多智能体的 token 经济学已经在工程界有了公开数据。Anthropic 在 2025 年发布的工程博客中披露,他们的多智能体研究系统消耗的 token 大约是普通对话的 15 倍;同时明确划出边界——多智能体适合可并行、高价值、对上下文共享依赖低的任务,不适合强依赖、需要持续共享上下文的编码类工作。Randy 恰好把前者当成了后者:让一支需要反复同步状态的队伍,去做一件状态必须高度一致的事。
这个现象在人类组织里有个 70 年前的观察。1955 年,C. Northcote Parkinson 在《经济学人》上写下了后来被称为帕金森定律的讽刺文章:英国海军部的舰船在减少,官员却在增加——官僚系统会自行膨胀,与工作量无关。Randy 的 swarm 犯的是同一个错:agent 数量的增长不是由任务需求驱动的,而是由"编排者可以无限委派"这个结构特性驱动的。
更深一层的对应来自 康威定律(Melvin Conway, 1968):系统的架构会复制其组织的沟通结构。Randy 的 agent 拓扑长什么样,他的 token 账单就长什么样——每一层协调、每一次"子智能体完成任务了吗"的状态查询,都要经过上下文搬运,都要付钱。他砍掉 implementer 那一刀,本质上是裁掉了一层中层管理。
Aha 瞬间
"Randy 没有 prompt 问题,他有 org chart 问题。当你的 agent 系统需要一个 implementer 来给 subagents 派活的时候,你付的不是算力费,是会议费。"
发芽 03:模糊目标是烧 token 的真凶——以及排行榜的暗面
种子
Randy 对自己的诊断只有一句,却是全篇最锋利的一句:"It was an ambiguous goal." 他给模型的指令是"keep improving... until it is done extremely well"。这是一个没有终止条件的开放性目标,而开放性目标会让系统把"继续做"当成默认状态。
文章里藏着一个完美的对照实验:Marcus Moretti 把任务按清晰度分层——基础任务给更便宜的模型,目标明确的紧缩小改动给 Opus,只有大功能(比如他正在做的新计费系统)才用 Fable 5.1 来定"要建什么、怎么运作"。Randy 的修复方式也是同一逻辑的另一面:他不再要求模型"持续改进",而是先生成一张目标设计的图片,让审查 agent 有一个具体的靶子去比对。
换句话说:目标越模糊,越贵;不是因为任务更难,而是因为它没有终点。
故事
这个判断在组织心理学里有相当扎实的支撑。Locke 与 Latham 的目标设定理论(从 1968 年起的一系列研究,2002 年有系统综述)反复验证了同一件事:具体且有难度的目标显著优于含糊的"尽力而为"(do your best)——而"do your best"在实验设计里通常就是那个表现最差的对照组。Randy 的"done extremely well"正是"do your best"的机器版本,只不过这一次,代价是按 token 计费的。
但这篇文章真正需要警惕的地方在另一面。Dan 说这不是 tokenmaxxing,可公司里确实挂着一块按消耗量排序的排行榜,而 Arielle 的第一个反应也是"去查排行榜,找最顶上的人"。Goodhart 定律在这里悬着:Charles Goodhart 1975 年的原始表述是,任何被用于控制目的的统计规律都会失效;Marilyn Strathern 1997 年把它压缩成那句著名的"当一个指标变成目标,它就不再是一个好指标"。排行榜本身没有恶意,但它会把"烧 token"从学习行为变成身份信号——"是我在跑 Ultra"这句话,既可以是一次高价值探索的注脚,也可以是一次表演的台词,而两者在排行榜上长得一模一样。
区分它们的工具其实文章已经给了:Tukey 在 1977 年的《探索性数据分析》里划出的那条线——探索性分析与确认性分析必须被区别对待,前者允许反复试错,后者的结论必须经得起复现。 Arielle 那句"如果结果不错,下一步就是看能不能用更低成本复现",正是把自由的探索期和严格的确认期分开。她的裁决标准不是花了多少,而是这笔钱有没有留下一条可复现的路。
顺带一提,这条标准在别的行业早就是常识:DiMasi 等人 2016 年在《Journal of Health Economics》上的研究显示,新药从 I 期临床走到获批的成功率约 13.8%——药物研发整体接受"绝大多数失败",但它要求每一次失败都留下可读的数据。Randy 的 4.5 亿 token 之所以成立,不是因为它成功,而是因为它留下了一个可以拿新模型反复跑的 3D 生成基准。
Aha 瞬间
"'done extremely well' 是一个没有终点的指令,等于给 agent 开了一张不限额度的信用卡。真正的分界线不在花多花少,而在这笔钱有没有留下一条别人能复现的路——有,就是研发;没有,就是表演。"
你的思考空间
- 如果排行榜不叫"消耗榜",而叫"学到的东西榜",你会把什么放进分子、什么放进分母?这个改动会不会让顶尖探索者反而不敢冒险?
- Randy 的 4.5 亿 token 买到的是一套 3D 生成基准。如果三个月后一个新模型直接碾过这个基准,这次"失败实验的价值"是否也随之归零?失败实验的折旧率该怎么算?
- Marcus 的整套策略建立在一个前提上:他已经知道每个模型擅长什么。但这份"模型直觉"本身也是烧 token 烧出来的——这笔学费应该记在个人科目还是公司科目?
- Katie Parrott 说最强的模型在写作上"太扁平——它们只报告事实,而不塑造叙事"。这是否意味着"默认用最强模型"本身就是一种偷懒?还有哪些任务上,能力过剩会直接损害输出质量?
- 如果低 token 消耗是一个烟雾信号,那高 token 消耗是否也是一种信号——只不过可能是身份信号("是我在跑 Ultra")?你会用什么办法把学习行为和表演行为分开?