迷你 Vibe Check:TypeSafe 的 Jev 在 0.7 秒内评判了我写过的所有内容
并非每一个语言模型都注定要成为聊天机器人。企业需要快速、廉价、可靠的 AI 工作流,来处理那些在后台运行的各种流程:判断把一条客服请求路由到哪里、核对发票是否与采购订单匹配,或者把某些交易归类为潜在欺诈。
今天,一家新的 AI 实验室 TypeSafe 发布了新模型 Jev,它被设计用来产出你的代码可以直接使用的结构化答案。你用大白话提问——哪怕是模糊或主观的问题——它会返回"是/否"答案的概率,或者你自定义的其他分类的概率。
你可以把它想成一个聪明的 if-then 语句,用来决定自动化工作流中接下来该发生什么。假设你在构建一套给客服请求排优先级的软件,你写了段代码问模型:"这位客户听起来生气吗?"Jev 可能回答 0.9,意思是根据模型在训练中学到的东西,估计有 90% 的概率答案是"是"。你也可以提供自己定义的分类,比如"恼火""烦躁""被冒犯""暴怒""怒火中烧",然后得知这位客户有 60% 的概率被归为"暴怒",只有 10% 的概率被归为"怒火中烧"。
如果答案是 0.9(很可能是生气),软件也许会自动把这位客户的诉求升级给经理;如果答案是 0.1(不太可能生气),这条请求就可能被降低优先级。然而聊天机器人被训练成用华丽的文字回应——比如"你说得完全对,这位客户听起来确实非常生气。要不要我帮你起草一封语气友好、有支持感的回复邮件?"——而不是数字。这种文字回复会让你正在写的程序崩溃,因为它期望的是 0 到 1 之间的一个数字,而不是一篇小作文。过去我一直用 DSPy——一个用来编程模型的 Python 框架——来引导 LLM 遵从指令、返回指定的输出类型,但 Jev 把这些工作原生地做完了,这让它快得离谱、也便宜得离谱。它到底做得有多好,目前仍是未知数。
为做决策而训练
TypeSafe 的思路,是训练模型产出软件做决策所需要的结构化答案。目标是让模型的置信度与它实际答对的频率相匹配:如果它把 100 条客户消息标记为"有 90% 概率表达愤怒",那么大约应该有 90 条确实表达了愤怒。模型返回格式正确的答案,并附带信息充分的概率,你的程序可以在链条中决定下一步动作时进行校验。TypeSafe 把这种训练方法称为"校准决策强化学习"(Reinforcement Learning for Calibrated Decisions,RLCD)。
尽管像 DSPy 这样的方案能帮助开发者让 LLM 在企业场景中更可靠,但你本质上仍然是在设法把文本输出"逼"得像结构化代码。TypeSafe 联合创始人 Diogo Almeida 在向我解释为何要追求一种不同类型的语言模型时说:"问题出在文本本身。"在 OpenAI 时,Almeida 是 2022 年 InstructGPT 论文的共同作者,那篇论文展示了人类反馈如何帮助语言模型更可靠地遵循指令——这项工作是同年底 ChatGPT 问世的铺路石之一。如今他在做的是更容易在其上构建可靠工作流的 AI 模型,而且速度和成本都能在大规模生产环境中站得住脚。正如 TypeSafe 自己所说:"我们在造生产系统,不是造神。"
由于 Almeida 和团队开发并用 RLCD 训练出的 System One 架构,Jev 不像传统 LLM 那样逐字逐词地生成答案,因此不会被拖慢。它能在零点几秒内并行回答多个问题,成本仅为大多数 LLM 查询的一个零头——Jev 的定价是每十亿 token 42 美元,而大多数 LLM 是按百万计价。TypeSafe 甚至不对输出 token 收费;按 Almeida 的说法,它们"便宜到不值得计量"。
我测试了什么
我做的第一件事,是把我在 Every 写的全部 27 篇文章的文本,连同 10 篇刻意模仿 AI 风格的对照文本一起喂给 Jev。然后我用同样的 21 个问题,并发地对所有文章提问,检查是否存在 AI 痕迹。这份问题清单来自我们为根除写作中常见 AI 痕迹而创建的一套技能,包括:"文本是否重复某个观点却没有补充证据?""是否强行制造对称的'双方都有理'论证?""是否把本来直白的观点解释过度?"
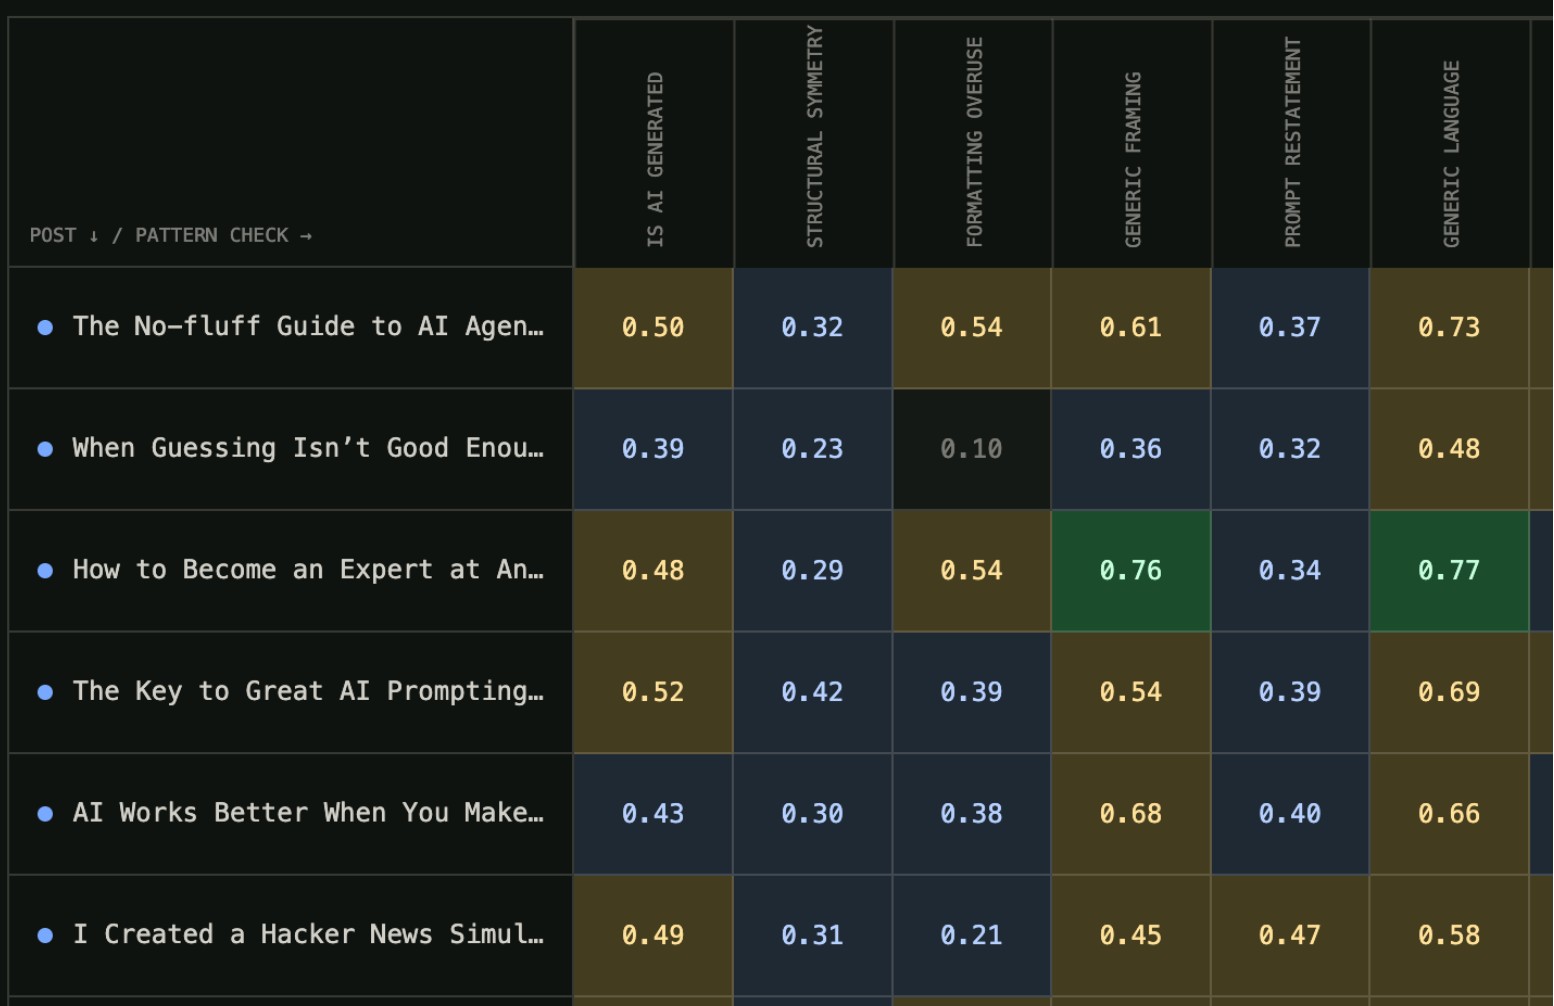
在不到 0.7 秒的时间里,Jev"读"完了全部 37 份文档,为每份文档回答了 21 个问题,总共返回 777 条判断,估算成本约为四分之一美分。这又快又便宜,足以让"AI 检查"你公司里每个人写过的所有东西,并在一瞬间拿到结果。至于你信不信这些结果,那是另一个问题——当我翻看被它分类的文章时,Jev 正确地标记出了我那些更依赖 AI 的篇目,但在把它投入生产之前,我会希望做一次更彻底的准确性检查。即便有这个保留意见,它作为一套早期预警系统依然有用:另一种选择就是根本不检查。
我总共跑了 11 个实验来探索不同的用例(这里有更详细的说明),例如:
- 查找上下文: 找到正确的代码文件;帮 agent 在代码库中导航;检索能回答某个问题的公司政策。
- 检查工作: 给客服回复打分;标记 agent 提出的风险操作;检查我的写作里有没有 AI 痕迹。
- 做决策: 给创业公司的路演材料排序;给需要帮助的客户排优先级;识别哪些决策需要 CEO 拍板;判断哪些邮件今天需要回复;询问 100 个模拟用户会点哪个广告。
在这一整套实验里,TypeSafe 共做出 1,709 条判断,估算总成本不到一美分。我用 Codex 里的 GPT-6 Astra 创建了这些场景,它无需我任何引导就能读懂 TypeSafe 的文档——传统 LLM 很擅长知道该怎么写查询、怎么使用结构化输出。
知识工作的代码 linter
在软件开发中,代码 linter 是一种分析你代码的工具,几乎能瞬间标出语法错误、抓到 bug、发现坏模式、并强制风格一致。TypeSafe 的模型在把模糊任务转成清晰、结构化答案这件事上快到可以充当知识工作的某种"代码 linter"。把 Jev 和一个问题清单交给 Codex 或 Claude,它就能快速检查自己的作品里有没有你要求它避免的问题。
在 Every,我正在为全公司每个人构建一套个人基准(personal benchmark),总得有人来打分——所以我一直在用 AI 审查其他 AI 模型的输出。我们会选取你经常做的 5 到 10 个任务,保存一些样例,把你的偏好转化为一条条通过/不通过的检查。为了检查"这份 PowerPoint 是否合乎品牌调性?""这条社交媒体文案有没有好钩子?""模型会不会推荐和我一样的东西?"这类主观标准,我们拿结果与你的判断作对比,不断打磨这些检查,直到分数能真正帮助你决定工作该用哪些模型或技能。TypeSafe 又快又便宜,我们可以在工作进行过程中多次运行检查,而不只是等最后对少数进入基准的任务检查一次。
Every 的 CEO Dan Shipper 更直接地测试了"代码 linter"这个想法。他给了 Jev 和 Fable 5.1 同样的四项写作检查,用来检查他为这次测试生成的 12 段合成文本:六段清晰的,六段刻意引入了问题的。这些检查问的是:某个动作是否没有解释、某个推理环节是否缺失、某个机制是否取代了原本想要的结果、某个论断是否歪曲了它的来源。
Jev 每段文本耗时中位数为 0.35 秒,而 Fable 5.1 在高强度模式下是 8.83 秒——大约快 25 倍。其估算成本比 Fable 低约 580 倍。但 Jev 抓到了 7 个预期缺陷中的 6 个;Fable 抓到了全部 7 个。有一段文本提议"一份由家长和教职工共同'教授'的共享预约日历"。教日历是什么意思?Fable 抓到了这个没有解释的动作。Jev 三次运行都漏掉了它,但以几分钱对几块钱的代价,七个抓到六个已经不错了。
就像 Astra 擅长操作电脑改变了我们的工作方式一样,这一类新模型将打开新的机会。想象一下,让 Codex 或 Claude 每写完一段就运行这些检查。Jev 可以标出可能的问题,然后写作模型可以审查这一段,决定要不要在继续之前修改。你最终会得到一份通过了你所有检查的终稿,于是你就不必花那么多时间留在"人在环路"里了。
谁该试试它
如果你正在用 AI 构建东西,请找一个你本来就需要的、会反复做出的判断,作为试用 Jev 的第一个好测试。我的测试是:agent 有没有为任务找到正确的上下文,以及它的输出有没有达到我的标准。TypeSafe 的速度和成本让"在任务进行中多次问这些问题"变得可行,而不是等你到最后才发现问题。如果你在自动化工作流方面经验不多,你得为这种新型模型发挥一点创造力。但只要某个场景适合问模糊问题、拿到结构化答案,Jev 就值得一试。
我们并不常有机会摆弄一种新类型的模型,而那些以前因不可行而无法构建的新应用,如今将变得可能。去找那些你因为现有 LLM 分类得不够快、不够便宜而没法实现的想法。把模型的准确性与现有的 LLM 作对比,确认它对你的用例来说足够准确。最终的检验是:照着这些答案去行动,能否让工作变得更好。
核心启示:Jev 代表了一类新的语言模型——它不生成文字,而是直接输出能驱动代码的结构化概率,并配以与真实命中率对齐的置信度。当"做判断"变得又快又便宜,AI 检查就能从"事后抽查"变成"全程随时运行"的代码 linter,而真正的门槛也随之从"能不能问"转向"你信不信这些答案、照着它行动是否让工作更好"。
Mini-Vibe Check: TypeSafe's Jev Judged Everything I’ve Written in 0.7 Seconds 的发芽报告
材料核心
Mike Taylor 测试了 TypeSafe 的新模型 Jev:它不是聊天机器人,而是用 RLCD 训练、输出概率与分类结果的结构化判断模型。0.7 秒内,Jev 对 37 篇文章做出 777 次“AI 写作痕迹”判断,成本约四分之一美分;Dan Shipper 的对照实验中,它比 Fable 5.1 快约 25 倍、便宜约 580 倍,但漏掉了一个明显缺陷。文章的核心机会是:当“判断”变得极快极便宜,知识工作可能出现自己的 linter;核心问题是:准确率和行动阈值是否足够可信。
发芽 01:从“会说话”到“可接线”:判断型模型的古老血统是校准
种子
文章里最关键的分界线,不是“Jev 能不能回答”,而是“它回答的是不是代码可消费的概率”。传统 LLM 被训练成生成流畅文本,Jev 被训练成输出 0 到 1 之间的置信度:问“这个客户生气吗?”,返回 0.9;问“这段文字有没有 AI 味?”,返回每种 pattern 的概率。TypeSafe 把这称为 Reinforcement Learning for Calibrated Decisions,也就是 RLCD。目标是:如果它给 100 条消息标 90% 愤怒,那么大约 90 条真的愤怒。
故事
这不是 AI 第一次追求“校准”。气象预报早就用类似语言说话:说“70% 概率下雨”,不是修辞,而是要求长期看,在所有 70% 预报里确实约七成下雨。1950 年 Glenn W. Brier 提出的 Brier score,就是衡量概率预报误差的经典工具。后来 Philip Tetlock 的 Good Judgment Project 发现,表现最好的“超级预测者”并不靠更戏剧化的叙事,而靠把模糊判断拆成可校准的概率,并持续用结果反馈修正。
Jev 的 RLCD 本质上把这条路线从人搬到了模型:不追求“像人一样解释”,而追求“像仪表一样可检验”。文章里 Diogo Almeida 那句“We’re building prod, not God”,正好是这种工程伦理的注脚。Jev 不是要成为全知者,而是要成为生产系统里一个可靠、便宜、可接线的判断节点。
Aha 瞬间
“Jev 的价值不在于它更会写答案,而在于它把语言模型从‘作者’改造成了‘仪表盘’:输出不是观点,而是可接线的读数。”
发芽 02:知识工作的 linter:当检查成本趋近于零,质量控制从审计变成实时免疫
种子
文章把 Jev 类比为“code linter for knowledge work”。代码 linter 不会替你写程序,但它会在你写的时候立刻指出语法错误、坏模式和风格不一致。Jev 的 0.7 秒、777 次判断、四分之一美分,正是把这种“即时检查”带到了写作、客服回复、Agent 行为、公司政策检索等模糊任务上。更关键的是,文章说 TypeSafe 便宜到可以在工作过程中反复运行检查,而不是等到最后做一次评测。
故事
Linter 本身有具体历史:1978 年,贝尔实验室的 Stephen C. Johnson 为 C 语言写了 lint,用来扫描代码中可疑、不可移植或可能出错的写法。名字来自衣服上的 lint——细小的、容易忽略的毛絮。它不解决大问题,只在你忽略的地方提前报警。
制造业也有类似逻辑:丰田生产系统中的“安灯绳”允许任何一线工人在发现异常时拉停产线,把质量控制从最终抽检前移到问题发生的那一刻。Jev 如果足够便宜,就相当于给知识工作装了一根安灯绳:不是月底 review 时才发现“这篇稿子有 AI 味”,而是每写一段就亮一次灯。文章里 Mike Taylor 的设想正是这个方向:给 Codex 或 Claude 这些检查,让它写完每段后自己判断要不要修订,最终交出一份通过所有检查的草稿。
Aha 瞬间
“当一次判断便宜到四分之一美分,质量控制就不再是事后审计,而可能变成实时免疫系统:问题不必被攒到 review 阶段,它在生成的瞬间就被标记。”
发芽 03:0.7 秒的诱惑:便宜到可以反复问,不等于值得无条件相信
种子
Mike Taylor 没有把 Jev 写成万能工具。他明确说:Jev 正确标出了他一些更依赖 AI 的文章,但“要放进生产环境,我还想要更彻底的准确率检查”。Dan Shipper 的对照实验更尖锐:Jev 比 Fable 5.1 快约 25 倍、成本低约 580 倍,但 Fable 抓到全部 7 个预期缺陷,Jev 只抓到 6 个,而且在一个“家长和 staff 一起教日历”的荒谬句子上连续三次漏判。也就是说,Jev 的杀手锏是速度和成本,不是绝对准确率。
故事
这背后是一个古老的管理与测量问题。1975 年,英国经济学家 Charles Goodhart 提出后来被称为 Goodhart 定律的观察:当一个指标被用作控制目标,它就会开始失效。Marilyn Strathern 后来把它压缩成更流行的版本:“当 measure 变成 target,它就不再是好的 measure。”
如果公司因为 Jev 便宜,就把“AI 味概率 > 0.6”直接当成惩罚依据,写作风格会被指标反向塑造:人们学会的不是更清晰,而是更像 Jev 训练数据里的“非 AI 味”。医疗筛查也提供类似教训:一个检测便宜、快速,不等于可以直接行动;关键在敏感度、特异度、基础率和假阳性成本。
文章最后一句其实已经给出了正确判据:“The ultimate test is whether acting on the answers makes the work better.” Jev 把判断成本压到近乎为零,但决策成本没有消失。真正的问题不是“能不能问”,而是“错了之后你愿不愿意承担后果”。
Aha 瞬间
“Jev 把判断成本压到近乎为零,但决策成本没有消失。真正的分界线不是‘能不能问’,而是‘错了之后你愿不愿意承担后果’。”
你的思考空间
- 如果 Jev 这类模型把“判断”变成廉价基础设施,你所在团队里哪个反复发生、却总被拖延的主观判断,最该先被 linter 化?
- 当模型用 0.9 的概率告诉你“这个客户很生气”,你的自动化系统应该直接升级,还是应该先设计一个“人类复核阈值”?这个阈值如何随错误成本变化?
- Jev 漏掉“教日历”那种明显缺陷,却抓到多数其他问题。你更愿意要一个 86% 准确但便宜 580 倍的检查器,还是一个 100% 准确但一次要等 8.83 秒的检查器?为什么?
- 如果“AI 味检测”本身被纳入绩效或发表流程,写作者会如何反过来优化这个指标?这是不是在制造新的 Goodhart 陷阱?
- 文章说“We’re building prod, not God”。在你的工作流里,哪些任务需要“神谕式”答案,哪些只需要“生产级概率判断”?二者的边界在哪里?