文件夹就是智能体
下周,我们将发布 Cora 总经理 Kieran Klaassen 的反思文章,内容关于:当复合工程(Compound Engineering)将人类构建者从生产瓶颈的位置上移除之后,他们如何持续积累优势——而不是就此停止工作。在它发布之前,我们先重新发布他四月发表的这篇关于“文件夹即智能体”(folder-as-agent)方法的文章。正是这套方法,让 Kieran 得以可持续地协调 44 个专门化智能体。阅读完整的复合工程指南,并安装复合工程插件。——Kaushik Viswanath
我花了三个月时间,试图让智能体集群(agent swarms)真正运转起来。
作为 Every 的 AI 邮件助手 Cora 的唯一工程师,通过同时协调多个智能体来让自己“乘以多份”是一个非常有吸引力的想法。如果我能召唤一支 AI 智能体舰队,让它们互相协作,然后看着它们产出任何单个智能体都无法独立完成的工作,那就能缓解我的过载感。
为了让它成功,我尝试了所有方案——Claude Code 团队、智能体向其他智能体派发任务、由主智能体管理一个工作池的编排架构。迭代了许多次,也烧掉了大量 token。
但更多智能体并没有让我更快。我已经并行运行 Claude Code 会话好几个月了,这种方法在“每个智能体有清晰任务、由我做总指挥”时有效。但集群实验不同:智能体与智能体互相协调,自行决定做什么,产出我并未预先塑造的内容。当其中 10 个同时完成时,我面前有 10 个需要评估的结果,却没有足够的上下文知道哪一个可以信任。AI 智能体没有速度上限,但管理它们的人依然有。
我继续寻找更智能的编排层——一个更好的协议,或一个更严密的框架,能过滤输出并告诉我哪一条结果值得信任。然后我停下来,看了看真正在干活的东西。
它是我早就拥有的——一个文件夹。
一个项目文件夹,里面有 CLAUDE.md/AGENT.md(告诉 AI 如何在你的项目中工作的文件)、一些技能(skill)定义,以及几个月复合工程积累下来的上下文——这就是一个智能体。这个文件夹给 AI 模型的上下文,把一个通用模型变成了你希望它擅长的任何任务或领域的专家。
现在,我在多个项目中运行着 44 个这种“文件夹即智能体”。每一个都运行在一个我花了数月构建和测试的专门化文件夹里,而我构建的一个调度层(dispatch layer)负责在它们之间路由。下面是它的工作原理。
藏在你硬盘里的智能体
人们听到“智能体”时,脑中浮现的是一台鲁布·戈德堡机器【补充:指用极其复杂的连锁传动机构来完成一个简单任务的设计,以讽刺过度工程化】——几十个滑稽复杂的活动部件,一个触发一个。但智能体其实简单得多:一个拥有足够上下文的模型,这样你每次打开对话都不必重新解释一切。
举个例子:Cora 的所有代码都存放在 GitHub 上 Every 组织的一个项目文件夹里。当我用 Claude 打开这个文件夹时,Claude 能看到代码和结构。但它不知道我的工作方式和关注点,这正是文件夹里还包含一个 CLAUDE.md 文件的原因。这个文件告诉 Claude 我如何命名事物,以及如何组织测试。
这就是一个智能体——不是一个花哨的智能体,但仍然是智能体。只要把模型指向这个文件夹,而这个文件夹里包含一些我的个性、知识和品味,模型就能成为我的代码库的专家。
Claude Skills——给模型特定能力的文件——就是这种“文件夹即智能体”结构的一个例子。在人们称它们为“技能”(skill)之前,大家已经在写装满指令的 markdown 文件,并把它们放进项目目录里了。
我的 ~/cora/ 文件夹走得更远:
- 约定与标准:CLAUDE.md 覆盖了 Rails 约定、部署工作流和数据库模式。
- 机构知识:docs/developer-docs/ 目录保存着任何新智能体都会自动继承的累积知识,包括架构报告、邮件处理管道,以及助手系统设计。
- 运行记忆:docs/runbooks/ 和 docs/investigations/ 记录了从真实事故中积累出来的运维模式。
- 专门智能体:.claude/agents/ 保存着我数月打磨出来的专家:审查者、规划者,以及助手组件创建者。
当我把模型指向这个文件夹时,模型从一开始就拥有 Cora 对自身的全部认知。
我给每一个接触 Cora 的新智能体的读取顺序是:先读 CLAUDE.md,然后是架构文档,然后是助手系统报告,然后是助手的提示词,最后是组件创建智能体。
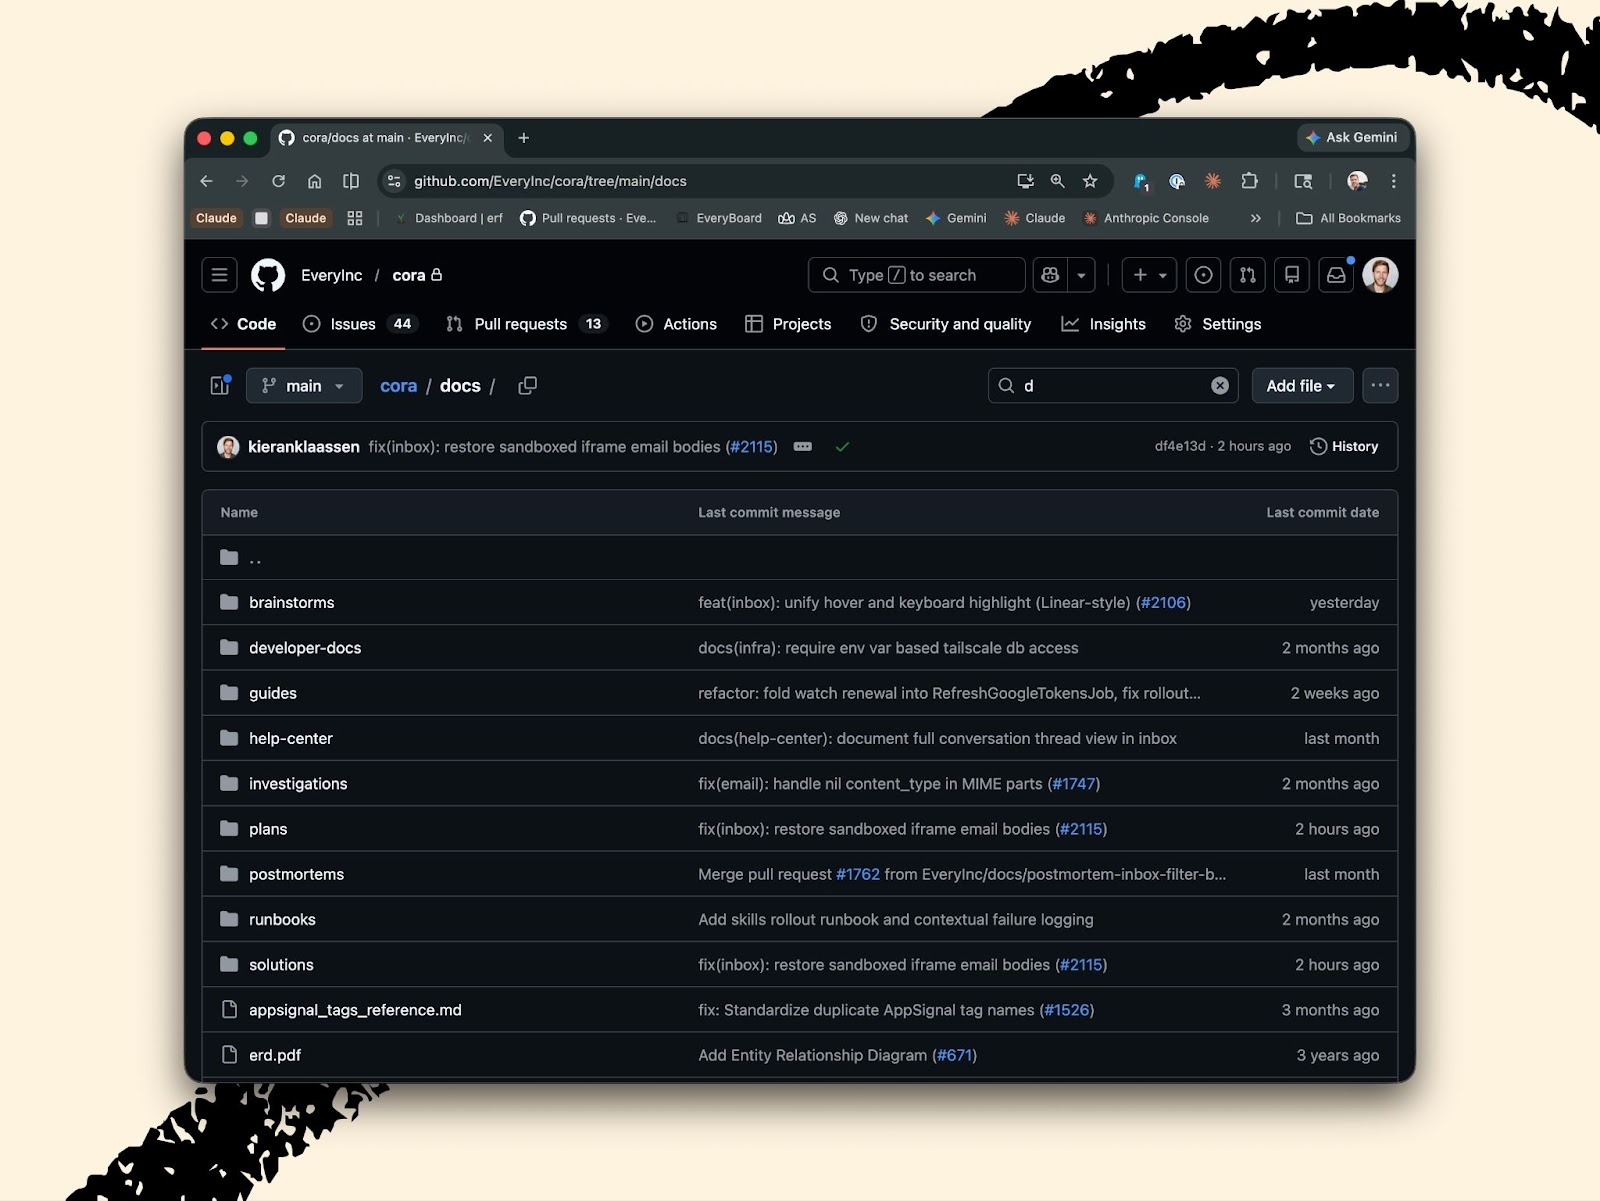 我的 Cora 仓库是一个活着的记忆系统:约定、运行手册和专门智能体层层叠加,任何新模型都能立刻继承 Cora 的思考与运作方式。(图片由 Kieran Klaassen 提供。)
~/cora-agent/ 是另一个文件夹,一个完全不同的智能体,尽管运行在同一模型上。(我主要使用 Opus 4.6,但也喜欢 GPT 5.4 和 Gemini Pro 3.1。)
如果说 ~/cora/ 构建功能,那么 ~/cora-agent/ 就运行整个系统。它没有任何应用代码,因此在做运维工作时不会误改生产代码。取而代之的是,它拥有一组技能:
- 查询 AppSignal,检查 Cora 生产系统上的错误和性能问题
- 跟踪 Render 日志,实时查看服务器输出并捕获问题
- 从 Postgres 只读副本(Cora 数据库的一个副本)拉取数据,以便在不影响线上版本的情况下查询用户数据
- 阅读 Intercom 工单,把客户投诉与技术问题关联起来
- 将 GitHub 部署与生产事故关联起来,把一次故障追踪到具体的代码变更
.claude/skills/ 目录就是一个驾驶舱——一个智能体可以查看并交互 Cora 依赖的每个系统的单一场所。Cora 触达的每个外部系统都有一个参考文件,精确告诉智能体如何与它对话。它的 bin/ 目录里运行着持续不断的 Ruby 守护进程(daemon,后台进程):一个调度器、一个自动分诊新问题的收件箱处理器,以及一个重启卡死进程的健康监控器。三份事后复盘报告存放在 docs/postmortems/ 里。一份密集的部署日志涵盖了从三月到四月 Cora 的每一个拉取请求。
只需要改变文件夹而不是改变模型,我就得到了一个不同的智能体。把 Opus 指向 ~/cora/,它是一名 Rails 工程师;把它指向 ~/cora-agent/,它就是一名了解事故历史、服务拓扑以及该通知哪个 Slack 频道的运维工程师。
与 44 个智能体共度的早晨
一旦你意识到“文件夹就是智能体”,你想运行多少就能运行多少。我有少数几个专门文件夹,但任何时候都有 44 个智能体在它们之间运行——几个在 ~/cora/ 内同时处理不同任务,另一些在 ~/cora-agent/ 里监控生产,还有一些在处理编排。相同的文件夹,只是在并行执行不同的工作。
显然的问题是:谁来管理这 44 个智能体?
几个月来,答案是手动管理。我要打开一个终端标签页,导航到一个项目文件夹,启动一个 Claude Code 会话,给它一个任务,再打开另一个标签页,再来一遍。我就是调度层——追踪哪个智能体在做什么、哪些任务已完成、哪些卡住了。当只有 5 个智能体时,这还能运作。到 10 个时,我开始忘记什么在什么地方运行。到 44 个时,就已经不可持续了:明明知道很容易修的错误放了几天没人动,拉取请求的审查也堆积如山。
于是我构建了一个调度层:一个位于所有文件夹之上、在它们之间路由工作的系统。有一个 Ruby 守护进程监视一个目录,等待生成请求。当我要求它编排一个任务时,它会创建一个主智能体,主智能体把任务拆解成子任务,并分别写成一个文件;守护进程拾取这些文件,在正确的文件夹中生成工作智能体。工作智能体通过写文件来回报状态。守护进程每 60 秒检查一次状态。这里不需要自定义网络或智能体间通信协议。
结果,我从手动切换终端标签页,变成了从一个地方管理整个工程面。我通过 Claude Code 中的斜杠命令与调度层交互。其中两个命令承担了大部分工作:
替代 20 个终端标签页的两个命令
晨间简报(morning briefing):在 Claude Code 中输入 /hey,获得一份状态报告。系统会针对每个项目检查:什么已完成、什么出错了、什么被阻塞了,以及是否有新的高优先级问题。只用一个命令,就能得到一张完整的图景——Cora 主代码库、运维环境和编排系统里,哪些事情需要我关注。
启动任务(kickoff):输入 /orchestrate 来启动一个任务,例如 /orchestrate “修复 GitHub issue #1765”。系统创建一个主智能体,它拆解任务并在正确的文件夹中生成工作智能体。每个工作智能体继承该文件夹的全部上下文——包括它的 CLAUDE.md、专门智能体和积累的知识。工作智能体干活,一个拉取请求出现,我来审查。
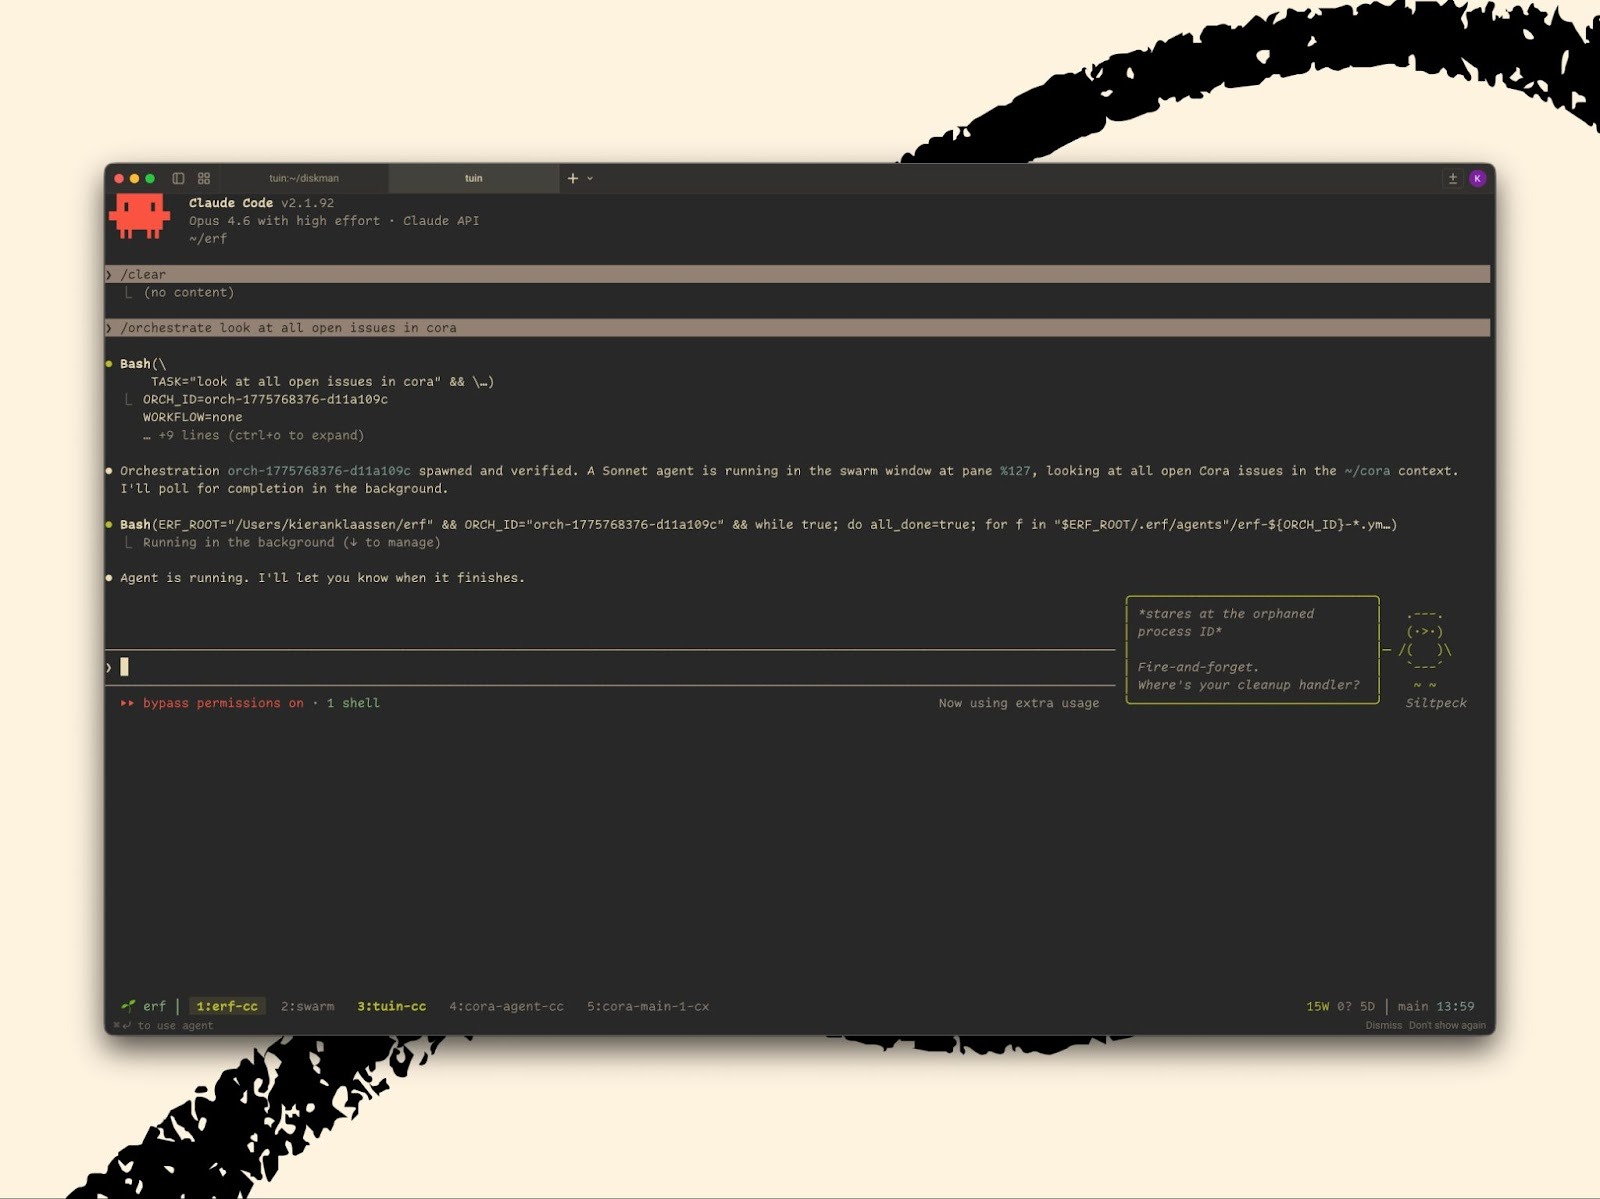 通过 /orchestrate 命令,主智能体将任务委派给跨上下文的专门工作智能体,你可以看到整个系统并行思考。
每个智能体都拥有一个面板,我可以在 tmux(一种同时运行多个会话的终端工具)里实时观看。一块仪表盘显示一个名为“智能体树”(agent tree)的实时地图,展示每个智能体及其状态——工作中、等待中、已完成或出错。拉取请求和 GitHub issue 评论会异步抵达,供我审阅。我可以等自己准备好了再处理结果,而不必在智能体完成任务时立刻处理。
整套系统运行在一个基于文件消息传递的 Ruby 守护进程上。调度层并不是复杂的基础设施。复杂之处在它下面的文件夹——每一个都是通过数月从工作中学习而构建的专家。
Anthropic 自己的研究支持了这种模式为什么有效:在研究任务上,Opus 主智能体配合 Sonnet 子智能体,比单个 Opus 智能体的表现高出 90%。但该研究也发现,多智能体系统消耗的 token 是单智能体配置的 15 倍;而且大多数编码任务的可并行步骤比研究任务少,这让它们更难以在多个智能体之间拆分。调度层不会取代我——它处理的是跟踪工作,因此我仍然决定做什么工作、工作流向哪里。
什么会在规模变大时出错(以及为什么你无法凭感觉编排)
上面那个早晨流程听起来很顺畅,但现实并非总是如此。
编码格式 bug 是我最喜欢的“灾难”。连续几周,智能体在任务中途随机崩溃,错误信息也没有任何有用的解释。我翻遍日志、检查 API 响应、测试网络配置。真正的罪魁祸首竟然是 em 破折号(em dash)和弯引号——那些我复制粘贴进提示词里的文本中的特殊字符。我的守护进程运行的是 US-ASCII 编码,这种编码只识别纯英文字母,所以这些特殊字符把整个进程搞崩了。AI 辅助开发的前沿地带充满了这类问题:看起来真的非常蠢,找起来却惊人地难。
更棘手的长期挑战是上下文漂移(context drift)。几十个智能体运行时,一些智能体最终在执行某个任务的过时版本,或者重复另一个智能体已经完成的工作。活跃智能体的列表越来越长,但清理必须由我手动完成。我目前还没有好的自动化方案——只能定期修剪,接受一些 token 被浪费。
这个架构还带来一个隐蔽问题:智能体停滞(agent stalls)。当某个智能体过快调用太多 API,或卡在等待输入上,它的状态会永远停在“工作中”。你只有在检查时才会发现,而当你管理 44 个智能体时,你并不会总去检查。
这些失败共同指向我学到的最重要一课:你不能凭感觉编排(vibe orchestrate)。
就像你不能凭感觉写代码(vibe code)——动手前需要先做计划——你也不能在线上出问题时凭感觉修复。同理,你无法把一个文件夹丢给调度层就指望万事大吉。当我开始一个新项目时,我不会立刻把它交给调度层。我会先搭建文件夹,构建智能体,建立流程——也就是复合工程循环——并且自己先用到这些流程变得可预测。只有当我相信一个流程之后,才会把它交给调度层,不再盯着它看。如果跳过这一步,你会有智能体为已经完成的工作去开拉取请求,还会提交重复的问题单。工作顺序是关键:先构建,再使用,然后信任,最后才编排。
你的文件夹已经是一个智能体
我整个实验开始时,目标是想构建一个集群(swarm)。我最终得到的是 44 个文件夹,每一个都带着数月工作积累的专门上下文,由一个调度层连接起来。
这不是我预想的结果,但它有效。而你也已经拥有创造同样东西的积木。
如果你的项目里有 CLAUDE.md,以及 .claude/ 目录里的一些文件,那么你已经有一个智能体了。你只是还没有把它当成智能体来对待。
给你一个实验:看看你的项目文件夹。它是一个通用配置,还是一个专家?如果它是通用的——如果你的 CLAUDE.md 只是从别人博客文章里复制来的样板——那就花 30 分钟让它变成你自己的。加入你的约定、你的模式、你对代码应该怎么写的观点。然后,尝试在独立的 git worktree(代码库的独立副本,互不干扰)中运行两个智能体,注意看看是哪里在由你拖慢进度。那里就是调度层需要介入的地方。
我自己也正走在这条路上。我已经从手动编排——打开终端标签页、导航到文件夹、启动会话——转变为让调度层替我做路由。
再下一步也已经到来。Anthropic 刚刚推出了 Claude Managed Agents——一项托管服务,负责沙箱、状态管理和工具执行,让开发者可以专注于“智能体做什么”,而不是“如何让它一直跑着”。文件夹即智能体的模式,使这种托管式自主成为可能:一个受信任的、专门化的环境,模型可以在其中运行,而不需要我时刻握着它的手。
整个行业正在投入大量精力建设自主集群。我也在那里花了三个月,然后发现:至少就目前而言,答案仍然只是一个文件夹。
延伸阅读
Kieran Klaassen 是 Every 邮件产品 Cora 的总经理。你可以在 X(推特)上关注他:@kieranklaassen,或通过 LinkedIn 联系他。
感谢 Katie Parrott 的编辑支持。
核心启示:真正高效的“多智能体系统”,关键不在于复杂的编排协议或自主协作,而在于先花时间把单一文件夹打造成一个长期积累的专业上下文。智能体的能力来自文件夹中累积的约定、知识和技能,而不是来自模型本身。管理的秘诀也在于此:先构建,再使用,然后信任,最后才编排。
《The Folder Is the Agent》的发芽报告
材料核心
Kieran Klaassen 花了三个月想让 AI 智能体“蜂群”协作起来,最后发现真正的智能体不是模型,而是“文件夹”:一个积累了大量项目记忆、CLAUDE.md、skills、runbooks 和 postmortems 的上下文容器。用这个模式,他稳定运行着 44 个 agent,并用一层文件消息驱动的 Ruby dispatch layer 接管了“谁在做什么”的追踪,而不是接管“该做什么”的判断。
发芽 01:模型之外的那叠文件,才是智能体活过的记忆
种子
Kieran 的转折点是:他不再问“如何让多个 agent 互相协调”,而是问“一个模型为什么能在这个项目里成为专家?”答案不是模型本身,而是模型被放进了一个已经积累了大量专有上下文的文件夹。他说得很直接:这些上下文让“通用模型”变成“特定领域的专家”。
这重新定义了智能体:智能体不是“模型 + 工具”,而是“模型 + 一段有历史的环境”。
故事
1998 年,哲学家 Andy Clark 和 David Chalmers 发表了著名的《The Extended Mind》。他们设计了一个思想实验:Otto 因记忆受损,习惯把重要信息写进笔记本;Inga 则用生物记忆记路。当 Otto 靠笔记本找到博物馆时,Clark 和 Chalmers 说:笔记本不是 Otto 的辅助工具,而是他认知系统的一部分。记忆不是只存在于脑子里,也可以存在于一个经过长期维护的外部载体中。
Kieran 的 ~/cora/ 文件夹就是这个“Otto 的笔记本”。里面有 Rails 约定、部署流程、数据库模式、架构文档、真实事故 runbooks,甚至还有他几个月打磨出来的专职 agent。任何一个新模型进入这个文件夹,都会自动继承“Cora 怎么思考、怎么运作”这件事。
这也能解释 Anthropic 自己的研究结果:一个 Opus 主 agent 带 Sonnet 子 agent,在任务表现上比单个 Opus 高 90%,但 token 消耗多了 15 倍。重点不是“更多模型更强”,而是“主 agent 把任务拆开、放进不同上下文之后,每个子 agent 都成了一个更专注的专家”。
Aha 瞬间
"模型只是算力,文件夹才是记忆。你换掉模型,它还是同一个 agent;你换掉文件夹,它才变成另一个人。"
发芽 02:自动化不会替你思考,只会放大你没能自动化的那部分
种子
Kieran 最诚实的一句话是:“AI agents don’t have a speed limit, but the person managing them still does.” 10 个 agent 同时完成时,他面对的是 10 份没有足够上下文去判断可信度的结果。到 44 个 agent 时,问题不是代码,而是他的注意力。
所以他的 dispatch layer 并不“替他做决定”,而是“替他记住哪些事在进行、哪些事卡住了”。它不是 swarm 幻想里的决策者,而是一块仪表盘。
故事
1983 年,认知工程师 Lisanne Bainbridge 在论文《Ironies of Automation》里提出一个经典悖论:系统越自动化,人类操作员的角色越关键,也越尴尬。因为自动化会把所有可预测的流程接管走,留给人类的恰恰是那些不可预测、难以分门别类的异常。
Kieran 的“encoding bug”就是这个悖论的完美例子:他给 agent 的提示词里,从文本复制进来的 em dash 和 curly quotes,让运行在 US-ASCII 编码下的 daemon 随机崩溃。没有任何复杂的模型问题,只是一个“自动化之后才轮到人类去查”的愚蠢错误。这类问题并不蠢,它恰恰是自动化系统的自然产物:你以为已经把系统交给机器了,实际上只是把机器应付不了的那一小块留给了自己。
这也回应了他的另一句话:“You can’t vibe orchestrate.” 你不能凭感觉把任务扔给一群 agent,然后希望它们自己搞定。Kieran 不等于被自动化取代;他只是从“手动做每件事”变成了“手动决定哪件事值得做”。
Aha 瞬间
"编排层能帮你记住谁在做什么,但不能帮你判断什么值得做。真正不能被自动化的,不是流程,而是品味。"
发芽 03:先长出信任,再交付给自动化
种子
Kieran 给这套体系规定了明确顺序:Build it, use it, trust it, and then orchestrate it. 他换了个说法:不能“vibe orchestrate”。一个新项目不能直接交给 dispatch layer,必须先建立文件夹、打磨 agent、在自己的使用中让它变得可预测,然后才把它变成“可以放手”的流程。
这里藏着整个模式最容易被忽略的一层:信任不是设定出来的,是长出来的。
故事
Dreyfus 兄弟在 1980 年代提出的技能习得五阶段模型——从新手、进阶初学者、胜任、熟练到专家——讲的是同一个道理。新手靠规则,专家靠“见过的足够多情境”。一个文件夹如果只有从别人博客复制的 CLAUDE.md,它就是一个新手;一个文件夹如果积累了几个月的 deploy journal、事故 runbook、postmortems,它就变成了“熟练者”甚至“专家”。
Kieran 给读者的实验也指向这个方向:“If your CLAUDE.md is boilerplate you copied from someone’s blog post—spend 30 minutes making it yours. Add your conventions, your patterns, your opinions about how code should be written.” 这 30 分钟不是在写文档,而是在把文件夹从一个通用模板变成一个有判断力的个体。
所以 44 个 agent 并不等于 44 个天才。它的真实含义是:Kieran 用几个月时间,把 44 种“已经活过一段工作经验的环境”租给了模型去用。Autonomy 的下一步不是让 agent 学会自己长出信任,而是让人类先在一个文件夹里积累出值得信赖的判断,再把判断外包出去。
Aha 瞬间
"你不能把还没长成的文件夹扔给调度器;你只能把已经学会的文件夹租出去。Build it, use it, trust it, orchestrate it——顺序不能反。"
你的思考空间
- 你当前的项目文件夹里,装的是“你的惯例”,还是“别人博客里的模板”?如果删除所有模型和工具,只留下那个文件夹,它还能让一个新来的人看懂你的系统吗?
- 当 agent 数量从 5 变成 44,真正崩掉的是代码,还是你的注意力?你有没有一个比“多开几个终端标签页”更诚实的瓶颈指标?
- 你的工作流里,哪些环节是“自动化执行”,哪些环节正在悄悄变成“自动化决策”?你能分辨出这两者的区别吗?
- “Build, use, trust, orchestrate” 这一步里,你最常跳过的是哪个环节?跳过后发生了什么?
- 如果“文件夹即智能体”成立,那么团队的 Slack 记录、会议纪要和个人记忆,会不会才是真正还没被整理好的“智能体文件夹”?