为什么应该“克隆”你的同事
Inside Every:丹试图把我们全都克隆成AI
多年来,Every 首席执行官的丹·希珀(Dan Shipper)一直有一个目标:把主编凯特·李(Kate Lee)的编辑判断自动化。数据是现成的——他拥有超过3万条凯特的历史编辑记录——但当时的模型还不够好,无法创造一个接近她水平的文字编辑智能体。
这种情况在 GPT-5.6 发布后发生了改变。现在,我(本文作者)在提交文章之前,会先运行 KateBench——一个基于凯特历史编辑记录进行文字编辑的技能。只有在这之后,人工凯特才会审阅稿件,接受、修改或拒绝智能体的建议。Google Docs 中的修订记录会记录这些决策,以及她做出的任何其他编辑,然后 Codex 会重写这个技能,使其不断累积改进。(想了解 KateBench 的更多运作方式,可阅读工作人员凯蒂·帕罗特(Katie Parrott)这篇文章,了解工程师雅尼克·荣格(Jannik Jung)如何整合反馈来提升其表现。)
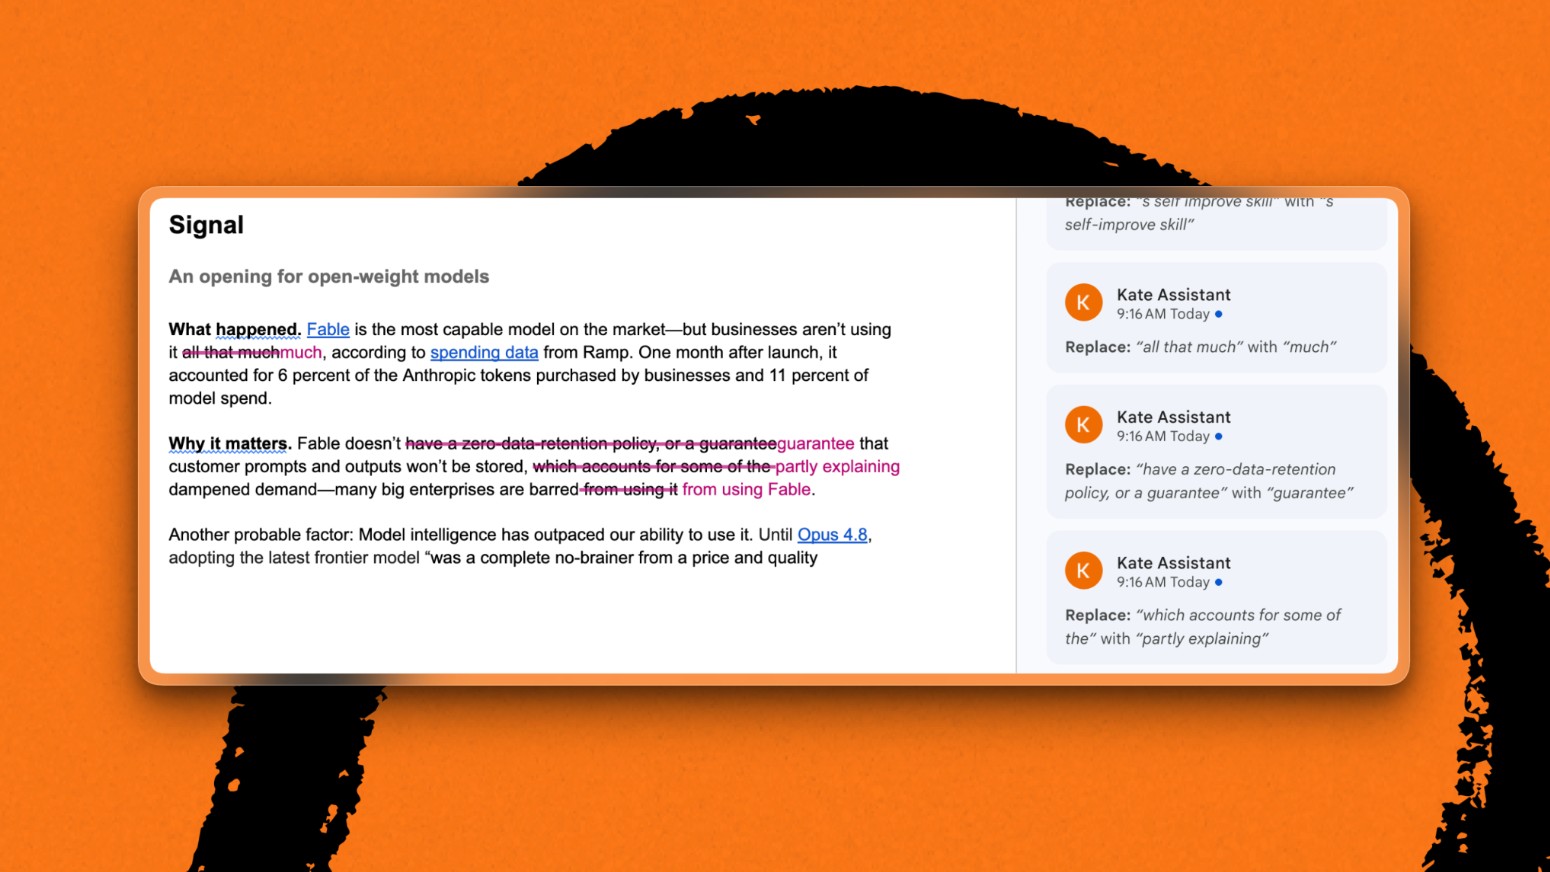 Kate编辑智能体直接在 Google Docs 中提出修改建议。(所有截图由作者提供。)
KateBench 减轻了凯特的工作负担,也让她的专长民主化——团队中任何人都可以对自己写的内容获得凯特级别的质量检查。“要在编辑上达到那种水平,困难程度和专门性都极高,”丹说。“她是唯一能做到这个水准的人,但现在不再是了。”
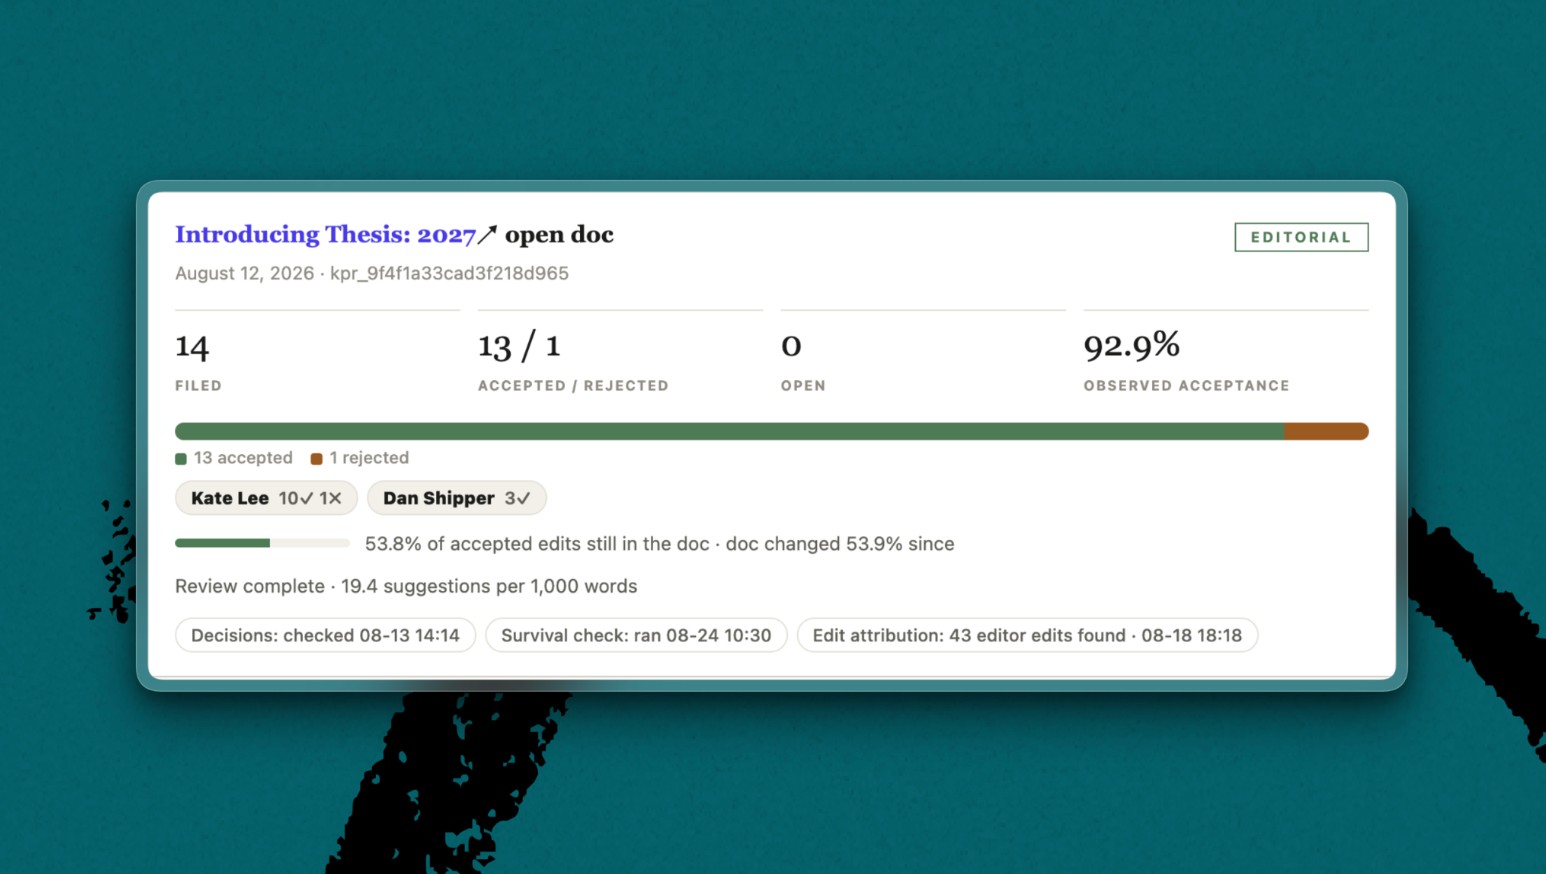 KateBench 通过纳入被接受与被拒绝编辑的数据来自我改进。
显而易见的下一步——至少对丹来说——是为公司里每个人构建一个 KateBench 版本。这样,首席运营官布兰登·盖尔(Brandon Gell)敏锐的用户体验反馈、运营主管阿丽尔·希珀(Arielle Shipper)的运营头脑、社交主管贝基·伊斯瓦拉(Becky Isjwara)对社会脉搏的敏锐把握,都可以被打包并让团队其他人使用。与此同时,布兰登、阿丽尔和贝基可以腾出时间,专注于那些常常被同事请求挤掉的高杠杆项目。
但相比文字编辑,用户体验决策形成的数据集要混乱得多:“未来几个月我们要探索的一大问题是:哪些类型的工作可以这样处理。”丹说。
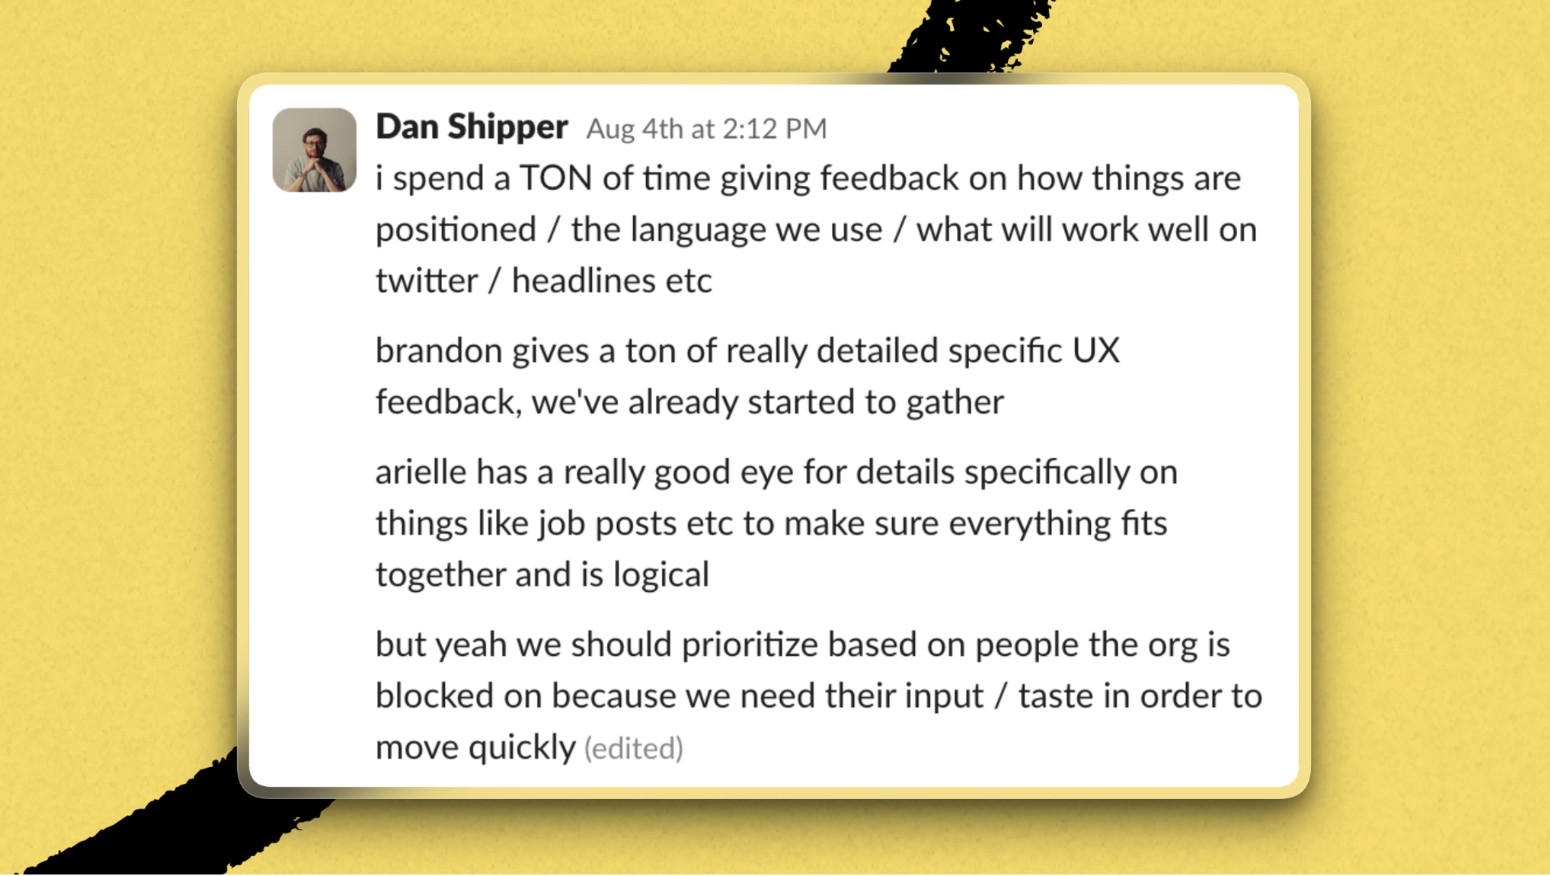 把人们的专长打包成技能,可以为他们腾出时间,并消除瓶颈。
第一个测试对象是迈克·泰勒(Mike Taylor)——他现在是我们的评测实践(evals practice)负责人。他正在构建 DanLens:一个克隆并复合丹的营销直觉和对 Every 客户了解程度的技能,这样团队就能在不挤占丹日程的情况下应用这些洞察。
讨论:署名到底意味着什么?
“AI 是现代生活的事实。人们会用它来协助工作和写作,包括研究、检查语法、编辑等等。”——《华尔街日报》评论版编辑保罗·吉戈特(Paul Gigot)在声明中表示。
周二,亿万富翁投资者斯坦利·德鲁肯米勒(Stanley Druckenmiller)证实,他“当然用了 AI”来撰写他在《华尔街日报》最新的观点专栏,该专栏批评了财政部长斯科特·贝森特(Scott Bessent)的债券回购计划。
“我英语是 B 等生,但经济学是 A+,”他告诉《华尔街日报》。“这些是我的想法,我已经谈论了超过15年,任何认识我的人都知道这一点。我是否希望自己是一位伟大的作家?是的,但我不是。”
与其他媒体机构形成对比的是,《金融时报》已公开禁止其专栏作家使用 AI;而《华尔街日报》则为德鲁肯米勒进行了辩护。“我们的问题是:我们发表的来稿是否反映了作者的原創论点,以及作者是否有立场和信誉来提出这些论点,”吉戈特的声明继续写道。“就斯坦·德鲁肯米勒而言,我们与他有着多年的关系,没有人能怀疑他的专栏文章是他的真实观点。”
整个事件在 X 上引发了一场小范围的风暴:署名究竟是在认证作者身份,还是仅仅代表对一个观点的所有?对迈克来说,重要的是想法本身是否足够好,而不是它是否由 AI 撰写。
如果禁止像德鲁肯米勒这样有经验和专业知识的人使用大语言模型,“我们可能根本看不到那篇文章,那么我们就不知道他在想什么,”他说。“太多有趣的事情,恰恰发生在那些不擅长写作的人身上。”
技能分享:让 Codex 的使用不断进化
如今,阿丽尔几乎只在 Codex 中工作。每当智能体出错时,她会做两件事:1)立即修复当前问题;2)通过一个自定义的 self-improve 技能防止问题再次发生。
每当 Codex 返回错误结果时,阿丽尔会向 Codex 提供反馈,指出它哪里不足,以及更好的回应应该是什么。在它获得所有必要上下文后,她运行这个技能——技能会审查最初的输出,深入探究问题出在哪里,并建议对 Codex 的指令进行有针对性的修改,从而降低问题再次出现的概率。
例如,如果 Codex 起草了一条听起来不像阿丽尔的 Slack 消息,self-improve 技能可能会建议更新 Codex 的操作规则:
在编写或发送 Slack 消息之前,始终阅读线程或 DM 中先前消息的上下文,以便回复能够结合上下文,并承认之前的内容。
她把这些失误当作回流给智能体的数据:“为什么这没用?这能教会我关于使用这些工具的什么?”
你可以下载阿丽尔的 self-improve 技能,在自己的 Codex 设置中构建同样的反馈回路。
论点集(Thesis Statements):来自前沿的七个新预测
上周,我们推出了 Thesis Statements——一个汇集了建设者和思想家对“AI时代人类优质工作的未来”提出的具体、可争议主张的专栏。
今天,我们又带来了七位前沿实践者的新预测:
- 要与 AI 合作,我们将长出新的感官——爱丽丝·阿尔布雷希特(Alice Albrecht),AI 研究员、创始人
- AI 革命将比任何人预测的都要漫长得多——加根·比雅尼(Gagan Biyani),Maven 联合创始人兼 CEO
- 最好的企业将用 AI 彻底革新公司,而不是自动化它们——萨姆·格斯特南(Sam Gerstenzang),Boulton and Watt 合伙人
- 最好的领导者将专注于不可预测之人的混乱工作——基特·克鲁格曼(Kit Krugman),Altana 首席人力官
- 离线设备将相当于给大脑去健身房——克雷格·莫德(Craig Mod),作家、摄影师
- 你的 AI 工具会感觉像身体的一部分——中岛洋平(Yohei Nakajima),Untapped Capital 联合创始人兼普通合伙人
- 最小可行产品将是面向一个人——甚至一个智能体——马特·范·霍恩(Matt Van Horn),June CEO 兼联合创始人
如果你想帮助这些想法从论点走向行动,欢迎参加我们于 2026 年 11 月 5 日举办的首届 Thesis: 2027 大会。
信号:开放权重模型的窗口
发生了什么: 一种流行的叙事正在形成——在许多任务上,模型智能的提升已经出现了边际收益递减。最典型的例子是:Fable(Anthropic 当前最强模型)是市场上最强大的模型,但根据 Ramp 的支出数据,企业并没有大量使用它。发布一个月后,Fable 仅占企业购买的 Anthropic token 的 6%,占模型支出的 11%。
为什么重要: Fable 不能保证客户的提示和输出不会被存储。由于这一安全风险,许多大型企业被限制使用 Fable,这在一定程度上解释了需求的低迷。
另一个可能的因素:模型智能已经超过了我们使用它的能力。采用最新的前沿模型“从价格和质量角度看完全不需要犹豫”,迈克说——直到 Opus 4.8 的出现。按完整的 API 费率计算,每小时 70 美元的 Fable 打破了这一趋势。
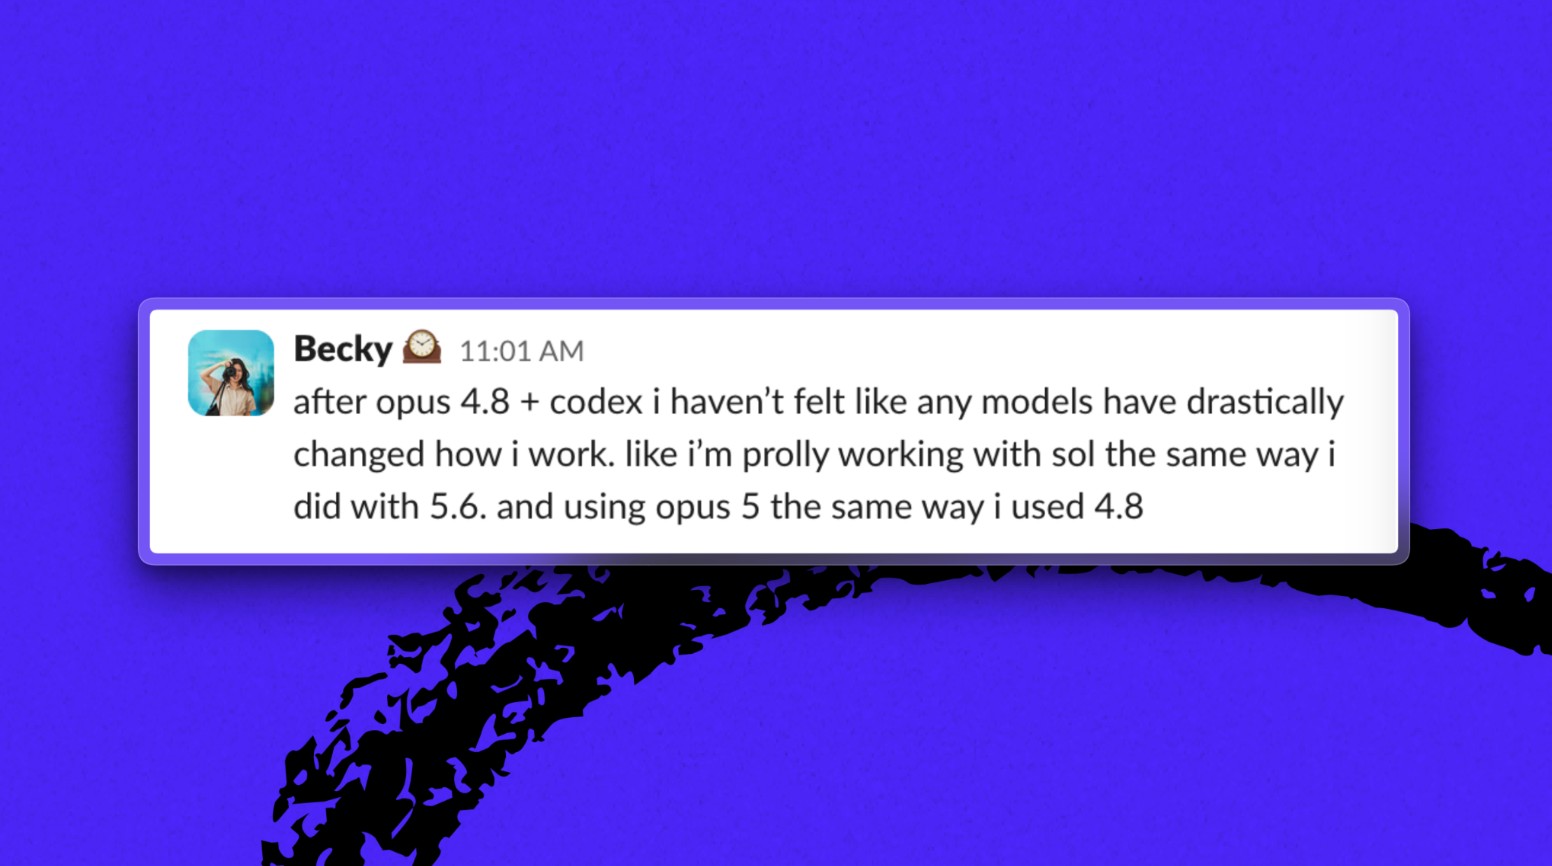 最近的模型发布并没有从根本上改变贝基的工作方式。
Fable 仍然是雄心勃勃项目的首选——丹上周末就用了它来构建一个端到端应用,让远程智能体可以自主控制他的电脑。但他大部分工作所需的智能水平远没有那么高。“在 80% 的知识工作任务上,我并没有从 Fable 那里获得相对收益——它更慢、更贵,却没有更好。”他说。
这意味着什么: 这为开放权重模型创造了机会。6 月份,通过 Vercel 的 AI Gateway 路由的 token 中,开放权重模型处理了 29%,高于 4 月份的 11%。但这一流量仅占支出的不到 4%,表明企业已经在把高量任务路由到更便宜的模型。
如果大多数人并不需要前沿能力,开放权重 AI 开发者就可以专注于训练一个称职、用户友好的模型,“人们会开始使用它,因为它将比 Fable 便宜 90%。”迈克说。
AI & I:走进要求 AI 熟练度的 100 亿美元对冲基金
对冲基金靠优势而生,也靠优势而死。AI 提供了一种优势,因此在管理规模达 100 亿美元的对冲基金 Walleye Capital,其全部 400 名员工都被要求使用 AI。
在本期 AI & I 中,我们重温了与该基金首席执行官兼首席投资官威尔·英格兰(Will England)的对话。作为 AI 最大化主义者,英格兰预见到这项技术将吸收操作性任务,把知识工作者解放出来,去关注更宏观、往往更抽象的问题和决策。
可在 X 或 YouTube 观看,或在 Spotify 和 Apple Podcasts 收听,也可以阅读文字记录。
本期要点:
英格兰从 GPT-3 时代起就想自动化自己的工作。 早在 2023 年 3 月,英格兰看到一名分析师演示:AI 如何让他更快完成更多工作。从那一刻起,英格兰知道 AI 将从根本重塑所有“以思考为生”者的工作方式,从他自己开始。“如果你有一个工具让你更高效,那就等于雇了一个人来替代你正在做的部分工作,这样你就可以继续推进下一个任务,”他说。“你的上下文层级会随之上升。”
他认为 AI 是不可商榷的。 回避 AI,就像 1995 年因为互联网不够完美而拒绝使用它一样。“那太蠢了,我无法理解,”他说。“作为对冲基金,忽视那些让我们更快、更聪明、更高效的工具,把钱留在桌上,我们应该为此感到羞愧。”而随着模型的改进,这堆钱会不断复利增长。
结果 > 努力。 英格兰发过一封全公司邮件,开头写道:“我用 ChatGPT 写了这封邮件,你们也应该用,并且要为此自豪。”他更大的观点是:AI 加快并简化了许多必要任务,让他能够专注于风险评估、数据策略,以及其他影响基金业绩的大局问题。“人们会有一种不安全感:如果我没有倾注心血和汗水,那它就不是真的,”他说。“但归根结底,结果才是最重要的。”
错过剧集了?可以回顾丹近期的对话:Anthropic 产品负责人迈克·克里格(Mike Krieger);构建 Claude Code 的团队凯特·吴(Cat Wu)和鲍里斯·切尔尼(Boris Cherny);构建 Codex 的团队蒂博·索蒂奥(Thibault Sottiaux)和安德鲁·安布罗西诺(Andrew Ambrosino);Vercel 联合创始人吉列尔莫·劳赫(Guillermo Rauch);播客主持人德瓦凯什·帕特尔(Dwarkesh Patel),以及其他嘉宾,了解他们如何用 AI 思考、创作和联结。——米里亚姆·帕丁顿(Miriam Partington)
每日主力:团队本周使用的模型
- 安德烈·加尔科(Andrey Galko),工程负责人:快速任务用 GPT-5.6 Sol,其他一切用 Opus 5。“它在 extra-high/max 推理模式下相当可靠,而且在用量限制内花费少得多。”
- 贝基·伊斯瓦拉,社交主管:策略和社交分析用 Opus 5 和 GPT-5.6 Sol(high),Sol 会将任务委派给 Terra。最近,她把更多工作切回了 Opus 5。“我发现 GPT-5.6 Sol 变得有点啰嗦和慢了。”
- 泰勒·尼西达(Tyler Nishida),工程师:大部分事情用 Grok 4.6,因为他觉得它在执行力和成本之间取得了最佳平衡。“当 Grok 4.6 犯糊涂时,无头模式(headless mode)下的 Fable 和 GPT-5.6 Sol 足以救我。”
- 阿丽尔:大多数任务用 GPT-5.6 Sol(medium),遇到更多分析性工作时切换到 high。
- 丹:正在测试 Anthropic 和 OpenAI 尚未发布的模型,同时使用 Fable 和 GPT-5.6 Sol。
- 威利·威廉姆斯(Willie Williams),平台负责人:Fable、GPT-5.6 Sol(extra-high 和 medium)与 Grok 4.6 的混合使用。
核心启示:当一个团队把资深成员的专业判断封装成可持续迭代的 AI 技能(如 KateBench),专家能力就从个人垄断变成了组织资产——既减轻了专家的重复劳动,也让稀缺的经验质量普惠所有人。
《The Case for Cloning Your Coworkers》的发芽报告
材料核心
Every 用一个真实实验正面提出“克隆同事”的命题:把资深员工的隐性判断——Kate 的编辑力、Dan 的营销直觉、Brandon 的 UX 眼光——变成可复用的 AI“技能”,让团队获得顶级员工的水平,同时让本人集中到更高杠杆的事上。Druckenmiller 用 AI 写专栏、Walleye Capital 强制全员使用 AI 等案例,则把问题从“工具会不会取代写作”推向“署名真正担保的是什么”。
发芽 01:从“只有她会”到“谁都能用”:判断力正在变成复利资产
种子
KateBench 真正值得注意的不是“AI 会改文章”,而是“Kate 的改法可以被累积”。Dan 有超过 30,000 条历史编辑记录;GPT-5.6 让模型第一次够好,可以把这些记录变成可运行的技能。更关键的是,Kate 每次接受、修改或拒绝 AI 建议,都会变成新的数据,由 Codex 回写进技能。这个闭环让“Kate 的判断”不再是一次性劳务,而是一项会复利的组织资产。
故事
Michael Polanyi 在《The Tacit Dimension》(1966)里提出“我们知道的比能说出来的多”。Kate 的编辑判断正是这样:她大概没法写出 30,000 条编辑规则,但她的修改痕迹可以作为行为数据。Nonaka 与 Takeuchi 在《The Knowledge-Creating Company》(1995)中提出 SECI 模型,认为组织知识创造的关键是把隐性知识“外化”成显性知识。传统做法是写手册、录课程、做分享,而 KateBench 把“外化”变成了一条几乎自动的反馈流水线:“人审阅 -> AI 自我改进 -> 下一次生成”。这比传统知识管理更接近“组织肌肉记忆”。
这也回应了原文后面 Signal 部分的观察:Fable 很强,但一个月后只占企业购买 Anthropic tokens 的 6%、模型支出的 11%;Dan 说他在 80% 的知识工作上从 Fable 得不到相对收益。真正稀缺的不是更强的模型,而是 KateBench 这种把判断封装起来、还能持续复利的反馈基础设施。
Aha 瞬间
“任何一个能被 30,000 个例子和一套反馈闭环封装起来的能力,都不再只是某个人的天赋,而是公司的资产负债表上可以复利增长的知识资本。”
发芽 02:署名是句子的所有权,还是想法的所有权?
种子
Druckenmiller 承认用 AI 写 WSJ 专栏引发的争议,可以浓缩成一个问题:AI 参与的写作,还算不算“他的文章”?WSJ 的答案偏向于“只要反映了作者的 original argument、作者有立场和公信力就算”;Mike 则更激进:如果禁止“不能写但能想”的人用 AI,“我们可能就不知道他到底怎么想”。
故事
代笔问题比 AI 早得多。普利策奖历史上最常被讨论的“署名”案例之一,是约翰·F·肯尼迪的《Profiles in Courage》(1957)。后世传记研究和当事人回忆普遍认为,Ted Sorensen 深度参与了写作或起草;但这本书的署名是肯尼迪,并因此获奖。这里的署名权绑定的是政治判断、公共责任与“这是我愿意为之负责的观点”,而不是逐字逐句的执笔权。AI 时代只是让这种“智力代笔”成本趋近于零,也让每个不善写作的高手都配了一个 Ted Sorensen。
Walleye Capital 的 Will England 把同一逻辑搬进公司:他在全员邮件里说“我用 ChatGPT 写了这封邮件,你们也应该用,并为此自豪”。他要打破的正是“必须由我亲手写才算数”的执念。用 Druckenmiller 的话说:“这些是我的想法,我已经讲了 15 年。我希望自己是好作家,但那不是真正的我。”
Aha 瞬间
“AI 没有消灭作者,它把‘作者’重新定义为‘对想法负责的人’,而不是‘对句子负责的人’。”
发芽 03:可克隆的边界:新泰勒制,还是反泰勒制?
种子
Dan 在文中留了一句很关键的话:UX 决定比 copyedits 更难处理。为什么?因为 KateBench 的成功依赖一个条件:判断结果可以被明确判定为“接受/修改/拒绝”。但 Brandon 的 UX 反馈、Arielle 的运营脑、Becky 的社交定位,往往是对模糊情境的品味与取舍。问题不是“AI 能不能复制专家”,而是“专家的哪些判断本质上可复制,哪些不可复制”。
故事
20 世纪初,Frederick Winslow Taylor 在 Bethlehem Steel 用时间-运动研究把工人的铲装动作标准化,创立“科学管理”。Harry Braverman 在《Labor and Monopoly Capital》(1974)中批判,这种做法把“手艺人”变成了“可替换的执行者”,判断力被转移到管理者和流程身上。KateBench 看起来像一种“新泰勒制”:用历史数据提取专家的判断规则。但它也可以走向反面——如果反馈闭环足够好,专家不必再做重复性劳动,就可以把注意力放到更复杂、更模糊、更不可能被编码的问题上。文章里的“Kate 只需要 review AI 的建议”正是这个方向。
真正的风险在于:如果 AI 把“过去的 Kate”固化成标准,而 Kate 不再做大量日常编辑,那么未来训练数据从哪里来?一个永远只能复刻 2026 年 Kate 的技能,会不会反过来阻止 Kate 成长为 2030 年的 Kate?
Aha 瞬间
“最容易被克隆的,是已经被准确评估过的过去;最值得保护的,是尚未被评估、甚至无法被评估的新判断。”
你的思考空间
- 如果你也被同事克隆成一个 AI 技能,你最希望他们复制的是你的“决策规则”,还是你的“决策理由”?
- KateBench 依赖 Kate 对 AI 建议的接受/拒绝来改进;但专家说“不”的时候,AI 能分辨那是因为风格、语境、还是价值观吗?
- Druckenmiller 的专栏经 AI 重写后更清晰,它还算“他的文章”吗?如果算,“作者”这个词究竟还剩下什么?
- 当所有人都能调用 CEO 的营销判断时,这种“判断的民主化”会不会反而让组织里的不同判断变得同质化?
- “克隆同事”的理想终点,是每个人都不需要再问同事问题,还是每个人都能提出更好的问题?