基准测试不了解你的工作
原文:https://every.to/context-window/benchmarks-don-t-know-your-job
人工智能面临一个测量问题。企业知道自己为模型花了多少钱,也知道这些模型在公共基准测试上的得分。但它们往往不知道的是:模型是否真的帮员工节省了时间,是否产出了人们无需复核就能信任的工作成果。本期 Context Window 探讨的是企业如何自行回答这些问题:我们解释为什么组织需要围绕真实工作来构建测试,展示克隆我们主编这件事让 Every 在评估(evals)上学到了什么,并介绍帮助 Every 工程师判断家里能否开烘干机的六代理团队。
信号
氛围感无法规模化
假设你的公司每年在人工智能上花费 1 亿美元。你知道自己付了多少钱,也知道你所付费的模型在公共排行榜上的位置。但你仍然可能完全不知道,它们是否在完成你花钱让它们做的工作,或者一个更便宜的模型是否能同样胜任。这种花钱方式很奇怪。
Mercor 联合创始人兼 CEO Brendan Foody 表示,他遇到的企业高管正处在这种境地:他们每年花费高达 1 亿美元运行模型,却没有任何“离线评估”——即在模型接触真实工作之前,用一套固定的真实任务来测试和比较它们。Box 的 CEO Aaron Levie 引用转发了 Foody 的帖子,写道:“企业不能只靠感觉行事。”
公共基准测试可以告诉你,一个模型在总体上比另一个模型更强。但它们无法告诉你,这个模型是否抓到了你的律师关心的条款,是否保持了你的行文风格,或者是否让员工免去了又一轮检查。一个有用的评估应该从你公司已经在做的工作出发:代表性案例、员工知道要留意的失败模式,以及人类仍需手动修正的工作量统计。
与此同时,可供选择的方案数量正在成倍增长。投资人 Gavin Baker 引用了 Vercel CEO Guillermo Rauch 的一张图表,显示在短短两个月内,前端云平台上开源模型的 Token 份额从 28% 增长到了 62%。Andreessen Horowitz 的本周图表报告称,法律行业从业者对 Codex 的采用率自 2 月以来增长了 108 倍。越来越多的模型在越来越多的工作上已经足够好用。挑选分数最高的那个,已经不再算是一种购买策略。
一个可复用的评估,能给你一套判断模型能否按你想要的方式完成公司工作的工具。对每个候选模型运行同一组任务,衡量留给人类的工作量,然后比较节省下来的成本。你可以测试一个新模型,而不必从零开始,也无需轻信供应商最喜欢的那项得分。
在 Every,我们使用 Vibe Checks 针对团队每天所做的编码、写作和知识型工作任务来测试每个新模型。现在我们要更进一步:构建内部评估体系,让我们能够随时间比较模型的表现,并衡量模型实际做的事与我们期望它做的事之间有多大的差距。KateBench 是一个 AI 文字编辑,基于主编 Kate Lee 过去约 3 万次编辑修改训练而成。它会在 Google 文档中提出修改建议,然后追踪编辑接受了哪些、拒绝了哪些,以及编辑之后又自己改写了哪些内容。评估帮助我们判断模型的判断与 Kate 可能做出的判断有多接近。
本周可以做什么: 选择一项反复出现的工作,比如编制每周报告或制作演示文稿。写下当前模型在五个方面会出错的表现,每个方面配一个示例(一份达到黄金标准的报告或演示文稿),然后拿你正在考虑的模型去运行这些案例。这就是一个评估的开端。比起再花一个下午比较排行榜,这样做能让你更清楚该买什么。
走进 Every
86% 这个数字没有告诉你的事
要使用 KateBench,编辑需要标记 @every 来召唤 Every 代理,要求它进行一轮 Kate 式的文字编辑。代理会直接在 Google 文档中留下修改建议,由编辑决定接受或拒绝。
在最近的几次运行中,编辑接受了大约 85% 到 90% 的建议。Jannik Jung 是负责 KateBench 的工程师,他向我们展示了两个让人怀疑这个数字的理由。这个工具在提交 40 条建议后就会停止工作,所以在长文章中,它可能先找出一条不错的修改,但在编辑看到之前就把它丢掉了。现在这个上限已改为 80。
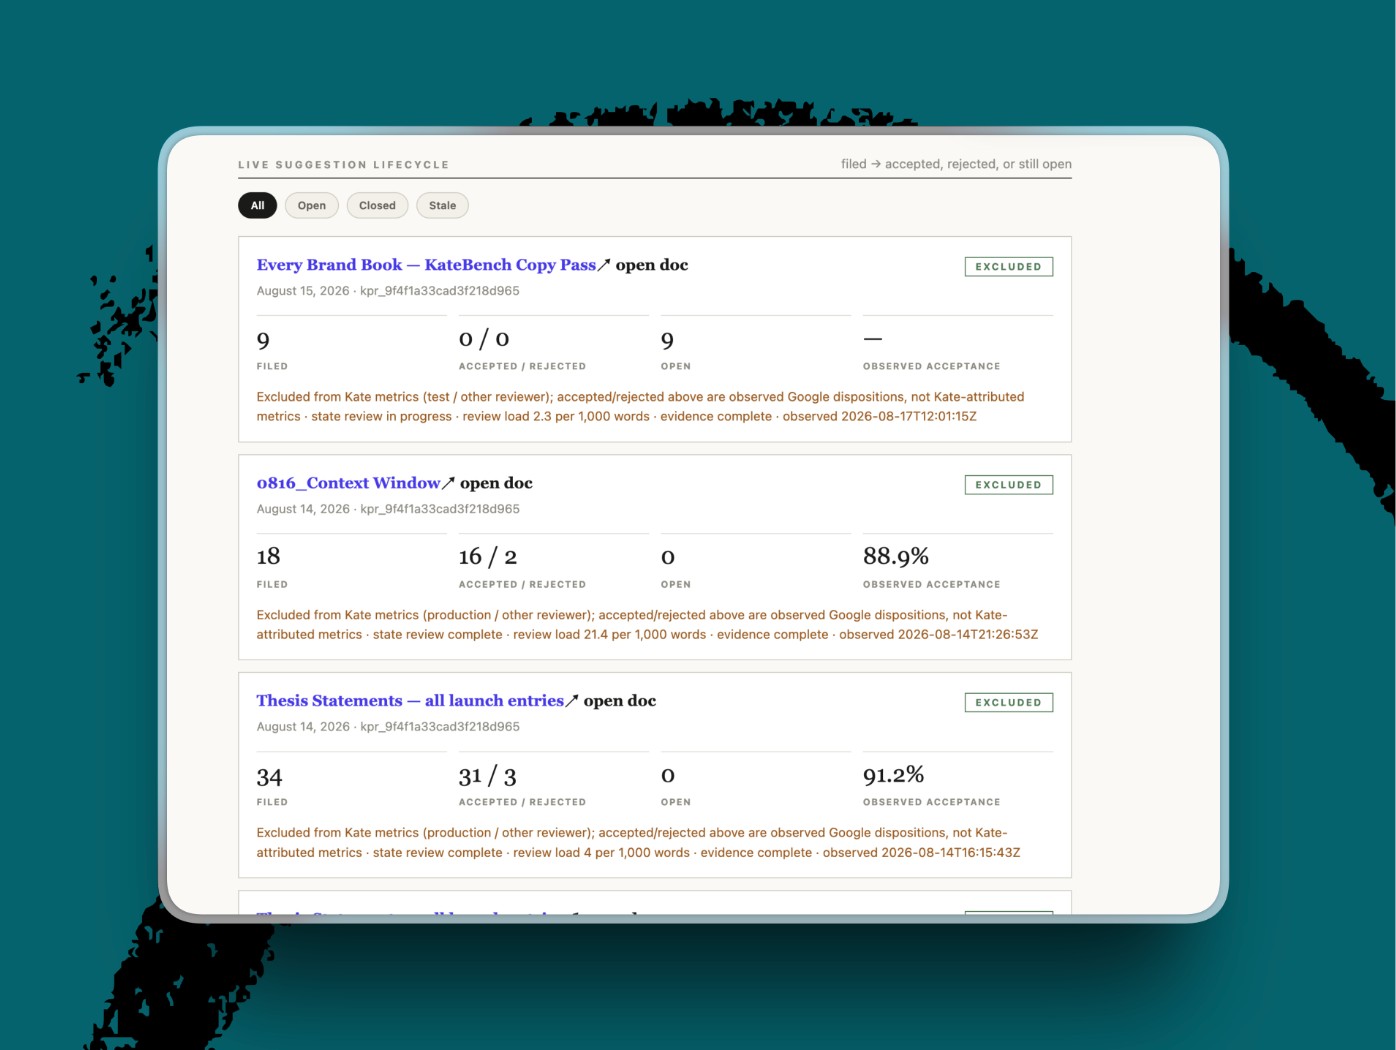
KateBench 还有一个问题:它每次读取同一份文档时,产生的修改并不完全一致。这意味着即使 Jannik 没有改动任何东西,它的接受率也可能上升或下降。一个新的提示词(prompt)可能某一次得分更高,但并不代表它持续更优,所以 Jannik 必须把每个版本运行多次,才能判断它是否真的算一种改进。
值得点击的链接
软件工程师 Steve Yegge加入了关于“沙盒”的讨论——沙盒是用于开发和测试 AI 模型的受控环境。他提出,智能体需要的是“围栏”——即关于每个智能体被允许做什么的明确规则——而不是从外部强加限制的技术壁垒。Cursor 解释了它为什么重建了 Git 托管服务:编码智能体会创建大量短命的仓库。它的新系统把每次代码变更都存储在云端,然后根据智能体的需要创建或丢弃工作副本。Andreessen Horowitz 普通合伙人 Martin Casado认为,Fable 的低市场份额是一个隐私问题:该模型会保留公司发送给它的数据,而且不提供零数据保留选项,这使得它对有严格数据政策的公司来说根本无法采用。CentaurBench 发现,最擅长独立完成任务的模型,并不一定就是最好的助手。在七项任务中的五项里,另一个不同的模型在改进较弱模型的初稿方面表现更好。而 Thinkingbox 发现,最强的编码模型单次尝试通过率为 65%,但当研究人员要求它在连续 20 次尝试中稳定表现时,成功率下降到了 25%。
对立观点
收益递减,怎么衡量?
Olivia Moore,Andreessen Horowitz 的另一位合伙人,周六在 X 上发帖说:“感觉我们在许多任务上的智能提升已经遇到了收益递减。我们可能不会再看到每个产品一发布就自动切换到下一代前沿模型了。”她认为,对于在模型之上构建产品的公司来说,更慢的进步速度反而创造了削减成本的机会。
我们同意的地方: Moore 对许多任务的判断是对的。Mike 表示,Opus 4.8 是 Every 在价格和质量上都没有犹豫就采用的最后一个前沿模型。
我们不同意的地方: “智能的收益递减”这种说法,有可能把当前的任务清单误当成模型未来能力的完整清单。公共基准测试测量的是一组狭窄的能力;它们无法告诉一家公司,某个模型是否在自己所从事的工作上取得了进步。KateBench 就展示了得出错误结论有多容易。它那高企的接受率让这个工具看起来几乎已经完工,但这个数字在一次次完全相同的运行中会发生变化,而且忽略了 Kate 之后仍然需要做的修改。本质上,除非企业构建出能够捕捉那部分残余工作——即智能体完成任务之后人类仍需做的工作——的评估体系,否则它们根本无法判断是进步放缓了,还是它们的测量方式根本没测到进步。
缺失的部分: 构建者仍然缺少一个针对特定任务的工具。他们应该削减成本——同时保持评估持续运行,这样当更便宜的模型在任务上失败时,他们能够及时发现。
最后一件事
烘干机也有了一个代理团队
Every 的设计师 Tyler Nishida 想让他家的离网太阳能系统回答一个问题:有足够的电力来运行烘干机吗?
他家位于夏威夷大岛的一处雨林中,所以天气预报不能套用典型夏威夷阳光的刻板印象。Tyler 用 Grok Bot 将一个 Raspberry Pi——一种信用卡大小的廉价计算机——连接到系统中。现在,他可以通过手机查看电池组电压,监控控制太阳能板向电池输送电量的设备,根据天气预测系统将产生多少能量,并在该启动发电机时收到提醒。
Grok Bot 创建了一个由六个智能体组成的频道来协作完成这套设置。Tyler 看着它们互相发消息。一个智能体告诉另一个智能体他需要买什么;后来,一个智能体通过私信把亚马逊链接发给了 Tyler。
这个团队并没有独自完成所有工作。Tyler 在最后几个步骤中使用了 Grok Build。现在,他家的烘干机有了一支六智能体运营团队。
核心启示:企业无法靠公共基准测试判断模型是否真正胜任自己的工作;只有围绕公司真实工作构建可复用的评估体系,衡量的又是“人类仍需手动修正的残余工作量”这一指标,才能在日益增多的模型选项中做出有依据的采购决策。而 KateBench 的案例表明,高接受率这类表面数字可能具有欺骗性,因为模型输出的非确定性和评估设计的局限性都会扭曲结论。
Benchmarks Don't Know Your Job 的发芽报告
材料核心
本文指出 AI 采购正陷入“测量失灵”:企业每年花数亿美元买模型,却只依赖公开排行榜分数,不知道模型是否真的为自己公司的任务省时、省钱、值得信任。Every 的解法是用真实工作构建“离线 evals”——比如用主编 Kate Lee 的 3 万次编辑训练出的 KateBench 复制编辑——并反驳“智能回报递减”论,认为那更可能是测量工具太窄造成的错觉,而不是智能本身撞上了天花板。
发芽 01:基准是一场奖励游戏,eval 才是工作现场
种子
文章反复强调:公开基准能告诉你哪个模型“普遍更强”,却无法告诉你它有没有抓住法务在意的条款、保持你的 house style,或让员工少一轮检查。这背后的机制比“测量不准”更深一层:基准不是中立的尺子,而是一套奖励系统。一旦某个分数出现在排行榜上,模型厂商就有了针对它优化的动机,分数与真实工作之间的裂缝只会越裂越大。因此,企业搭建 eval 不只是在“选模型”,而是在拒绝被别人的目标函数定义自己的任务。
故事
1975 年,英国央行经济学家 Charles Goodhart 在研究货币政策时提出:当一个测量指标变成目标,它就不再是好的测量指标。1976 年,统计学家 Donald T. Campbell 在对教育测评的评估中得出更悲观的版本:“量化社会指标越被用于社会决策,就越容易受到腐蚀压力,扭曲它本该监测的社会过程。”
这个规律在 AI 时代有了具体的物理表现。2024 年 10 月,Apple 研究者发布 GSM-Symbolic 论文:拿公开数学基准 GSM8K 的题目,仅仅把里面的名字和数字改掉、逻辑完全不变,最强模型的表现最高下降超过 14%;在题面里多加一句与计算无关的叙述,部分模型的准确率暴跌最高达 65%。也就是说,排行榜上的高分里,有相当一部分属于“记住了题的模型”,而不是“会算题的模型”。
这正是文章反对“再花一个下午比较排行榜”的原因。Every 的 KateBench 走的是相反路径:用主编 Kate Lee 过去 3 万次真实编辑做训练,直接把“Kate 会怎么改”变成测试集。目标从论文里的通用能力,换成了“你的公司到底要什么”。
Aha 瞬间
“排行榜分数衡量的是模型有多擅长考试,eval 衡量的是你的工作还剩多少没做完。”
发芽 02:被忽视的成本,是模型离开后人类还要补多少活
种子
整篇文章最容易被跳过的一句话是:“一个有用的 eval 要数一数,人类还得修多少东西。”我们太习惯盯着模型自己的分数,忘了真实成本是“模型输出 + 人类残余劳动”。Every 用 KateBench 的 85–90% 接受率演示了这个陷阱:数字看起来接近完工,但这个分数会变(同一版本每次运行结果不同),而且它没有统计“Kate 在 agent 完成后仍然要做的修改”。高接受率让工具看起来几乎完工,而真正的差距藏在数字之外。
故事
机器翻译行业二十年前就撞上了同一堵墙。2002 年,IBM 的 Kishore Papineni 等人提出 BLEU,用机器译文和参考译文的 n-gram 重合度自动打分,很快成为行业标准。然后大家发现:BLEU 高的译文,人类译者照样要花大量时间修改。行业于是发明了“后编辑工作量”指标,最典型的是 2006 年马里兰大学 Matthew Snover 团队提出的 HTER(Human Translation Edit Rate):不问你译文“好不好”,只问一个人类需要用多少次编辑,才能把机器译文改成可用版本。
HTER 想测量的,就是文章说的“residual work”——agent 完工之后,人类还需要补多少。区别在于:翻译行业花了多年才建立这套指标,而 Every 的答案是更普适的:把你一周里的某个重复性任务(周报、PPT、合同审阅)写成五条失败案例,配一份 gold-standard 范本,让候选模型跑一遍,然后数一数人类还必须修什么。这不是项目管理流程,这是在把“感觉”变成成本函数。
Aha 瞬间
“模型的工作不算完成,直到人类的检查结束;唯一值得付费的分数,是你下班后还剩多少活。”
发芽 03:智能的“高原期”,还是你的测量清单太短?
种子
文章在 Counterpoint 部分接住了 a16z 投资人 Olivia Moore 的判断:“很多任务上我们似乎已经触及智能回报递减,以后产品不一定每次发布都会换新旗舰模型。”Every 的回击很锋利:公共基准只测一组很窄的能力,无法告诉你模型有没有在你自己的任务上变好;在搞清楚“是进步变慢了,还是测量漏掉了”之前,下“回报递减”的结论为时过早。这背后是一个更古老的认知问题:我们太容易把“仪器读不出变化”解读成“世界没有变化”。
故事
1980 年代,质量管理大师 W. Edwards Deming 在他的研讨会和《走出危机》(Out of the Crisis, 1986)中反复演示红珠实验:工人从大量白珠和少量红珠混合的碗里随机取珠,红珠代表“缺陷”。没有人改变任何条件,每天的缺陷数却随机波动;经理们照样奖励低缺陷者、惩罚高缺陷者,仿佛波动等于能力。Deming 的教训是:不理解系统的变异,就会把噪声当成信号。KateBench 简直就是一个红珠碗——模型输出不确定,接受率在两次完全相同的运行之间也会上下浮动,所以 Jannik Jung 每次改完 prompt 都要跑好几遍,才敢说“这次是真的变好了”。
另一个教训来自 Richard Sutton 2019 年的《痛苦的教训》(The Bitter Lesson):70 年 AI 研究里反复出现的模式是,试图把人类知识手工塞进系统的方法,总会在早期看到漂亮成果、然后撞上天花板,最后被“更简单的通用方法 + 更多计算”反超。所谓的智能天花板,常常只是当前任务清单的尽头,而不是能力的尽头。文章自己也埋了证据:Vercel 上开源模型 token 份额两个月从 28% 涨到 62%,法律行业 Codex 采用量 2 月至今增长 108 倍——一条曲线可能在放缓,另一条曲线正在别处爬升。
Aha 瞬间
“当一个模型的分数停止爬升,真正的问题不是‘智能到头了吗’,而是‘你手上的任务清单是不是太短了’。”
你的思考空间
- 如果你们公司最重要的 “benchmark” 改成“员工在 AI 完成之后还要做的编辑量”,这个季度你会买哪个模型,不买哪个?
- KateBench 的接受率在没有任何改动时也会自动波动 5% 上下。在宣布一次模型升级“成功”之前,你需要连续跑几遍才愿意相信那不是噪声?
- 文章说“再花一个下午比较排行榜”是浪费。你手上哪一个每周重复的工作,值得变成第一条、只有五个案例的 eval?
- 当开源模型在 Vercel 上拿到 62% token 份额、法律行业 Codex 用量增长 108 倍,“哪个模型最强”还是对的购买问题吗?还是该问“哪个够便宜的模型已经够好”?
- 如果 Deming 看到今天的 AI 采购流程,他会不会说:你们缺的不是更好的模型,而是缺一张控制图?