我试用了那个专为修复AI写作而生的AI模型
原文:I Tried the AI Model Built to Fix AI Writing,作者:Katie Parrott,发表于 2026-08-24
想象一支翻唱乐队,技术上讲它知道历史上写过的每一首歌,但它只有一套编曲。每首歌的旋律都由同一组和弦构成。无论是翻唱《Landslide》还是《Party in the U.S.A.》,吉他手弹的都是同一段solo。到了第四首歌,你已经感到疲惫,而且不止一点愤怒。
这就是阅读未经加工的AI写作的体验。最开始读到的几篇,没有什么是让你警报大作的——只是工整,虽然有点无聊。然后你不断看到同样的套路:三段式排比、“不是X,而是Y”、段落末尾悬挂的短句——它存在的唯一意义就是告诉你,你刚刚读到的内容“很重要”。最终,你不再吸收文字试图传达的信息。
我之前说过,主流实验室在写作上的模型进展似乎已经停滞。也许没有一个模型能同时满足所有人的需求,又或者OpenAI、Anthropic和Google在编码领域有更大、更赚钱的机会。一方面,这倒也说得过去。但作为一个彻底拥抱AI的写作者,我忍不住觉得自己有点被落下了。这让我想起高中时,AP英语论文的截止日期在我写完后又推迟了,因为显然,AP物理考试更重要。
所以当我听说有一个专注于写作的新模型时,我立刻把它排进了Vibe Check的评测名单。
Deft是什么?
Deft是一个新的研究实验室,同时也是一个专注“更好的写作”的模型。实验室由Justin Murphy(前政治学教授,后来转型为写作者和出版人)和一位名叫Rosmine的AI研究员共同创立。它的首个发布版本DFT v1是一个写作模型,使用了实验室自定义的微调方法进行后训练。DFT v1最初于6月发布,上周进入公开测试阶段。
Deft团队对AI写作为何会变成这样有一个理论:LLM有分布问题。这里说的不是文章有没有被读者阅读——它们确实被阅读了,虽然不总是让人愉快。Deft关心的是词语本身的分布:哪些短语反复出现,句子倾向于如何开头和结尾,以及大量输出是否最终坍缩到同样的几个套路。该公司的赌注是:如果你训练一个模型去匹配人类写作在一个文档批次上的分布——而不仅仅是让每个单独回答可被接受——你就能得到更有变化幅度的文章。
驱动Deft方法的核心是“分布微调”(distribution fine-tuning),简称DFT,这是一个在模型学会预测语言之后执行的后训练步骤。传统微调一次只评判一个回答,也就是说,1000个回答可以每一个都通过审查,但聚合起来看,它们却在重复同样的开头和节奏。DFT则是把一批模型输出与一批人类写作样本进行比较,当两者的分布出现差异时就调整模型。
由此产生的模型就是DFT v1。在Deft自己的测试中,它产出的写作分布比同等规模的常规微调更接近人类样本。它的基本主张是:改变后训练方式,就能得到更多样的文风。
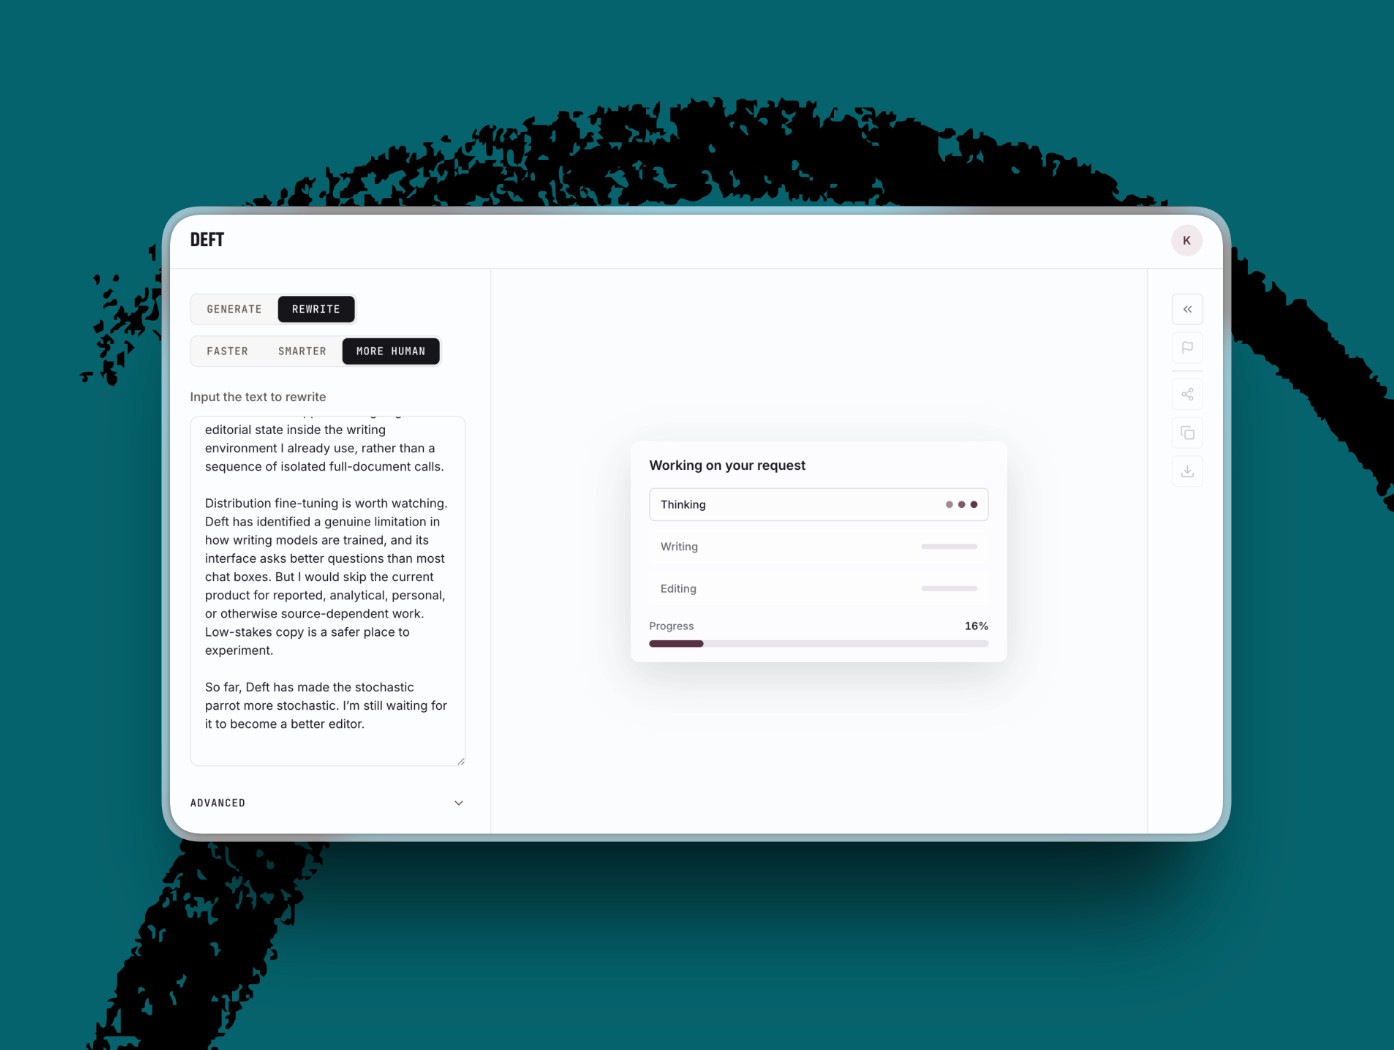
目前,这个模型通过Deft的网站和付费API提供。你提供一个提示词,选择希望模型更快、更聪明还是“更像人”,再从四种输出格式中选择一种:新闻文章、分析型文章、SEO文章或公司博客。高级控制选项允许你描述自己的写作风格,或者粘贴一段示例让模型模仿。设置中还有一个选项,可以在“严格”模式和“创意”模式之间选择。严格模式承诺“只使用你提示词中的细节”;创意模式则可以虚构支撑性的具体内容。
Deft写得到底怎么样?
为了测试这个模型,我让Deft写了一篇分析型文章,主题是AI如何影响就业,还写了一篇SEO文章,主题是如何编写AI风格指南。我让它完全从头起草,也让它重写了一份已有的草稿——那份草稿是我用GPT-5.6 Sol为同一个任务生成的。我还同时通过网络控制台和API来使用它。
在句子层面,Deft的文章比我读过的多数AI写作更有变化,也更出人意料。但它也很密集、难以解析,排序欠佳。Deft的网页界面提供了一个阅读分数,它给自己的输出打了11年级阅读水平。【补充:根据国家素养研究所的数据,54%的美国成年人阅读水平在六年级或以下。】那篇SEO文章的开头给了我一些混乱的短语,例如“一组同义词的词汇选择”“伟大例子的例子”“每一篇文章都要记住这些,对每个写作者来说都很多”。这些短语确实不同寻常,但并不清楚。
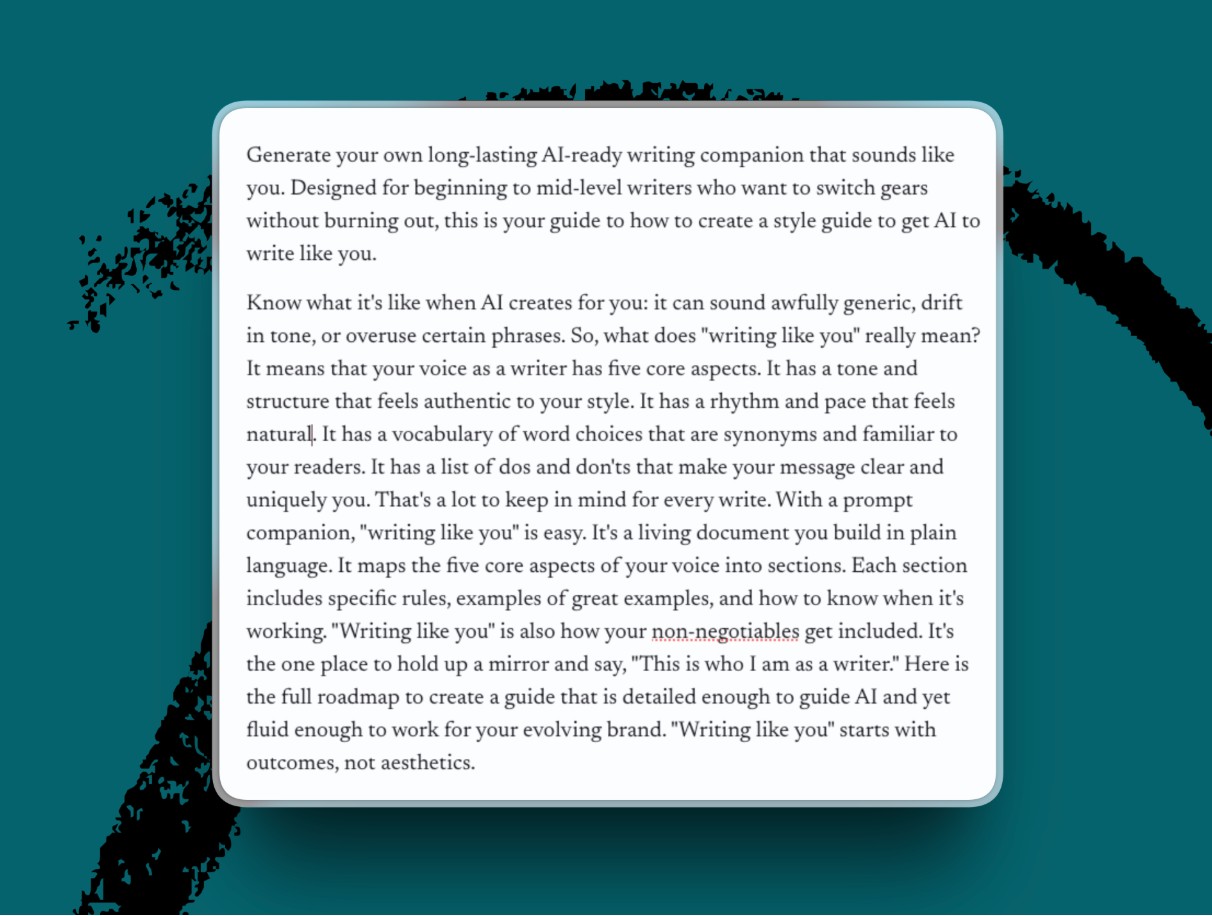
对于分析型文章,我设置了严格模式,并给它一份包含主要观点和来源的详细简报。Deft在草稿中引入了一个新观点,说工人会被管理者、工会或公司控股股东推向AI平台。这些细节都没有出现在我的简报里。
我想看看Deft在我日常写作环境中会不会表现更好,于是把它的API接入了Codex。我发现这个API的能力相当有限,至少目前如此。API并不会让你访问模型本身,而是让你从另一个平台把任务发送给Deft,让它在Deft系统内部完成后再发送回来。换句话说,你得到的仍然是整块整块的成文,而不是和模型协作决定一篇作品如何成型。
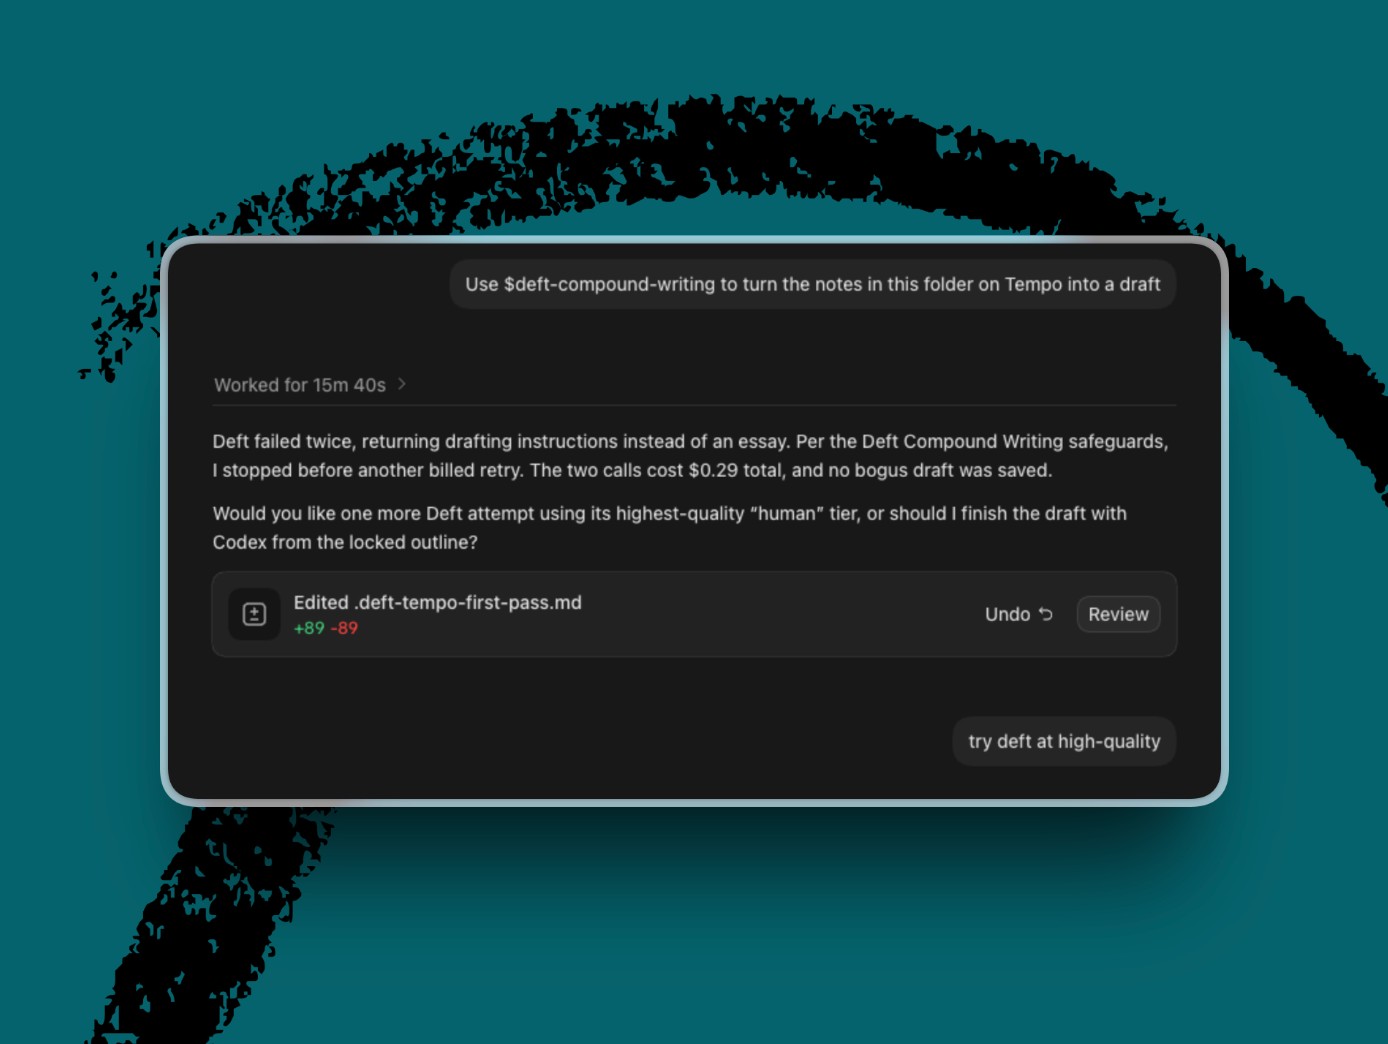
我让Codex整理简报,包括大纲和我的风格规则,然后通过API把这个包裹发送给Deft。前两次尝试返回的是写作指导,而不是文章本身。第三次,我用了Deft的最高质量设置。它写了半篇就停下来,并且编造了来源中没有的日期、对话、产品历史、截图、行为和情绪——尽管我设置的是严格模式。我付了0.49美元,却没有得到任何可用的草稿。
Deft还缺什么
Deft已经证明,它能写出比多数模型更不可预测的文字。但它还没有证明的是,它能写出“更好”的文字。像GPT-5.6 Sol或Sonnet 5这样的模型写出来的内容可能有“AI味”,但到了这一步,那些标志性的特征已经足够可预测,我知道怎么识别,也知道怎么拆解。而DFT v1的文章,编辑工作量也差不多——只是更不清楚该从哪里开始。
这个模型需要更好地把握信息层级、内容排序,以及对读者心智的建模。一篇有力的草稿不只是变换句法。好的写作会引导注意力。它知道什么时候一个术语需要解释,什么时候证据需要背景,以及如何组织信息才能让读者愿意靠近。Deft在做这些决定时,常常像是在句子层面上进行局部决策,对整篇文章没有一个稳定的整体模型。
我还希望能和模型进行迭代。Deft的定位是整篇文档生成,但我的写作过程很少从简报一步跳到成稿。我想和模型反复来回,保留它输出的某些部分,再改写其他部分,并调动我搭建的整套工具,让模型写出更像我的文字。
严格模式也需要名副其实。我需要明确的来源规则、能持续生效的指令,以及一种能区分“模型必须保留的事实”和“模型有权发展的可能性”的方式。Deft已经提供了API。我希望它能嵌入我的复合写作工作流。我应该能说:“把这个论断原样保留、把就业部分上移、只改写过渡段”,而Deft不会返回一篇全新的文章。
更随机,只是一个开始
五年前,研究人员Emily M. Bender、Timnit Gebru、Agnelina McMillan-Major和“Schmargaret Schmitchell”提出了“随机鹦鹉”(stochastic parrot)这个术语来描述LLM——“随机”是因为语言模型基于概率生成文本,“鹦鹉”是因为它们能模仿语言形式,却不知道词语的含义。即使在今天,LLM产出的文本仍然不是建立在交际意图、世界观模型或读者模型的基础上。
Deft介入的,正是这个隐喻中“随机”的那一半。DFT改变了模型在一批输出中会去选择的模式分布,给了这只鹦鹉更广阔的曲目库;结果仍然是概率性的,只是那些模式出现的概率变低了。DFT的文字听起来可能更出人意料,但根据我的实测,仅靠多样性并不能治愈AI写作的积弊。
Deft是一个颇有前景的示范:AI文章的雷同感可以被当作一个训练问题来处理。对于一个仍在实验模型上摸索的全新实验室来说,提取出技术栈中一个可处理的层面,是一个相当不错的开始。我自己还不会在日常工作中使用Deft,但我很好奇这个模型会走向何方,这个实验室接下来要解决什么问题,以及是否会有其他实验室跟进。
披露声明:我们通过Deft的公开网站和付费API进行了测试。Deft没有参与这篇评测的撰写。
核心启示:Deft通过“分布微调”让AI写作的措辞分布更接近人类,但作者实测发现,仅靠风格多样性并不能解决AI写作在信息层级、排序、读者心智和严格遵循来源上的根本问题。
I Tried the AI Model Built to Fix AI Writing 的发芽报告
材料核心
Katie Parrott 上手测试了主打"分布微调"(DFT)的新写作模型 Deft:它确实让 AI 文字变得更多变、更难以预测,但也更密集、更难解析、更缺全局结构——即使开了"严格模式"也会编造事实,API 也无法支持真正的协作式编辑。她的结论是:"更多随机性只是开始"——把输出分布拉近到人类写作的分布,并不能修复 AI 写作在意图和结构上的根本缺陷。
发芽 01:曲库更广的鹦鹉,依然是鹦鹉
种子
文章表面上是模型评测,实际上做了一个更锋利的概念区分:AI 写作的"千篇一律感"究竟是统计问题,还是意图问题?Deft 赌的是前者——用分布微调把模型从"每篇都像同一篇"变成"整体上更像人类写作的分布"。但 Katie 的测试指向后者:那些"更意外"的句子,读起来依然不像一个知道自己在说什么、说给谁听的人写的。
故事主体
文章的锚点是 2021 年 Emily M. Bender、Timnit Gebru、Angelina McMillan-Major 与 "Schmargaret Schmitchell" 在 FAccT 会议上提出的"随机鹦鹉"(stochastic parrot):LLM 是"随机的",因为每个词都从概率中采样;是"鹦鹉",因为可以模仿语言形态而不理解意义。Deft 只干预了"随机"那一半——它给了鹦鹉更大的曲库,但 Katie 四次实测中反复出现的"局部漂亮、整体迷路",恰好暴露了"鹦鹉"那一半原封未动。
为什么分布再广也不够?H. P. Grice 在 1967 年哈佛大学的 William James 讲座上提出"合作原则"(后收入《Logic and Conversation》):人类对话之所以成立,是因为说话者在持续预判听者的推理——何时需要解释术语,何时该补背景,哪些信息可以省略,哪些必须展开;听者也默认对方在配合自己的理解过程。所以人类写作的句子分布,并不是一个静态的统计形状,而是一连串"猜测读者心思"的决策痕迹的副产品。LLM 学到的只是副产品,而不是产生副产品的那个意图系统。Deft 生成的 "a vocabulary of word choices that are synonyms" 这类句子,在分布上合法,在交际上失败——它是曲库变大之后,仍然不知道自己在对谁唱歌的鹦鹉。
Aha 瞬间
"Deft 治好了'随机鹦鹉'里的'随机',却没有治好'鹦鹉'——分布只是文字燃烧后留下的灰烬,意图才是那堆火;把灰烬摆放得更像人类的灰烬,并不能让它重新燃烧。"
发芽 02:群体智慧能猜中牛的体重,但写作没有"牛的体重"
种子
Deft 的理论前提藏着一个未被质问的假设:人类写作的分布,值得被当作训练的参照系。但"人类写作的分布"并不等于"好写作的分布",甚至不等于"读者能够消化的分布"。Katie 指出的一个数据点让这个问题变得尖锐:Deft 给自己的输出打了 11 年级的阅读难度分数,而 54% 的美国成年人阅读水平在六年级及以下。它对齐的是作者侧的分布,不是读者侧的分布。
故事主体
1906 年,统计学家弗朗西斯·高尔顿(Francis Galton)在普利茅斯牲畜展上做了一个著名实验:787 位观众猜测一头公牛的体重,所有人猜测的中位数(1207 磅)与公牛真实体重(1198 磅)几乎重合。这个例子后来成为"群体智慧"的经典:大量独立判断的平均值往往比单个专家更接近事实——因为"真实体重"是一个客观锚点,误差会互相抵消。
但写作不是猜体重。一篇文本的"好"没有独立于读者的客观答案;把大量文本平均起来,得到的只是"最常见的写法",而不是"最好的写法"。更麻烦的是,中位数右侧的文本可能来自学术化、密度失衡的写作文化——这正是 Deft 输出里 "examples of great examples" 和 "That's a lot to keep in mind for every write" 这类句子的来源:统计学上接近人类,修辞学上远离读者。Katie 还发现,即便设置 strict 模式,Deft 也会把"工人被经理、工会或公司大股东推上 AI 平台"这样的新细节塞进文章——它拟合了"人类会补充细节"的行为,却没有能力判断细节是否为真、是否该出现。对齐平均,收获的只是平均;平均能告诉你大家通常怎么写,但不会告诉你怎样写才值得被读。
Aha 瞬间
"高尔顿的群体智慧能猜中牛的体重,是因为牛的体重客观存在;写作没有那样一头牛。当你把输出分布对齐到'人类平均',得到的不是范本,而是均质。"
发芽 03:文采(elocutio)不等于布局(dispositio)
种子
Katie 对 Deft 最核心的诊断是:它"在局部、逐句地做决定,缺乏对整篇作品的稳定模型"。这听起来像是当下 AI 技术问题的描述,实际上是一个古老问题的当代版本。Deft 的分布微调优化的是"文采"——句子更多变、更像人类;它缺席的是"布局"——信息怎么排序、注意力怎么被引导、什么地方该解释、什么地方该推进。古罗马修辞学早就给了这一对概念名字:elocutio 与 dispositio。
故事主体
在西塞罗和昆体良的修辞体系中,一篇有力量的演讲要经过五个步骤:觅材(inventio)、布局(dispositio)、文采(elocutio)、记忆(memoria)、发表(pronuntiatio)。"文采"管的是措辞、句式、修辞格;"布局"管的是材料如何安排——开头在多长时间内抓住听众、证据按什么顺序出场、在哪一个节点让听众深吸一口气、在哪一个节点收束。昆体良在公元 95 年前后写成的《雄辩术原理》(Institutio Oratoria)中反复强调:演说者要想象听众此刻的状态——他们已经信服了吗?开始困惑了吗?还跟得上吗?换句话说,两千年前最优秀的修辞学家就知道:写作的内容不是句子,而是读者在句子里移动的路径。
Deft 恰恰缺了这条路径。它的句子按顺序排列,却没有一个全局的"注意力导演";每个房间都装修精致,但房间里没有门洞,也没有走廊。Katie 的结论——"好的初稿需要信息层级、序列与读者心智模型"——几乎可以原封不动地翻译进昆体良的课堂。分布微调让 AI 在"如何说"上取得进展,但"先说什么、后说什么、让读者带什么离开"是另一个维度,而那恰恰是 Deft 的下一代最需要补的课。
Aha 瞬间
"Deft 修好了 elocutio,却没有修好 dispositio——两千年前昆体良要求演讲者预判听众在哪里走神;两千年后,这个模型缺的仍然是同一张读者的心智地图。"
你的思考空间
- 如果 Deft 的训练目标不是"人类写作的分布",而是"优秀编辑认可的文本分布",它的输出会变得更好吗?还是只会变成另一种风格上的单一化?
- 文章说 Deft 干预的是"随机鹦鹉"的"随机"一半。你认为"鹦鹉"那一半(缺乏交际意图)能靠更好的训练目标解决,还是必须依赖模型底层架构的变化?
- 如果句子层面越来越难区分"人写的还是 AI 写的",编辑的核心竞争力会不会从"修改文字"转向"重构结构"?我们是否正在从 line editor 的时代走向 structural editor 的时代?
- "严格模式"在 Deft 中失效(编造了来源里没有的细节)——这是能力问题、产品设计问题,还是"告诉模型不要做什么"这件事本身固有的挑战?
- 分布上的多样性与质量上的可靠性,是否存在必然的 trade-off?如果可以牺牲一部分意外感,换取更稳定的信息层级和读者引导,你愿意交换吗?